大模型Post-Training
- 简介
- 演进
- PPO(Proximal Policy Optimization)
- Group Relative Policy Optimization(群体相对策略优化)
- GSPO
- 长短程任务:GRPO 与 PPO 的天平
- OPD/On-Policy Distillation
- LLM 的训练流程
- 汇总
- SFT→RL→OPD:LLM后训练的本质
- 案例
- 常见技术
- 工程
- 数据准备
- 小结
简介
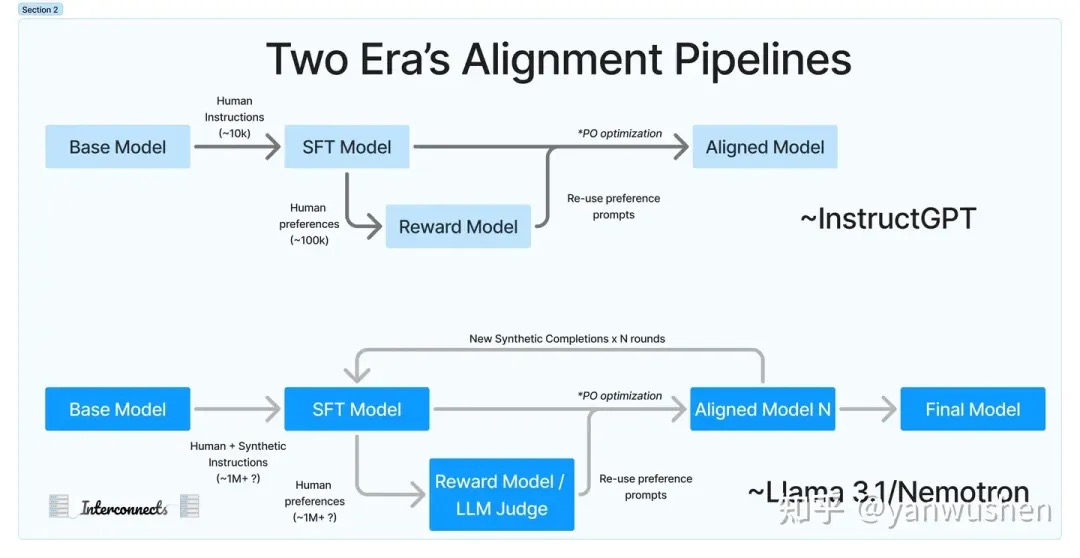
关于post-training和一些思考在GPT刚问世的时候,业界对于RLHF的作用还存在质疑。许多公司发现,仅仅使用SFT就足以满足他们的需求。甚至在Meta内部,对于是否应该使用RL技术也存在分歧。但是随着DPO等算法的推出,以及开源社区更多经验的分享,业界逐渐接受了RLHF这一训练环节的重要性。学术界提出了各种XPO方法,而工业界也提出了多种PPO的替代算法。逐渐认识到RLHF的价值:RLHF能够在各种评测榜单中显著提高模型分数(刷分利器),在定制化这块也很有前景,对聊天风格的转换这一点很重要,它使得OpenAI发布的mini小模型都能在Arena中排前三,这一点也许正是国内大模型欠缺的。总结来说post-training的转变可以参照下图,可以明显的看出alignment阶段规模的扩大。
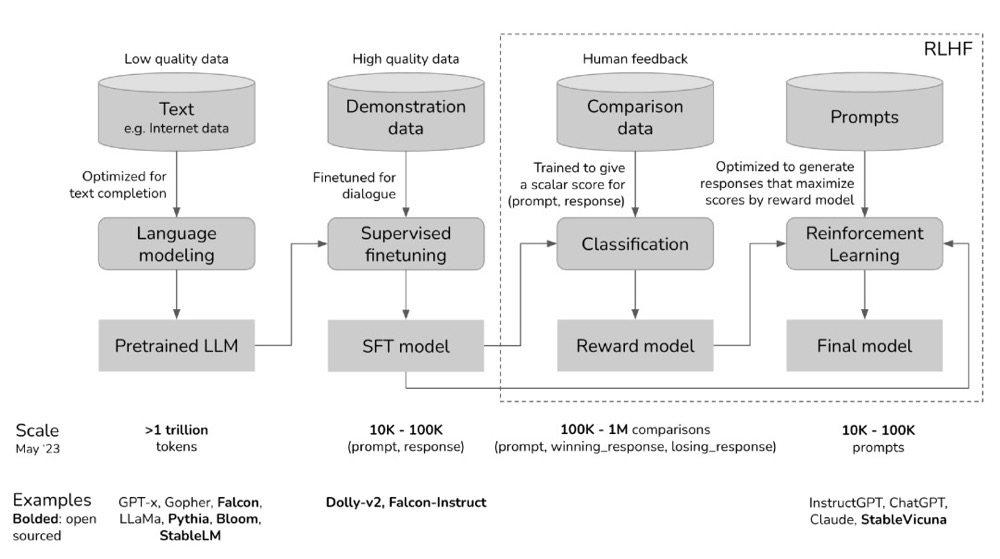
- 预训练模型是一个未加控制的“怪物”,因为其训练数据来源于对互联网内容的无差别抓取,其中可能包括点击诱导、错误信息、政治煽动、阴谋论或针对特定人群的攻击等内容。
- 在使用高质量数据进行微调后,例如StackOverflow、Quora或人工标注,这个“怪物”在某种程度上变得可被社会接受。
- 然后通过RLHF进一步完善微调后的模型,使其更符合客户的需求,例如,给它一个笑脸。 你可以跳过这三个阶段中的任何一个阶段。例如,你可以直接在预训练模型的基础上进行RLHF,而不必经过SFT(Supervised Fine-Tuning,监督微调)阶段。然而,从实证的角度来看,将这三个步骤结合起来可以获得最佳性能。预训练是资源消耗最大的阶段。对于InstructGPT模型,预训练阶段占据了整体计算和数据资源的98%。可以将SFT和RLHF视为解锁预训练模型已经具备、但仅通过提示难以触及的能力。
解析大模型中的Scaling Law在大模型的研发中,通常会有下面一些需求:
- 计划训练一个10B的模型,想知道至少需要多大的数据?
- 收集到了1T的数据,想知道能训练一个多大的模型?
- 老板准备1个月后开发布会,能用的资源是100张A100,那应该用多少数据训一个多大模型最终效果最好?
- 老板对现在10B的模型不满意,想知道扩大到100B模型的效果能提升到多少?
从 PPO 到 GRPO,RL 算法(也算是一种Optimizer)基于奖励信号更新策略模型参数,平衡“性能提升”与“策略稳定性”。
演进
在线学习,离线学习两种微调方法在数学上是等价的,它们理想的训练终点都是达到最大似然拟合。在线强化学习(两阶段训练 RM, RL), 明显好于离线学习(DPO,SFT,IPO)。在线强化学习更有效的原因是由于,验证模型与生成模型的不对称性。也可以说是对于验证容易问题, 验证模型能提供有效的反馈信号, 让模型更有效的学习。
如何理解 LLM 中的 RL 算法? 非常经典,值得细读。好的文章越读越清晰、收敛。 ybq:我不在乎算法是 sft 或 rlhf,也不纠结监督学习和强化学习在理论上有何本质区别。我只关心,哪种 loss 能让模型达到更好的效果。因此,“直接对模型上 ppo 算法就能起效果”这一结论对算法从业者来说完全不吃惊。sft 本就不是训 LLM 的必备环节,但如果说 sft 完全无用也属实是过激了,毕竟只看 loss 函数的话完全可以这么理解:sft 就是在每个 token 粒度都有一个 reward_model 的 ppo 算法。deepseek在技术报告里指出过,sft 和 rlhf 算法在 loss 函数的设计上没有本质区别。具体来说,deepseek 认为 post training 算法包括三要素:启动数据,reward function,token 粒度的 gradient coefficient。sft 的 Gradient Coefficient 是 1,ppo 的 Gradient Coefficient 是 Advantage。既然两种算法在 loss 函数上没有本质区别,他们的区别又体现在哪里呢?我个人的观点是:explore。rl鼓励模型去explore。
- sft是数据质量不足(或者不可判别任务)下的一种妥协。如果有质量很高的rule reward数据,那其实做rlhf更好一点。 PS: SFT有类似ground truth,而rl 只是给出多个采样结果的好坏,但都是转为loss。
- sft 的训练过程,是每个 token 都有一个明确的 target 存在的,其优化目标很纯粹,增大这个 target 的概率。但 rl 不同,每个 token 的 reward 是由整个句子的 reward 回传回来的(带上 value function 的预测),试想一个句子“中国的首都不是南京,是北京”,因为太过啰嗦被打上了一个较低的 reward,那问题是“是南京”这三个 token 做错了什么,在上个 token 的回答是“不”的情况下,这三个 token 已经是当下最优的 token 了。此时,如果 value function 能救回来还好,但显然不太容易。这里注意,传统的 rl,每一个 action 是能有一个及时回报的,但 rlhf 算法中是没有的,它只有折扣累积回报(rlhf 中,每个 action 的及时回报,要么被设置成 0,要么被设置成 kl_penalty),这也进一步导致了 token 级别 reward 的不准确。就这,还都是建立在整个 response 的 reward 打分准确的基础上,打不准就更头大了。如何给每个 token 一个正确的打分,那就是 ppo / grpo / rloo 等算法各自的努力方向了,它们的出发点和实现方式各不相同,甚至对 KL_penalty 施加的位置都不同,有的放进 reward 中,有的放进 advantage 中。熟优熟劣,就要靠各位的实验结论和理论推导了,我暂时没有结论。其实就是想说因为 label 不准, rl 天生比 sft 不太好训练,因此才需要那么多的调参工作。再次提醒,不管什么算法,你只要把 reference_model 的 KL_penalty 开得足够大,都会稳如泰山。
- reward hacking 其实就是模型以训练者不期望的方式找到了提高 reward 的方法。我们想要的是模型按照某种方法提高 reward,但我们设计的 reward 函数却只在乎 reward,而不在乎“按照某种方法”,那么自然而然的就会不符合预期。万变不离其宗,有多少人工就有多少智能。sft 要时刻留意数据质量,rlhf 则是要时刻留意 reward 的打分是否准确或者说是 reward 的设计是否合理,后者一点都不比洗数据轻松。
RLHF 是一个完整技术框架,PPO 仅仅是其中强化学习算法模块的一种实现方式。人类反馈构造出偏好对齐数据集以便训练RM,正因为有了RM,才能让强化学习有了发挥的空间,让sft后的模型有了进一步的提升。但偏好对齐一定需要RL嘛?偏好对齐一定需要人类反馈吗?偏好对齐一定需要训练RM嘛?偏好对齐一定需要大量偏好样本么?
系统梳理LLM+RLHF发展脉络 非常经典,建议细读。 chatgpt所用的RLHF流程,首先BT模型的假设来训练Reward model。BT模型假设可以对每个query-response对(x,y)单独打分,即可以采用point-wise形式的reward来表述一个(x,y)的好坏。然后我们就可以基于该假设,训练出为每个query-response对(x,y)打分的reward model了。在获得reward model后,为了避免RL算法过度优化reward model所学习的偏好,从而使LLM出现“胡言乱语”的表现,通常会在优化目标中加入对原有策略的KL惩罚,这样我们就得到了最初的优化目标(Optimization Gaol)了。对于response层级的reward,最终,我们会将其转成token-level的累积reward。
如何用一个统一的视角,分析RLHF下的各种算法? PS:大佬们一直在试图寻找统一脉络。思路一般不是突变的。
系统梳理LLM+RLHF发展脉络 未细读。
PPO(Proximal Policy Optimization)
PPO & GRPO 可视化介绍PPO(proximal policy optimization),包含三部分:
- Policy: 已预先训练/SFT 的 LLM;
- Reward model:一个经过训练和冻结的网络,在对提示做出完全响应的情况下提供标量奖励;
- Critic:也称为值函数,它是一个可学习的网络,它接受对提示的部分响应并预测标量奖励。比如有些步骤很重要,那么score就很高。对于一些既定好的工作流肯定是适用的,但是LLM如果要思考不定长步骤,那么这个模型并不好定义,更不好训练。
具体工作流程:
- Generate responses: LLM 为给定的prompt生成多个response;
- Score responses: reward model 给每个 response 分配 reward;
- Compute advantages: 使用 GAE 计算 advantages (it’s used for training the LLM);
- Optimise policy: 通过优化总目标来更新 LLM;
- Update critic: 训练 value function以更好地预测给定部分响应的奖励。
General Advantage Estimation (GAE) Our policy is updated to optimise advantage,直观解释,它定义了一个特定的动作$a_t$与policy 在状态$s_t$决定采取的average action相比 “how much better”。 \(A_t = Q(s_t,a_t)-V(s_t)\) 估计这种Advantage有两种主要方法,每种方法各有优劣:
- Monte-Carlo (MC):使用reward of the full trajectory(完整轨迹的奖励)(即完整响应)。由于奖励稀疏,这种方法具有很高的方差——从 LLM 中获取足够的样本来使用 MC 进行优化是昂贵的,但它确实具有低偏差,因为我们可以准确地对奖励进行建模;
- Temporal difference (TD):使用 one-step trajectory reward(一步轨迹奖励)(即根据提示测量刚刚生成的单词有多好)。通过这样做,我们可以在token级别上计算奖励,这大大降低了方差,但与此同时,偏差也会增加,因为我们无法准确地预测部分生成的响应的最终奖励。
如果响应不完整,奖励模型将返回 0(只有对于 LLM 的完整响应,奖励模型才会返回非零标量分数),在不知道奖励在生成单词之前和之后会如何变化的情况下,我们将如何计算 TD?因此,我们引入了一个模型来做到这一点,我们称之为 “the critic”。The critic 受过训练(critic在训练中对奖励模型的分数进行了简单的 L2 损失),可以预期仅给出部分状态的最终奖励,以便我们可以计算 TD。虽然奖励模型R在 PPO 之前进行了训练并被冻结,尽管R的工作只是预测奖励,但 critic 与 LLM 一起进行了训练。这是因为 value 函数必须估计给定当前策略的部分响应的奖励;因此,它必须与 LLM 一起更新,以避免其预测过时和不一致。这就是actor-critic in RL。通过critic V,我们现在有办法预测部分状态的奖励。
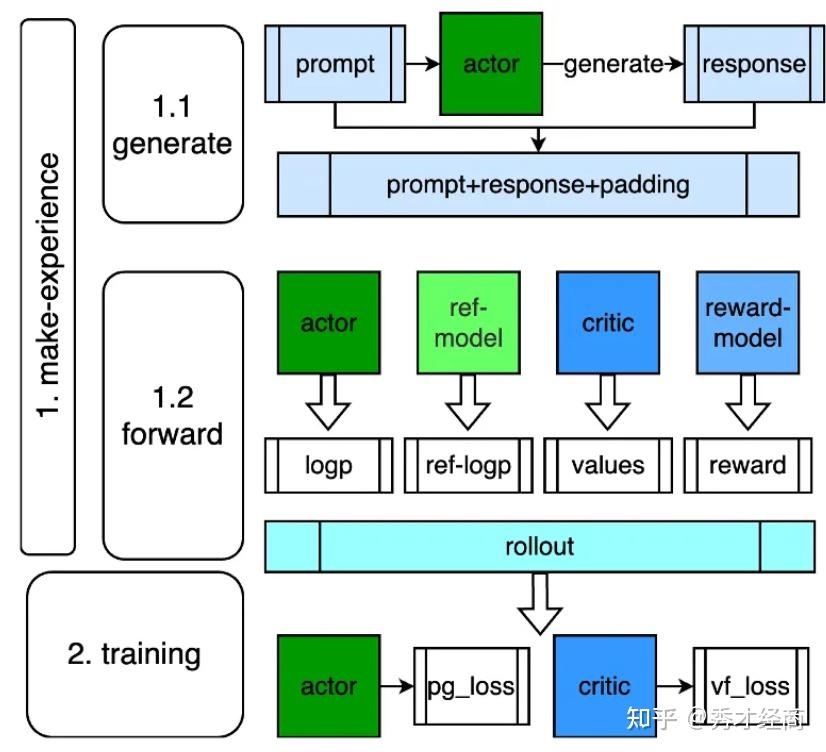
使用PPO优化pipeline,有几个明显挑战,比如需要在学习过程中启动4个模型:actor model,reference model,reward model,critic model。如果为了提升训练效率,还可额外部署infer model。在游戏、机器人等领域,这几个模型通常size都比较小,为了效果多部署几个模型可以接受。但在LLM领域中,为了效果导致模型size剧增,同时也需要更为复杂的调度方式,总体来说,PPO优化pipeline对资源使用和调度带来了不小挑战。
人人都能看懂的RL-PPO理论知识 未读,建议细读。
拆解大语言模型RLHF中的PPO 先用一段伪代码把大语言模型RLHF中的PPO 三部分采样、反馈和学习的关系简要说明一下
policy_model = load_model()
for k in range(20000):
    # 采样(生成答案)
    prompts = sample_prompt()
    data = respond(policy_model, prompts)
    # 反馈(计算奖励)
    rewards = reward_func(reward_model, data)
    # 学习(更新参数)
    for epoch in range(4):
        policy_model = train(policy_model, prompts, data, rewards)
明确一个概念——策略(policy,有点地方叫actor,就是我们想要训练出来的大模型),它就是RLHF中的“学生”。policy由两个模型组成,一个叫做演员模型(Actor),另一个叫做评论家模型(Critic)。它们就像是学生大脑中的两种意识,一个负责决策,一个负责总结得失。评论家/Critic就是将演员/Actor模型的倒数第二层连接到一个新的全连接层上。除了这个全连接层之外,演员和评论家的参数都是共享的
policy_model = load_model()
ref_policy_model = policy_model.copy()

for k in range(20000):
    # 采样
    prompts = sample_prompt()
    responses, old_log_probs, old_values = respond(policy_model, prompts)

    # 反馈
    scores = reward_model(prompts, responses)
    ref_log_probs, _ = analyze_responses(ref_policy_model, prompts, responses)
    rewards = reward_func(scores, old_log_probs, ref_log_probs)

    # 学习
    advantages = advantage_func(rewards, old_values)
    for epoch in range(4):
        log_probs, values = analyze_responses(policy_model, prompts, responses)
        actor_loss = actor_loss_func(advantages, old_log_probs, log_probs)
        critic_loss = critic_loss_func(rewards, values)
        loss = actor_loss + 0.1 * critic_loss
        train(loss, policy_model.parameters())
PS:actor model根据prompt 产生response,reward model 根据(prompt, response)得出reward score,简单情况下,我们根据loss=loss_func(score) 得到loss 就可以更新actor model了。但是考虑到,actor model 不合适偏差ref model太远,所以引入actor_loss,loss=loss_func(score,actor_loss)。又是基于啥考虑引入critic_model 和critic_loss 呢?
算法的一些缺点也越来越被注意到:
- PPO需要四个模型协同训练(policy、critic、ref、reward),显存耗费比较大。PS:GRPO 移除了critic,找了一个新的策略替代critic
- PPO在训练过程是policy-critic的交叉更新,容易导致训练过程的不稳定
DPO(Direct Preference Optimization)
在训练奖励模型RM的过程中,我们就已经在考虑“什么回答是好的,什么回答是不好的”这个问题了。而对齐模型依然是在考虑这个问题。所以,我们能不能避开奖励模型的训练,直接一步到位训练对齐模型呢?
- RLHF算法包含奖励模型(reward model)和策略模型(policy model,也称为演员模型,actor model),基于偏好数据以及强化学习不断迭代优化策略模型的过程。RLHF常使用PPO作为基础算法,整体流程包含了4个模型,且通常训练过程中需要针对训练的actor model进行采样,因此训练起来,稳定性、效率、效果不易控制。
- 在实际rlhf-ppo的训练中,存在【显存占据大】、【超参多】、【模型训练不稳定】等一系列问题。所以,在考虑“一步到位训练对齐模型”的过程中,我们是不是也能顺手做到绕过强化学习,采用一个更简单的方式(比如类似于sft)来使用偏好数据训练对齐模型呢?
- DPO算法不包含奖励模型和强化学习过程,通过对成对偏好数据直接优化模型,无需在微调时从模型采样生成数据,因此整个训练过程简单、高效,主要的改进之处体现在于损失函数。DPO算法仅包含RLHF中的两个模型,即演员模型(actor model)以及参考(reference model),且训练过程中不需要进行数据采样。DPO算法的目的是最大化奖励模型(此处的奖励模型即为训练的策略),使得奖励模型对chosen和rejected数据的差值最大,进而学到人类偏好。
偏好数据,可以表示为三元组(提示语prompt, 良好回答chosen, 一般回答rejected)。
Self-Play RL(细节移步其它文章)
OpenAI-O1之下,我们技术该何去何从o1 则再次证明了强化学习的重要性。dpo 是我这种没有强化基础的老 nlp 从业者的一块遮羞布,o1 则完全撕下了这张遮羞布。不学强化,不训 reward_model 是吧,那就抱着 sft / dpo 这些老古董一辈子技术落后别人吧。
GRPO(Group Relative Policy Optimization)
GRPO 是一种在线训练策略模型的方法。 训练方式是:对同一个 prompt 一次生成多个回答,把这些回答放在同一组里打分,并比较:这个回答在同组里是否高于平均水平? 最后更新策略时仍然使用 PPO-style 的 ratio + clip,避免新策略离旧策略太远。
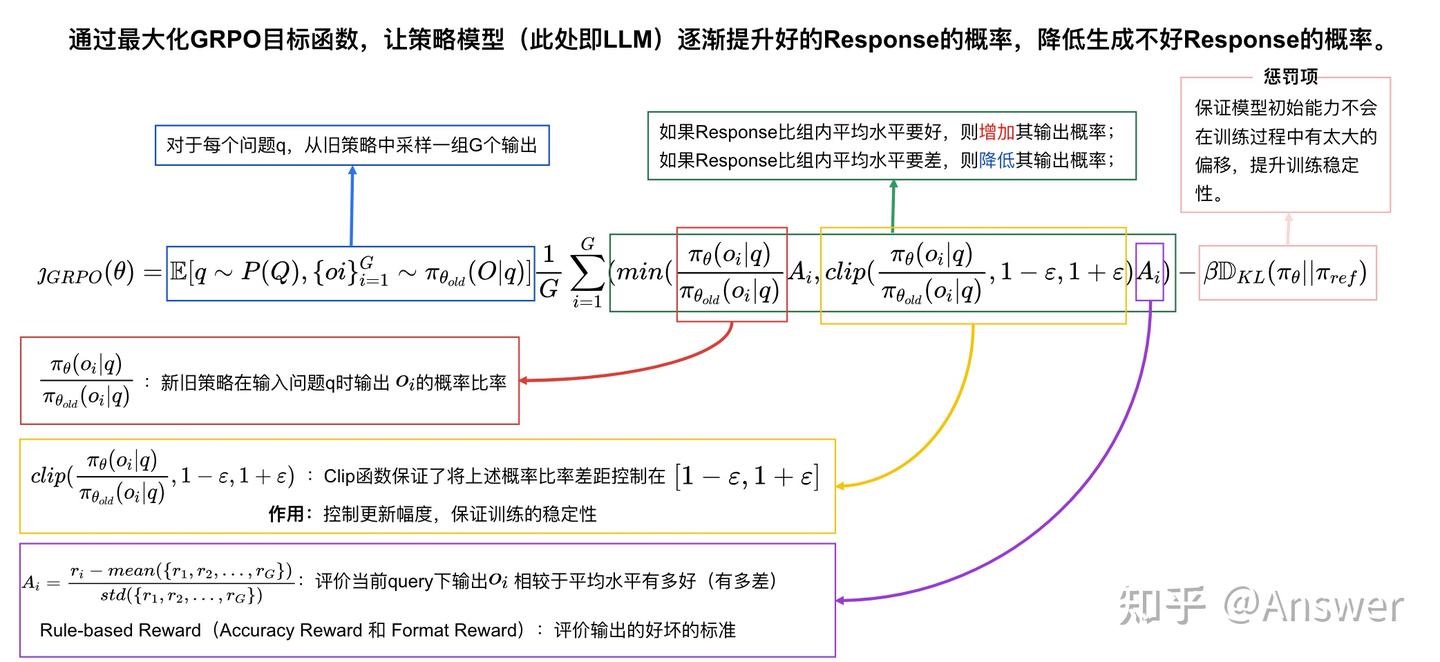
DeepSeek-R1 核心强化学习算法 GRPO 详解 PS:base llm对一个prompt 生成batch 个结果(O1,O2,…),基于规则(而不是reward)打分,如果某个Ox 比batch平均分高,则增加其输出概率,否则降低其输出概率。
- GRPO 对 PPO 的改进,其动机是 PPO 需要 4 个大模型,即策略、价值函数、奖励模型和参考模型。GRPO 消除了对价值模型的需求。为此,它首先为每个查询生成多个响应。然后,在计算advatage时,它将 value 函数替换为样本的奖励,该奖励由同一查询的所有响应的 mean 和 std 标准化。此外,它还将 KL 惩罚移动到损失函数中(RLHF 通常将 KL 惩罚添加到奖励中),从而简化了优势的计算。
- DPO会整体计算并优化某个response,无法发现具体错误并针对单个step进行独立优化
- 基于相对优势:GRPO 算法关注的是组内样本之间的相对优势,而非绝对的奖励值。在一个批次的样本中,它通过比较不同样本的奖励来确定每个样本的相对优劣,以此作为优化策略的依据。这种相对优势的计算可以减少奖励函数的偏差和方差,使训练更加稳定。
大模型Agent RL训练多轮planning技术 简要的梳理一下RLHF算法:
- PPO :把生成的每个token当成一个”action”,对模型的每个输出进行监督,这个过程使用的是value model/critic model完成的,loss上加上了裁剪机制限制策略的更新幅度,避免模型”学偏”.
- GRPO :GRPO是PPO的改进版,不依赖于value network,通过生成同一个样本的多个输出,然后计算每个输出的奖励与组内平均奖励的差值,然后使用KL散度来约束模型与reference model的偏离程度。
- REINFORCE++ : 在基础的REINFORCE基础上增加”历史基线”机制,比如用过去多个batch的average reward作为当前的基线,避免单一的batch的波动的影响。 GRPO跟PPO的区别就是advantage(降低方差用的)是sampling过程产生的样本的reward,求均值,方差得到的, 因为跟ppo差别很小,所以在开源的代码在实现ppo的时候,顺带GRPO就实现了,GRPO虽然只需要rule-based reward,但是你需要根据经验设计这个reward,对于喜欢调参的人员当然是好事,对于想偷懒的人士就不太友好.
rl的初衷是最大化(轨迹)累积回报。朴素策略梯度可以把同一条轨迹的 return 用到所有 action 上;actor-critic 再通过 Critic / GAE 估计更细粒度的 $A_t$。PPO 使用 clipped surrogate objective 限制有利方向上的过度更新;GRPO 使用 group 内的归一化奖励差异作为整条 response 共享的 Advantage。GSPO 不是把 Advantage 细化到 token,而是把重要性比率、clip 和优化粒度从 token-level 提升到 sequence-level。
PPO(Proximal Policy Optimization)
在 LLM 应用环境中,我们应用 PPO 算法,是把 LLM 当成智能体,但什么是环境呢?似乎不像下围棋、玩游戏这种传统 RL 场景中那样容易定义,奖励从何而来呢?那我们就训练一个 RM 来充当这样角色(RM 扮演的是「环境」),它最主要的目标就是给 LLM 这个智能体以外部的 「奖励信号」,这个奖励代表了 LLM 的决策(输出响应)有多符合人类的期望或偏好。PS: PPO 需要 Reward 来训练 Critic。
为什么ppo算法中引入critic model可以降低方差?经典的蒙特卡洛策略梯度算法,例如REINFORCE,通过直接优化参数化策略进行学习,但其核心缺陷在于梯度估计的高方差。这种高方差主要源于其对完整样本轨迹回报的依赖,导致策略更新过程不稳定且收敛效率低下。为解决这一关键问题,PPO算法引入了Critic(评论家)模型作为一项核心改进。Critic通过学习状态价值函数充当一个动态的基线(baseline),其目标正是显著降低策略梯度估计的方差,从而提升学习的稳定性和效率。
- 什么是高方差?为什么它是个问题?想象一下,你正在努力学习如何投篮。如果你仅仅根据多轮投篮后整场比赛的输赢(类似于 RL 中的蒙特卡洛回报)来判断,那么你对每一次投篮的反馈就会非常嘈杂。也许你投出了一个好球,但你的队伍由于其他因素仍然输了比赛。或者,也许一个运气球进了,尽管你的姿势并不好。这与像 REINFORCE 这样的基本策略梯度方法中发生的情况类似。它们基于在整个回合(episode)中累积的总奖励来估计动作的“好坏”。即使动作或环境的随机性只有微小的变化,这些奖励也可能会剧烈波动。反馈(梯度估计)中的这种高方差意味着:
- 不稳定的更新: 策略可能会在每次更新时被随机地推向不同的方向。
- 缓慢的收敛: 从嘈杂的信号中辨别出动作的真实、潜在质量需要很长时间。
- Critic 登场:理性的声音。评估 Actor 所采取的动作,或者更常见地,它估计一个特定状态有多好。它学习一个价值函数,通常是状态价值函数 $V(s)$,表示智能体从状态 $s$开始并遵循当前策略可以获得的预期未来总奖励。这个由 Critic 学到的 $V(s)$充当了一个智能的基线 (baseline)。
公式
PPO 不仅仅着眼于原始的、嘈杂的回报$G_t$(从时间$t$开始的折扣奖励之和),而是利用 Critic 的基线来计算所谓的优势函数 (Advantage function) $A(s_t,a_t)$。Critic 的任务就是预测:从当前这个前缀(在语言模型的上下文中,$s_t$可以理解为prompt + partial response)出发,最终能获得多少 reward?$A(s_t,a_t)$其核心思想是确定在状态$s_t$下采取动作$a_t$比该状态下的平均预期要好多少。
有了 $V(s)$ 之后,就可以计算 优势函数(Advantage Function): \(A(s,a) = Q(s,a) - V(s)\)
其中 $Q(s,a)$ 是“在状态 $s$ 下采取 action $a$ 后的期望累积奖励”。但在实践中,我们并不直接估计 $Q$,而是用蒙特卡洛回报(Monte Carlo Return) 来近似: \(R_t = \sum_{k=t}^T \gamma^{k-t} r_k\)
但由于 RM 只在 $T$ 时刻给出一个 scalar reward(设为 $r_T$,中间 $r_t = 0$),所以: \(R_t = \gamma^{T-t} r_T\)
于是优势函数简化为: \(A_t = R_t - V(s_t) = \gamma^{T-t} r_T - V(s_t)\) PS:不直接用rm($r_T$),也不直接用critic($ V(s_t)$),而结合在一起算$A_t$。
这个 $A_t$ 就是我们用来更新 policy 的核心信号。它衡量的是:“在 $t$ 时刻采取当前 action,比平均水平好多少?”——这就是 token-level 的训练信号。
然后,PPO(以及一般的 Actor-Critic 方法)中的策略梯度更新使用这个优势:鼓励 Actor 采取导致正优势的动作,而不鼓励采取导致负优势的动作。
方差降低背后的数学原理。策略梯度定理允许我们将预期总奖励$J(\theta)$关于策略参数 $\theta$的梯度写为:
\[\nabla_{\theta}J(\theta) = \mathbb{E}_{\tau \sim \pi_{\theta}} [ \sum_{t=0}^{T-1} \psi_t \nabla_{\theta} \log \pi_{\theta}(a_t | s_t) ]\]在这里,$ \psi_t$ 是衡量在状态 $ s_t $ 下动作 $ a_t $“好坏” 的某种指标。在 REINFORCE 中,$\psi_t = G_t $(从时间 $t$ 开始的回报)。在像 PPO 这样的 Actor-Critic 方法中,$\psi_t = A(s_t, a_t) \approx G_t - V(s_t)$
直观理解:为什么减去基线有效?把它想象成按曲线给考试评分。教授不仅仅看你的原始分数$G_t$,还会考虑班级在该难度考试中的平均分$ V(s_t)$。你的“优势”就是你比平均水平好(或差)多少。这种相对衡量通常比原始分数更能稳定地反映你的理解程度,因为原始分数可能会受到考试异常简单或困难的影响。类似地,从 $G_t$中减去 $ V(s_t)$
- 中心化奖励: 如果智能体处于一个通常较好的状态($ V(s_t)$较高),即使是一个不错的动作也可能导致回报$G_t$ 很高,但不会远高于 $ V(s_t)$。优势 $A(s_t,a_t)$会很小,正确地表明该动作对于那个好状态来说只是“平均水平”,只有“超出预期”的 action 才会被强化。
- 减少状态价值方差的影响: 某些状态本质上比其他状态更有价值。通过减去状态的价值,我们将学习信号集中在动作本身的后果上,而不是状态的内在价值。如果一个好状态下的所有动作都会导致高回报,那么仅使用 $G_t$无法清楚地区分哪个动作是最佳的。优势函数有助于做出这种区分。 这使得学习信号(优势)的噪声更小,更专注于动作的相对质量,从而带来更稳定和高效的学习。
伪代码
# 初始:SFT后的模型,拷贝一份作为参考,不参与更新
model = SFT_model
ref_model = copy.deepcopy(SFT_model) # 用来计算KL散度,防止模型跑偏
value_model = Critic_model # 用来预测状态价值,辅助计算 advantage

for iteration in training:
    # --- 1. Rollout (采样阶段) ---
    with torch.no_grad():
        responses = model.generate(prompts)
        # 存下采样时的 logprob,作为基准
        logprob_old = model.logprob(prompts, responses)
        # 获取奖励(通常会减去与 ref_model 的 KL 惩罚)
        values = value_model(prompts, responses)
        rewards = reward_model(prompts, responses) - KL(logprob_old, ref_model.logprob(...))
        # 用 GAE 等算法计算优势
        advantages = compute_gae(rewards, values)

    # --- 2. PPO update (学习阶段) ---
    for epoch in range(K):
        # 注意:这里计算的是当前最新权重下的概率
        logprob_new = model.logprob(prompts, responses)

        # 计算重要性采样比率
        ratio = torch.exp(logprob_new - logprob_old)

        # PPO 核心:带截断的损失函数
        surr1 = ratio * advantages
        surr2 = torch.clamp(ratio, 1-eps, 1+eps) * advantages
        policy_loss = -torch.min(surr1, surr2).mean()

        # 更新参数:执行完这一步,model 就不再是产生 logprob_old 的那个模型了
        optimizer.zero_grad()
        policy_loss.backward()
        optimizer.step()

        # 同时也会更新 value_model...
流程及示例

一个典型的 PPO 算法流程是这样的:
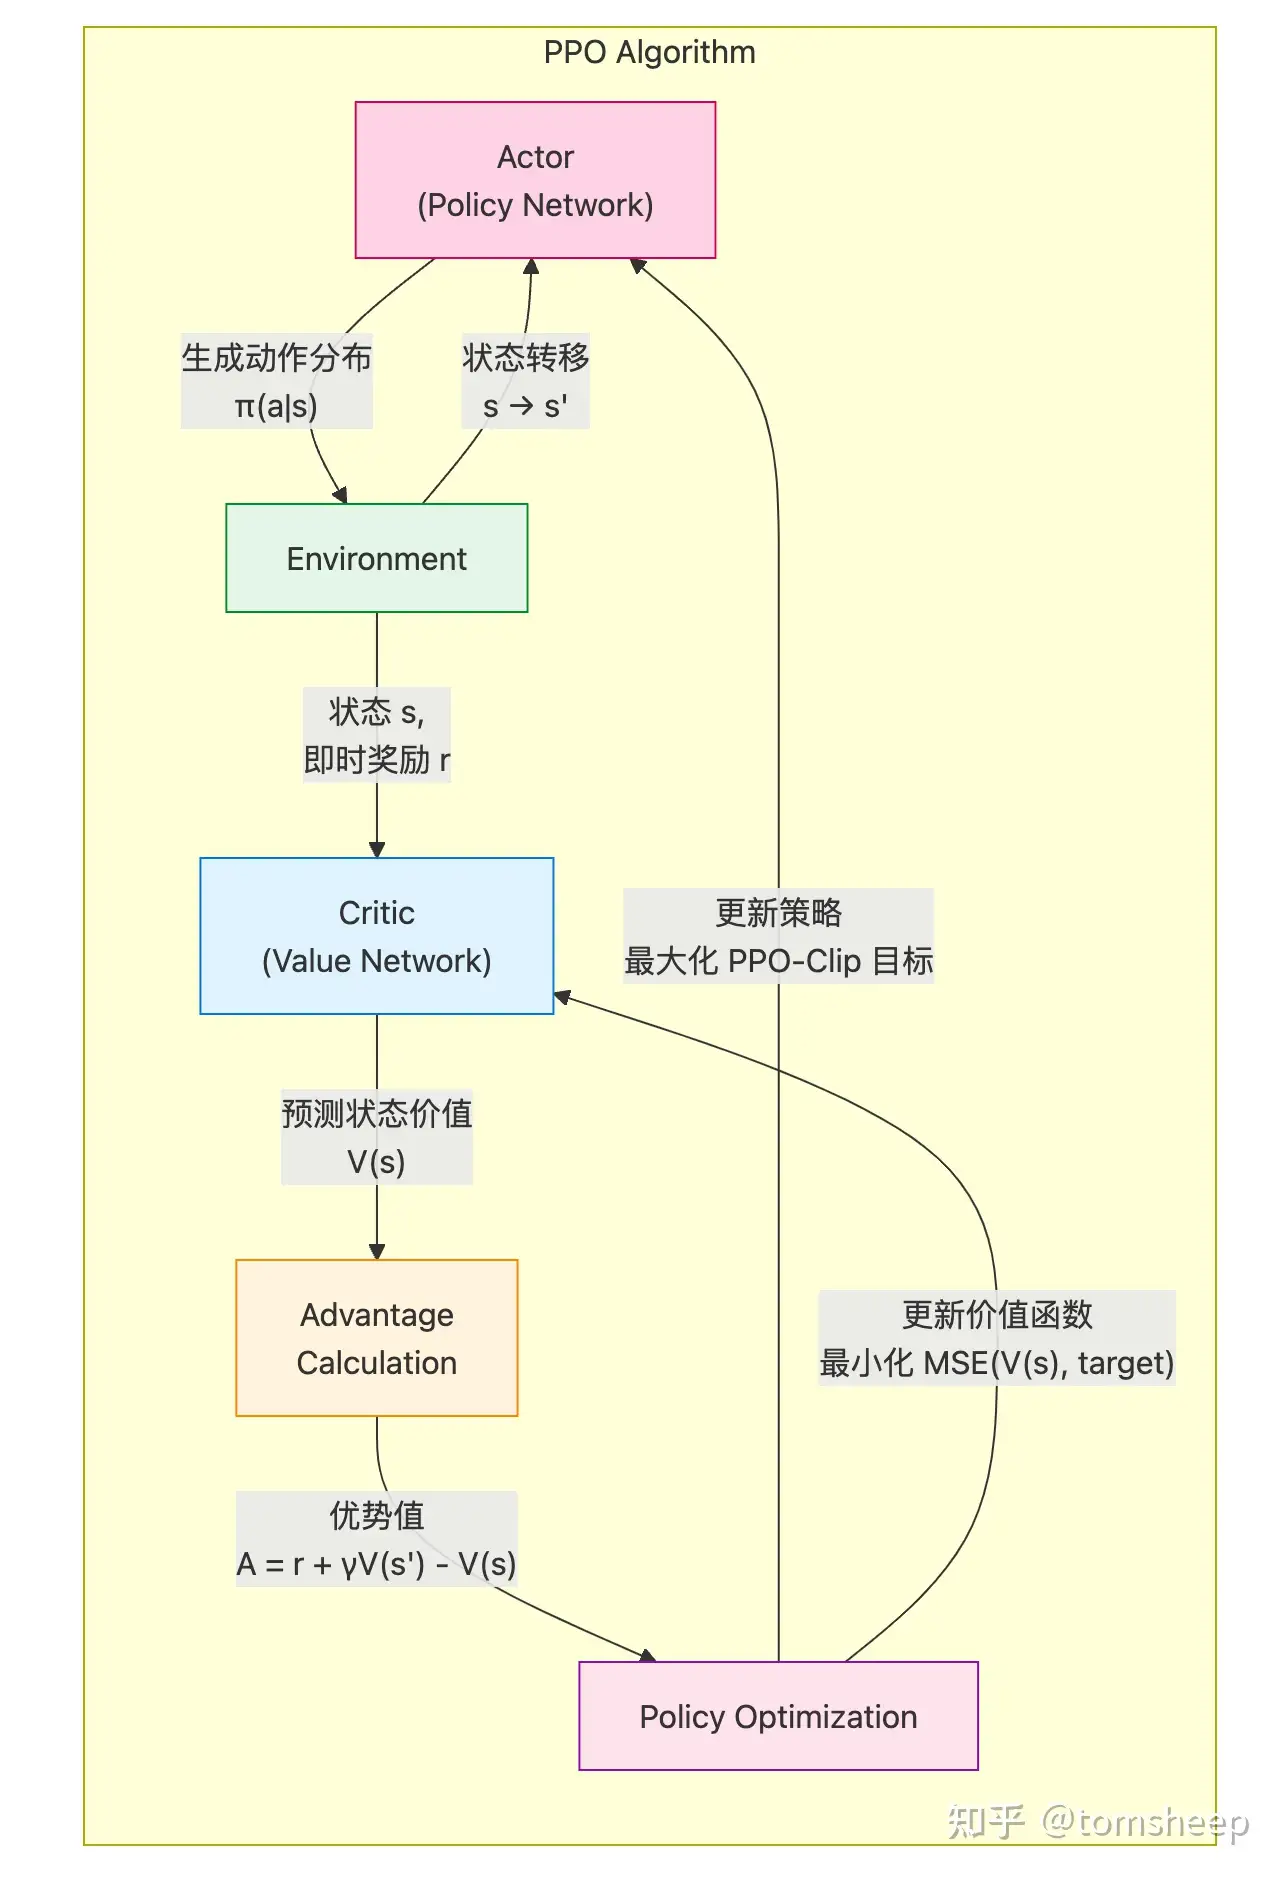 actor model 的输入是prompt(今天天气怎么样?),输出是response(今天天气很好,适合出去玩。)。reference model的输入是prompt + actor_response,Reference Model 通过前向传播,为每个 token 计算概率分布。假设 Reference Model 的输出概率分布如下:
- 对于 token “今天”,概率分布为
[0.4, 0.3, 0.2, 0.1],其中 “今天” 的概率为 0.4。 - 对于 token “天气”,概率分布为
[0.1, 0.5, 0.3, 0.1],其中 “天气” 的概率为 0.5。 - 对于 token “很好”,概率分布为
[0.2, 0.3, 0.4, 0.1],其中 “很好” 的概率为 0.3。 - 对于 token “适合”,概率分布为
[0.3, 0.2, 0.4, 0.1],其中 “适合” 的概率为 0.4。 - 对于 token “出去”,概率分布为
[0.1, 0.2, 0.6, 0.1],其中 “出去” 的概率为 0.6。 - 对于 token “玩”,概率分布为
[0.2, 0.3, 0.4, 0.1],其中 “玩” 的概率为 0.4。 计算每个 token 的对数概率: - “今天” 的对数概率:ln(0.4)
- “天气” 的对数概率:ln(0.5)
- “很好” 的对数概率:ln(0.3)
- “适合” 的对数概率:ln(0.4)
- “出去” 的对数概率:ln(0.6)
- “玩” 的对数概率:ln(0.4)
整个回复的参考对数概率为这些对数概率的总和:
ln(0.4) + ln(0.5) + ln(0.3) + ln(0.4) + ln(0.6) + ln(0.4)
PS: 这个算是回答了 $p_{\theta}(a_t \mid s_t)$ 或 $\pi_{\theta}(a_t \mid s_t)$如何算
补充
PPO 属于 actor-critic 架构,其中 Critic 的作用就是计算 优势函数 (Advantage Function),从而减少策略梯度估计的方差,使训练更稳定、高效。RM 是 外部的奖励信号,是外部环境给与智能体的真实响应——虽然在 LLM 的这个场景里,我们没有特别准确的外部环境建模,退而求其次用另一个训练好的 RM 模型来代替了——而 Critic 是智能体内心对自己答案的评价。打个不准确的比方,你做一套卷子,Critic 是你自己检查自己的答案,给出的自我评价;而 RM 是老师用标准答案给你打分。这样看来,不要 Critic 是不是也行?无非就是我自己「莽」一点,自己不评估自己的答案,反正 RM(环境)会给我反馈,牵引我改进。确实可以,GRPO其实在 Actor-Critic 框架之前,RL 算法就是这样的,不要「基线」了而已。代价就是方差比较大,训练不稳定。其实是通过另一种更简单的「估算基线」的方法,取代了 Critic:就是采样多次,用 RM 评价的平均值来充当这个「基线」。Critic 不是提供额外的奖励来源,而是通过学习预测未来的期望回报,提供了一个动态的基准,用来校准 RM 提供的原始奖励信号,生成更稳定、信息量更大的 Advantage 信号,从而稳定并加速 PPO 的训练。
从更抽象的角度看,RL 本质是最大化期望轨迹回报,通过 log-trick,把优化目标拆到 action / token 的 log-prob 上。Advantage、Critic、GAE 等方法用于改进每一步训练权重的估计;GRPO 则用 response-level 的组内相对 Advantage 省掉 Critic,再把同一个 Advantage 用到该 response 的所有 token 上。
站在 LLM post-train 的角度看,PPO 这一套其实是在解决几个很具体的问题:
- 只有 Reward 时的朴素做法为什么不够?因为奖励信号波动很大,而且经常是整句级、末尾才给出,直接拿来训会导致方差很大。
- 引入 Critic,本质上是引入价值函数作为参考线(baseline),让训练从“只用 Reward” 进化成“用 Advantage 来衡量进步”。
- 加入 Clip 与 min 操作,是为了防止 surrogate objective 继续奖励过大的有利变化。例如 $A_t>0$ 时,概率比 $\frac{P(a_t \mid s_t)}{P_{old}(a_t \mid s_t)}$ 超过 $1+\varepsilon$ 后不再继续鼓励;$A_t<0$ 时则主要限制 ratio 低于 $1-\varepsilon$ 的方向。它不是把 ratio 本身硬限制在区间内。
- Reference Model 和 KL 的作用,则是防止策略为了追求短期 Reward 而偏离原始模型太远,出现作弊、模式坍塌或风格漂移。
- Critic 也不是没有代价。价值函数通常需要和 Actor 同等量级的模型去估计,成本很高,而且在只在回答末尾才给出一个整体 Reward 的场景里,训练一个足够细粒度、足够准确的 value function 也并不容易。
这也是为什么后面会出现 GRPO 这种路线:如果 Critic 难训,或者成本太高,那么就干脆不用 value model,而改成“同一问题采多条输出,直接拿组内相对分数当 baseline”。这样做虽然更粗糙,但工程上会轻一些。
从Policy Gradient到REINFORCE++,万字长文梳理强化学习最新进展
浅谈 RL 里面的 KL 散度个人认为,RL与SFT的区别在于,SFT是token level的0/1奖励,RL是句子level的离散奖励。当然,RL也可以往过程奖励(PRM)或者规则奖励(rule-based)去走。往过程奖励走,无非是引入一个sub-sentence level的监督信号,介于整句(或者说答案)与单个词之间的监督信息。往规则走,是希望整体系统不要被Reward Model所束缚,如果数据质量足够高+基座足够优秀,那么就不需要花里胡哨的reward形式,直接使用rule-based reward就行。这里的reward大多是(-1、0.2、1)这种三段式设计,本质上和SFT的0/1是差不多的。如果我们对(-1, 0.2, 1)做一次softmax,那么就变成了(0.08, 0.26, 0.64)。从某个视角来说,也算是one-hot label的平滑形式。大家都喜欢说,RL是泛化的,SFT是记忆的。我觉得,之所以造成这种现象,是因为RL学的比较难,所以聚焦于方法论,而SFT学的比较简单,那么就容易掉入过拟合陷阱,也就是SFT记住但无泛化。正是因为RL学的比较难,那么RL的acc涨的是比较慢的,好处但是就是,真的往解题的技巧上学。
深挖PPO,聊聊前身TRPO PPO的目标函数与Reinforce算法的目标函数还是有一定差异的,尤其是它采用了 $\pi_{\theta_{old}}$ 来采样数据并在目标函数中引入重要性采样 $\frac{\pi_{\theta}}{\pi_{\theta_{old}}}$ ,这其实并不直观,我们明明推导的是基于蒙特卡洛采样的Policy Gradient,怎么目标函数中有这么多不同的策略网络呢?为什么采样的策略和执行更新的策略不一样呢?为什么长得这么不一样的目标函数也可以算作蒙特卡洛采样呢?这篇文章就要来梳理这个问题,首先从TRPO说起。TRPO(Trust Region Policy Optimization)和PPO(Proximal Policy Optimization)的作者是同一人,TRPO也是PPO的前身工作。
Group Relative Policy Optimization(群体相对策略优化)
GRPO 的创新:无 Critic 的 Advantage 估计
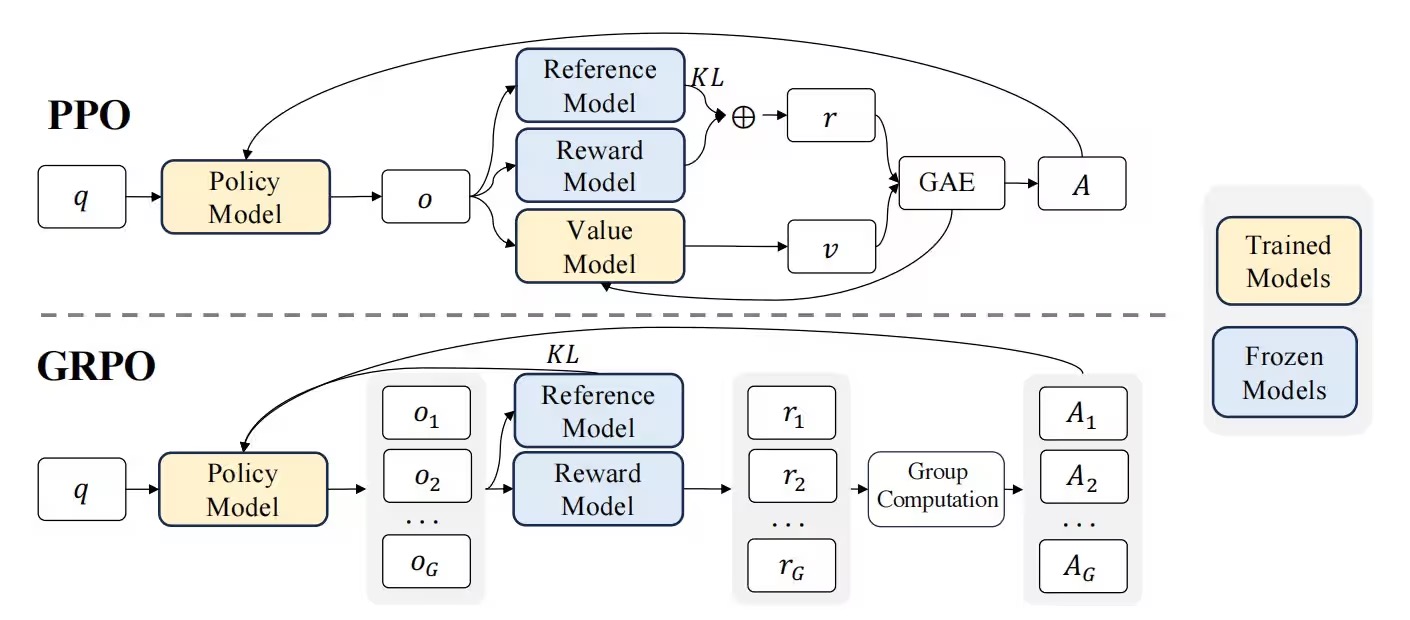
图中有以下几个关键点:
- 没有 Value Model(仅保留 Reward Model 作为监督的依据) 和输出 v(value)。PS:和PPO最大的区别是优势函数的计算,GRPO中用最后一个token的奖励算完优势之后,同一个seq中的所有token共用一个优势。
- 同一个 q 得出了一组的 o(从 1 到 G)(用于比较优势)。PS:PPO 只采样 1 个
- 计算 A(Advantage) 的算法从 GAE 变成了 Group Computation。PS:PPO使用GAE优势
- KL 散度计算不作用于 Reward Model,而是直接作用于 Policy Model。PS:虽然 deepseek-r1 使用规则作为 reward 训练,但 reward model 部分不是 GRPO 与 PPO 的主要区别。
可以把 GRPO 理解成:在“PPO 这套思想仍然成立”的前提下,把 Critic 这一支砍掉,直接用组内相对奖励去估计 baseline。也就是说,PPO 和 GRPO 的大方向非常接近,真正差别最大的地方还是 Advantage 的来源:
- PPO:通常依赖 Critic + GAE 来估计 Advantage
- GRPO:依赖同一问题下多条输出的组内相对分数来估计 Advantage
因此,GRPO 并不是完全换了一套世界观,而是把 “baseline / advantage 怎么来” 这件事做了一个更轻量、更偏采样式的替换。
公式
GRPO舍弃了传统PPO算法中的Critic模型(通常与策略模型大小相同)部分,转而通过直接从群体得分中估算baseline。在训练大语言模型llm时,一个最大的问题是中间状态很难评估(PPO的critic model总是试图精细地预测每个步骤的价值),由于语言生成是一个自回归式的序列决策过程,我们很难直接判断某个中间状态的好坏,——它是否能最终生成一个高质量答案,往往是不确定的。这就带来了一个核心问题:PPO中使用的critic model(即计算价值函数value function 用的模型)到底有没有用?它的意义有多大?准不准?这都是很难确定的。所以,PPO中critic model的意义虽然存在,但它的准确性是个大问题,限制了整体方法的可靠性。相比之下,GRPO采取了一种截然不同的思路:它直接让llm多次sample,生成完整的响应,然后用显式的奖励来评价这些最终结果。正因为一把梭哈,直接生成结果,完全跳过了对中间状态的评估,直接聚焦于完整输出的质量。既然中间状态这么难评估,那就干脆不评估,生成结果出来后自然可以通过设计好的奖励机制来判断好坏。这样一来,GRPO省去了预测中间状态价值的麻烦,直接依赖最终输出的奖励信号。更重要的是,这种方式可以通过显式设计reward奖励信号,而且必然是有效的。因为奖励是针对完整响应计算的,这种清晰的反馈比PPO中模糊的价值函数预测要可靠得多。
具体来说,对于每一个问题 $ q $ ,GRPO会从旧的策略模型参数 $ \pi_{\theta_{\text{old}}} $ 中采样一组输出 $ {o_1, o_2, o_3, \ldots, o_G} $,然后通过最大化GRPO目标函数以优化当前策略模型参数 $ \pi_\theta $。
辅助理解:不同的策略模型 $\pi$ 实际上是一个模型在不同参数阶段下的版本。
具体可以按如下理解,
- $ \pi_{\theta_{\text{old}}} $:上一轮模型参数的模型,可以理解为 $ \pi_\theta $ 上一个iteration的模型。
- $ \pi_\theta $:最新的模型参数的模型(正在更新的)。
- $ \pi_{\theta_{\text{ref}}} $:初始模型参数。
原文公式如下图所示:
对第 $i$ 条输出的第 $t$ 个 token,先定义逐 token importance ratio:
\[r_{i,t}(\theta)=\frac{\pi_\theta(o_{i,t}\mid q,o_{i,<t})}{\pi_{\theta_{\text{old}}}(o_{i,t}\mid q,o_{i,<t})}\]在本文讨论的 outcome supervision 场景中,原始 GRPO 的 clipped objective 在 token 维度上计算,再在每条 response 内聚合:
\[\mathcal{J}_{\text{GRPO}}(\theta)= \mathbb{E}\left[ \frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|} \left( \min\left(r_{i,t}(\theta)A_i,\operatorname{clip}(r_{i,t}(\theta),1-\varepsilon,1+\varepsilon)A_i\right) -\beta D_{KL}^{i,t} \right) \right]\]其中,同一条 response 的所有 token 共用 $A_i$,但 importance ratio $r_{i,t}$ 是逐 token 计算的。逐 token 的 KL 估计为:
\[D_{KL}^{i,t}=\frac{\pi_{\text{ref}}(o_{i,t}\mid q,o_{i,<t})}{\pi_\theta(o_{i,t}\mid q,o_{i,<t})} -\log\frac{\pi_{\text{ref}}(o_{i,t}\mid q,o_{i,<t})}{\pi_\theta(o_{i,t}\mid q,o_{i,<t})}-1\]$\varepsilon$ 控制 clipped surrogate objective 的截断区间,但不是策略参数实际学习步长的硬上限。
$ \beta $ 控制原始能力偏移惩罚的程度。主要是缓解灾难性遗忘的问题。
DeepSeek的GRPO算法是什么? - 梦想成真的回答 - 知乎最核心的就是逐 token 的 $r_{i,t}(\theta)A_i$
- q 表示此次的问题
- $o_i$ 表示旧的policy model 的第i个输出策略
- $\pi_\theta(o_{i,t}\mid q,o_{i,<t})$ 表示当前模型在给定前缀时输出第 $t$ 个 token 的概率
- $\pi_{\theta_{\text{old}}}(o_{i,t}\mid q,o_{i,<t})$ 表示旧策略对同一个 token 的概率
进而,$r_{i,t}(\theta)$描述当前策略相对旧策略在这个 token 上的概率变化。优化目标不是单独最大化 ratio,而是最大化 ratio 与 Advantage 共同构成的 clipped surrogate:$A_i>0$ 时鼓励提高该 token 的概率,$A_i<0$ 时鼓励降低它。clip 是目标函数裁剪,不是 gradient clipping;KL 则用于约束当前策略不要偏离 reference model 太远。
我们再说优势函数 (Advantage Function) $A_i$,R1中非常简单直接,就是reward score 做个标准化,得到的$A_i$就是第i个决策在多个决策中相比较baseline 好多少或者坏多少。如果$A_i$>0,那么就是正向激励,否则,$A_i$< 0 就是负向激励。
通过如下公式计算出:
\[A_i = \frac{r_i - \text{mean} ( \{r_1, r_2, \cdots, r_G\} )}{\text{std} ( \{r_1, r_2, \cdots, r_G\} )}.\]这里两步——减组内均值、再除组内标准差——各管一件事。减均值就是前面说的 baseline,把“恒正的奖励”变成“相对组内的好坏”;除 std 是做尺度归一:不同题难易不同,有的题一组 reward 普遍高、有的普遍低、方差也不一样,除以 std 后各组的优势被拉到可比的尺度,梯度步长不会被“这组题碰巧分偏高/偏低”带偏。
但这步归一化也埋了一个 GRPO 特有的退化点:当一组 G 条样本的 reward 全一样时(全对或全错),组内均值就等于每一条,分子 $r_i-\text{mean}$ 全为 0,优势整组归零(此时 std 也为 0,所以伪代码里要 +1e-4 防除零;但就算不除零,分子为 0 也让优势为 0)。优势为 0 → 这一组对梯度零贡献 → 整组白跑。
这正对应前面「GRPO 不足」里说的“过难/过易样本优势为 0、回传不了有效梯度”:
- 简单题:G 条大概率全对 → 白跑;
- 难题(尤其长程任务):G 条可能全错(有限采样里压根没探到正确轨迹)→ 也白跑,而且一组长轨迹可能是几小时算力,最后零信号,工程上很肉疼。
所以 GRPO 真正“吃到”有效梯度的,是那些组内有对有错的中等难度题——这也是它对题目难度分布、采样数 $G$、温度都比较敏感的原因。(顺带一提:要不要除 std 本身也有争议,Dr. GRPO 等工作指出除 std 会给“低方差的题”不成比例的大优势,干脆把这一步去掉。)
现在可以解释 $r_{i,t}(\theta)A_i$ 为什么要把两项乘在一起。$A_i$ 表示整条 response 相对组内平均水平的好坏,$r_{i,t}(\theta)$ 表示当前模型相对旧模型在第 $t$ 个 token 上的概率变化。$A_i>0$ 时,目标鼓励提高这条 response 中已采样 token 的概率;$A_i<0$ 时则鼓励降低。因为同一条 response 的所有 token 共用 $A_i$,GRPO 会为每个 token 计算各自的 ratio 和 loss,但没有得到不同的 token-level Advantage。
接下来说 clip。它不是把 $r_{i,t}(\theta)$ 本身硬限制在 $[1-\varepsilon,1+\varepsilon]$,也不是梯度剪裁。它通过 min 形成单侧限制:$A_i>0$ 时不再奖励 ratio 超过 $1+\varepsilon$ 的增长;$A_i<0$ 时不再奖励 ratio 低于 $1-\varepsilon$ 的下降。朝不利方向移动时仍然保留梯度,以便把策略拉回来。
GRPO 希望逐 token 的 $D_{KL}^{i,t}$ 尽量小。令 $x=\frac{\pi_{\text{ref}}}{\pi_\theta}$,$x-\log x-1$ 在 $x=1$ 时取得最小值 0,因此目标是让当前策略与 reference model 的概率接近,而不是让这个比率单调变小。$\pi_{\text{ref}}$ 是冻结的初始/SFT 模型,整个 RL 过程保持不变;$\pi_{\theta_{\text{old}}}$ 是产生本轮 rollout 的旧策略;$\pi_\theta$ 则是当前正在更新的策略。
为什么 KL 要写成这个奇怪的样子? 因为它其实是 KL 散度的 k3 估计(Schulman 提出的一种蒙特卡洛估计)。标准 KL $\mathrm{KL}(\pi_\theta | \pi_{\text{ref}}) = E_{x \sim \pi_\theta}[\log \frac{\pi_\theta}{\pi_{\text{ref}}}]$ 要对整个词表分布求和才算得准,但 RL 里我们手上只有采样到的那几个 token,只能用单样本去估。记 $r = \frac{\pi_{\text{ref}}}{\pi_\theta}$:
- 最朴素的估计是直接用 $\log\frac{\pi_\theta}{\pi_{\text{ref}}}=-\log r$。它无偏,但可正可负、方差大——单个样本上经常给出“负的 KL”,看着别扭、训练也抖。
- k3 改用 $r - \log r - 1$(也就是公式里那个 $\frac{\pi_{\text{ref}}}{\pi_\theta} - \log\frac{\pi_{\text{ref}}}{\pi_\theta} - 1$),三个好处:① 恒 $\ge 0$($x-\ln x-1\ge 0$,$x=1$ 时取 0,正对应两分布相等);② 仍然无偏,其期望恰好等于真实的 $\mathrm{KL}(\pi_\theta | \pi_{\text{ref}})$;③ 方差比朴素估计更低。所以它“看着不像 KL”,但作为逐 token 估计、再平均的估计量,比朴素 log-ratio 更好用(伪代码里的
kl_loss就是这一项)。
还要注意 KL 在 PPO 和 GRPO 里放的位置不一样:经典 RLHF-PPO 习惯把 KL 当成奖励惩罚塞进 reward(前面 PPO 伪代码里的 rewards = reward_model(...) - KL(...),即每步 $r_t$ 里就扣掉了 $\beta\log\frac{\pi_\theta}{\pi_{\text{ref}}}$);GRPO 则把 KL 当成独立的一项直接加在 loss 上(目标函数里那个 $-\beta D_{KL}$)。两者都是为了“别离参考模型太远”,区别只在它混进回报里、还是单列在损失里。
我们稍微总结下GRPO:GRPO去掉了value model,仅仅只训练policy model,并且使用reward score标准化的方式作为baseline,让模型找到更优的解法,为了更稳定的训练,clip项和KL散度变种都是辅佐让模型不要训飞,一步步慢慢学的手段。由于reward只在输出级别($o_1,o_2,…$)提供(没有每个 token 的奖励),GRPO把该输出的优势均匀地分配给该输出内所有token。PS:每个输出内部所有 token 共用同一个 Advantage;Actor-Critic + GAE 的区别是可以估计随 token 位置变化的 Advantage,并不是外部 reward 天然变成了 token-level。
把这件事接回 credit assignment,会更看清它的代价。 语言模型强化学习基础 里讲过,RL 的核心难点之一就是 credit assignment——一条轨迹整体好,不代表每个 token 都好,理想情况要能算出每个 token 各自的 $\hat{A}$(critic + GAE/TD 就干这个,单步优势 $=\delta_t$ 给了每个 token 自己的信号)。而 GRPO 把 critic 砍掉后,整条输出只有一个标量优势、再均匀摊给每个 token,等于把 credit assignment 退到了最粗的一档:哪怕一条 1000 token 的输出里只有第 50 步出错,GRPO 也只能把这 1000 个 token 一起奖励或惩罚,没法把锅精确甩给第 50 步。
用上篇「有偏与无偏」那条轴看,这就是 GRPO 的取舍:省掉 critic 避免了 learned value 的 bootstrap 误差,也让工程更轻;但组内均值包含当前样本自身,标准差归一和 clip 也会改变梯度估计,因此不能简单称为“无偏”。与此同时,整条输出共用一个 Advantage,牺牲了 token 级信用分配。输出越长、越是多步,这个粗粒度代价越大;GSPO 改善的是 importance ratio 的序列级一致性,并没有解决这项 credit assignment 问题。
伪代码
for iteration in training:
    # --- 1. Rollout ---
    with torch.no_grad():
        # group_responses: [B, G, L]
        # logprob_old: [B, G, L]
        # group_rewards: [B, G]

    # --- 2. Advantage (必须在分布式/全组维度计算) ---
    # 这里是 GRPO 的灵魂:组内标准化
    adv = (group_rewards - group_rewards.mean(dim=1, keepdim=True)) / (group_rewards.std(dim=1, keepdim=True) + 1e-4)
    # 广播到 token 维度: [B, G, 1] -> [B, G, L]
    adv = adv.unsqueeze(-1)

    # --- 3. Update ---
    for epoch in range(K):
        # 这里的 model.logprob 需要返回每个 token 的 logprob: [B, G, L]
        logprob_current = model.logprob(prompts, group_responses)
        logprob_ref = ref_model.logprob(prompts, group_responses)

        ratio = torch.exp(logprob_current - logprob_old)

        # PPO Clip 部分
        surr1 = ratio * adv
        surr2 = torch.clamp(ratio, 1-eps, 1+eps) * adv
        # 这里取负数因为我们要 maximize reward
        policy_loss = -torch.min(surr1, surr2).mean()

        # KL 惩罚项 (DeepSeek 风格: 直接对 logprob 做差)
        # 用来限制模型不要跑太远
        kl_loss = torch.exp(logprob_ref - logprob_current) - (logprob_ref - logprob_current) - 1

        total_loss = policy_loss + beta * kl_loss.mean()

        total_loss.backward()
        optimizer.step()
其它
- 训练后的模型推理能力依然极度依赖base model。输出概率的改变大部分都发生在连接词、推理流程影响的词,而在单步公式、数字、推理这些基本能力上,模型输出几乎还是在沿用base模型认为最好的路径,说明这些基础能力几乎完全来自base model。这里还做了一个训练时间太长,已经训练崩溃了的checkpoint的可视化,可以看到一旦离base模型太远,正常输出都没法进行下去了,会出现重复、乱码等情况。同时可以看到,这个崩溃的实验其实还没有完全崩溃,输出的前面一段还是正常的,只是训练到了后期,才开始出现模式坍塌。从这个实验的观察可以推出,RL是不能远离base模型太多的,一旦把模型训练偏得多了一些,模型的输出就会崩溃,中断。导致无法输出最终答案,所有rollout的reward分数都是0,模型就没有正确的方向了。总之,目前的Math RL是强依赖一个非常强大的base model:不同大小的模型,相同算法RL后,提升的上限有很大的不同,RL可以通过激发base模型的长推理模式,充分发挥base模型的潜在推理能力。这意味着,想要获得最好的推理效果,就必须要在最好的base模型上面训练。
- base模型中本来概率很高的token,依然在GRPO中被不断加强,在训练后likelihood变得更接近1,也就是进行了过度自信的优化。这样的优化对模型的生成准确率能力基本是没有帮助的,但是会导致对模型的修改,产生额外的学习税。并且在token的prob都被推高的情况下,也会影响模型的探索的可能,例如prob在比较高的情况下,例如0.99时,在同一个context下,做16次rollout还有15%的可能出现非最高的token,相当于每7个这种token,rollout 16次中会有一个非最高token被探索,但是如果prob推高至0.999,概率就会降低为1.6%。这些token的探索就会几乎不存在。
-
从模型的演变角度来说,对一个大模型做RL,是从base/SFT模型作为ref开始,逐渐训练远离这个ref模型,同时获得越来越高的reward的过程。但是与此同时,RL又不能离ref模型太远,否则轻则无法继续训练、重则模型崩溃,而且离ref模型渐行渐远的过程,模型会忘掉前面学过的知识,降智交智商税。在这两层看似矛盾的要求下,要想RL训练的好,大家提出了很多tricks。
- 第一种是让训练过程对ref模型修改的又快又好,这样可以最大限度保留原始模型的能力。
- 另一个思路是在模型训练的过程中,持续恢复智商。 目前证明有效的都是要让训练又快又好的tricks,而对于恢复智商类的tricks目前基本是没有用的。主要原因我认为是这些策略虽然初衷是好的,但是在LLM的训练过程中起到了拖后腿的作用,无脑将模型往回拉。
rollout 是一个强化学习专用词汇,指的是从一个特定的状态按照某个策略进行一系列动作和状态转移,在 LLM 语境下,“某个策略”就是 actor model 的初始状态,“进行一系列动作”指的就是推理,即输入 prompt 输出 response 的过程。跟着 verl 的代码梳理GRPO
GRPO 不依赖 绝对 reward 值,只关心 同一 prompt 下多个 sample 的相对好坏(只要给每个 sample 一个可比较的 reward 分数即可),用 group-wise relative advantage 来更新策略。GRPO 不“要求” Reward Model,但 Reward Model 依然是提升复杂、主观、sparse reward(比如reward function 只能给出0/1) 场景表现的利器
GRPO 不足(优化方向)
- 响应多样性下降 (熵崩塌)
- 随着模型迭代,策略的确定性增强,随机性降低(回答多样性下降),模型缺乏探索(更多正确回答),容易陷入局部最优解。
- 过度思考
- 原因:GRPO 采用的是 Sample-Level 加权损失,对于长回答中的错误容忍度更高,
- 结果:
- 对于困难的问题,通常会输出冗长的思考过程;
- sample-level loss 由于无法有效惩罚长样本中低质量的 pattern, 例如乱码和重复的单词。
- Rollout 效率低
- GRPO 的 rollout 过程是随机进行的(均匀采样),没有考虑样本的难度,导致:
- 对于困难问题,模型可能无法在有限的 rollout 次数内采样到正确答案
- 对于过难或者过于简单的样本则优势为0,无法回传有效梯度。
- 长样本截断、训练不稳定性。
- (在RL训练中,通常会固定一个最大生成长度,并截断过长的样本)过长的响应被强行截断,导致reward也被截断(对这些被截断的样本进行错误的奖励函数设计会带来奖励噪声,并严重干扰训练过程)。
- 策略或价值函数的更新波动,导致训练曲线震荡、收敛缓慢甚至发散;每次训练收敛后在评测集上指标的方差较大。
GSPO
GSPO(Group Sequence Policy Optimization,Qwen 团队提出)常被误解成“把 GRPO 的优势细化到每个 token”,其实方向恰恰相反。GRPO 确实是整条输出共用一个优势(上一节说过),但 GSPO 要动的不是优势的粒度,而是 重要性比率的粒度。
回忆 GRPO/PPO 的更新里都有一项重要性比率 $\frac{\pi_\theta(a_t \mid s_t)}{\pi_{old}(a_t \mid s_t)}$。GRPO 是逐 token 算这个比率的,而单个 token 的比率方差很大,序列越长、这些噪声累积得越厉害(对长回答、MoE 尤其明显),训练就容易抖。
GSPO 的做法是把重要性比率从 token 级提到序列级:整条回答只用一个比率(对每个 token 的 log-ratio 做长度归一,相当于几何平均),再在这个序列级比率上做 clip。这样“比率的粒度”就和“奖励本来就是序列级”这件事对齐了——是把比率“变粗、对齐到整句”,而不是把优势“变细到 token”。优势本身仍是组内相对的 $r^{(i)} - \bar{r}_{\text{group}}$,没变;变的只是这个比率到底算在单个 token 上、还是整句上(下面的代码对比,差异正落在这一处)。
详解Qwen3-GSPO和DeepSeek-GRPO两大强化学习算法的区别PS:建议细读,文章给的例子非常惊喜。
GRPO 的Loss的计算过程
- 算优势:每个句子的奖励减去组内平均奖励,得到相对优势(好句子为正,差句子为负),也就是A。
- 当前模型生成 token 的概率 ÷ 旧模型生成相同 token 的概率(importance ratio),也就是 $\pi_\theta \mid \pi_{\theta_{old}} $
- Clipped surrogate:根据 Advantage 的正负,单侧截断继续带来收益的 ratio 变化;ratio 本身仍可能超出 $[0.8,1.2]$
- 算基础损失:对每个 token 计算 clipped ratio 与 response-level Advantage 的乘积,再加负号。同一条 response 的 token 使用各自的 ratio,但共用同一个 Advantage。
- 加正则项(可选):加入 KL 散度,防止模型和初始版本差太远
- 总损失:Group的所有损失的平均值
GRPO 和 GSPO Loss的计算关键差异
其中最主要的差异在重要性计算那一步,GRPO是计算每个token的概率比
log_ratio = per_token_logps - old_per_token_logps  # 每个token的log概率差
log_importance_weights = log_ratio  # 保留token级粒度
coef_1 = torch.exp(log_importance_weights)  # 每个token的概率比
而GSPO是计算整个句子的平均概率比
log_ratio = per_token_logps - old_per_token_logps  # 每个token的log概率差
# 按句子平均:总log概率差 / 有效token数(避免padding影响)
log_importance_weights = (log_ratio * completion_mask).sum(-1) / completion_mask.sum(-1).clamp(min=1.0)
log_importance_weights = log_importance_weights.unsqueeze(-1)  # 扩展为(batch_size, 1)
coef_1 = torch.exp(log_importance_weights)  # 整个句子的平均概率比
长短程任务:GRPO 与 PPO 的天平
把本篇的 credit assignment、组内标准化退化,连同上下篇讲的 bias-variance 几条线收一下,正好能解释“2024 年大家爱用 GRPO、2025 年长程 Agentic 任务起来后又往 PPO/critic 回摆”这件事。两者的根本差别还是 advantage 怎么来:
- GRPO:无 critic、纯结果奖励、组内相对 Advantage → 省掉 learned value 的 bootstrap 误差,但组内均值、标准差归一和 clip 本身仍会引入估计偏差;同时整条输出共用一个优势(credit assignment 最粗)。
- PPO:有 critic → bootstrap 带来一点偏差,换来低方差,以及 GAE/TD 给的 token 级信用分配。
短任务(数学、单测,几十到几千 token、可验证)为什么 GRPO 够用甚至更优:轨迹短 → 方差本就小;有清晰最终 return;省掉和 actor 同量级的 critic → 省显存、省一套训练。扔掉 critic 几乎无损。
长程任务(几十上百步、上十万 token 的 agent 轨迹)为什么天平倒向 critic:
- 方差随轨迹长度累积,GRPO 的高方差被放大;
- credit assignment 退到最粗——长输出里某一步坏了,GRPO 只能整条一起奖惩,定位不到是哪步;
- 退化更频繁——难题一组 G 条全错(采样压根没探到正解)→ 组内 reward 全一样 → 优势归零、几小时算力零信号;
- 对 agent 而言,开放环境 + harness/工具返回带噪,相当于一个随机环境;而随机环境下,“靠采样估 baseline”要拿到准估计所需的交互次数成倍放大,反倒是 learned value(critic)在样本效率上更划算。
所以“修 GRPO 让它扛长程”的代价,开始大于“退回 PPO/critic 好好调”。业界缓解长程的几条路线——把 critic 请回来做 token 级优势、用复合/过程奖励(PRM)、或 on-policy 蒸馏给 dense 的逐 token 监督——本质都是给长程补回 per-step 的密集信号,无非补在 baseline 上、还是补在 reward 上(下一节 V4 的多专家 on-policy 蒸馏,就是后者的一个例子)。
OPD/On-Policy Distillation
过去我们默认:后训练就是拿一个基座模型,数学 RL、代码 RL、agent 能力 RL 全都塞进同一个 run 里一起训。问题在于,这三种能力会互相打架。数学要求模型严谨收敛,代码希望它多探索不同实现,agentic 任务又需要它长程规划——放在一起训,就是典型的跷跷板:这边涨了那边掉,成本还高得离谱。2026 年的解法:别放在一起训了,分开训。
OPD把on-policy和offline优点结合起来,用老师模型对学生的每一步打分。让学生从自己当前的分布采样轨迹,这就是 on-policy 的含义,像蒸馏一样,由教师对每个 token 给出密集反馈,信号密度上来了。学生通过最小化与教师之间的 reverse KL 散度来更新,梯度方向是让学生在自己采样的 token 上,逐步向教师的概率分布靠近。
on-policy模型的学习内容是自己 rollout 出来的好的样本。这样做的好处有很多,举一些例子:
- 这样的模型不容易出现灾难性遗忘的问题。RL 的训练目标是“强化”自身生成的好的样本,而不是强行去拟合新的数据分布,对模型内部的知识不会产生破坏效果。
- 真正 inference 的时候会更加鲁棒。少量的 SFT 样本,只能教会模型强行记住某一条轨迹(A -> B -> C),但是一旦中途发生了些许扰动(如 A -> B’ -> ?),模型由于缺乏对轨迹的深入理解,就可能就会发生错乱。
但是 RL 也有它固有的问题,就是计算不够高效,每次 rollout 一条 trace,都只能获得一个最终的奖励信号。而对比 SFT,对于每一个 token,都有一个对应的 label 来约束更新。这样相比起来,RL 在训练中,模型从一次尝试中学到的内容太少了,效率较低。那么,能不能有一种方法,既具有 on-policy 的特征,又能像 SFT 那样,对每个 token 都加以监督呢?OPD 就是一个有效的尝试,引入蒸馏的思想来解决这个问题。核心的思想很简单,首先由 student model 来 rollout 样本(体现了 on-policy 特点);然后用 teacher model 计算每个 token 对应的 logit;最后拉近 student 和 teacher 在每个 token 上的 logit 分布即可(体现了蒸馏)。具体到实现方式层面,我们简单介绍几种常见的实现。按照Thinking Machine Lab 的实现,OPD 本质上就是通过采样的方法,优化模型策略 和教师策略 之间的 reverse KL,也就是:
\[\mathrm{KL}\big(\pi_\theta \parallel \pi_{\mathrm{teacher}}\big) = \mathbb{E}_{x \sim \pi_\theta}\Big[ \log \pi_\theta(x_{t+1} \mid x_{1..t}) - \log \pi_{\mathrm{teacher}}(x_{t+1} \mid x_{1..t}) \Big]\]在实操的时候也很简单,首先使用需要训练的模型 进行 rollout;然后再使用上面右侧的公式计算出 logit 距离 teacher 的距离作为损失函数;最后梯度下降进行计算就可以了。
三种主流 OPD 实现 |类型| 计算规则| 特点| |—|—|—| |采样 Token OPD| 仅对学生实际采样的单个 Token 计算损失| 最轻量、工业界最常用,无额外显存开销| |全词表 OPD| 对整个词表所有 Token 计算 KL 散度 |梯度最密集,但显存 / 计算成本极高| |Top-K OPD| 仅对学生概率最高的前 K 个 Token 计算损失| 折中方案,兼顾效果与成本,本文实验默认使用|
OPD 成败的两大决定性条件
- 师生必须具备兼容的思维模式。即便教师基准精度更高,若师生推理逻辑、候选 Token 偏好差异过大(初始重叠率低),OPD 会彻底失效;早期思维模式的错位造成的损失,训练后期也无法修复。OPD 学习的不是「教师的高分能力」,而是教师的推理思维范式。
- 教师必须提供学生未掌握的全新知识。思维模式匹配≠OPD 一定成功。若师生来自同一训练流水线、同源数据,即便教师规模更大、精度更高,也无法提供可迁移的新知识,OPD 依然收效甚微。模型高分 ≠ 拥有新知识。同家族不同规模模型,只是对同一数据的拟合程度不同,底层分布几乎一致,无法产生 OPD 可利用的新知识。
OPD的基本流程如下:
- On-Policy采样:学生模型根据输入prompt自回归生成完整回答(不使用教师的输出)
- 教师评分:将学生生成的序列送入教师模型,获取逐token位置的logits
- 分布对齐:计算学生分布与教师分布之间的KL,以此作为训练损失
- 反向传播:更新学生模型参数,使其在自身生成的序列上接近教师的logits分布。损失函数设计
- Forward KL
- Reverse KL
这一流程与标准SFT的区别在于步骤1(on-policy vs 离线)和步骤3(软标签分布匹配 vs 硬标签CE损失)。与RL的区别在于步骤3(密集软标签 vs 稀疏标量奖励)。
OPD 的固有缺陷与适用边界(代价与局限)
- 奖励质量随序列长度衰减(长 Horizon 失效)。OPD 存在「最优序列长度区间」(实验中 3K~7K Token 效果最佳)。
- 全局有效奖励 ≠ 局部可优化梯度。教师的逐 Token 优势信号存在各向异性(不同位置信号相互抵消),梯度幅值极小,学生无法完成局部优化。
从 OPD 到 self-distillation。OPD 单纯的方法部分已经相当简洁有效了,感觉可优化的空间不大,唯独不好处理的点在于 teacher model 怎么获得。如果按照一般的想法,teacher model 使用一个 size 很大的开源模型,那么 tokenizer 很可能和 student model 不一致,那么蒸馏的 logit 和位置就对不齐,直接导致方法用不了;另一方面,虽说做实操我们总喜欢蒸馏更强的模型(不是),但做科研我们总是想提高模型的上限,那么简单的蒸馏就做不到这点了。所以最近看到不少 paper 都采用了 self-distillation 的思想,也就是自己蒸馏自己 —— 这样就避免了 tokenizer 不统一的问题。这类工作的核心问题在于,怎么让自己 rollout 更好的结果,作为 teacher。因此不少文章给出了解决方案:可以在模型输入的 prompt 里面,把专家的解答过程(demonstration)放进去,并让模型基于专家答案,给出解答过程(成为和符合自己模型风格的样本,后续再进行训练和监督)。这样一来,能保证最终 rollout 的质量,又能保证 on-policy 的特点。
LLM 的训练流程
一个领域(比如 Coder/Match/文本专家) LLM 的训练方案:re-train,SFT,RLHF/RLVR。怎么整合成一个混合通用模型呢?DeepSeek V4技术报告流程讲的很细致:先是 pre-train 得到一个 Base-Model,然后先按领域(数学、代码、agent、指令跟随等)分别训练 10 几个专家模型,每个专家都走过 SFT + GRPO 的完整 RL 流程,在自己领域里练到极致。然后关键的一步来了:把这些专家”合成”一个统一模型时,不是让 student 去抄 teacher 的输出分布,而是让 student 自己先 rollout 生成回答,再让多个 teacher 在 student 自己写出来的轨迹上逐 token 给反馈。这实际就是多专家的 on-policy 蒸馏(OPD)。PS:OPD并非一种绝对更好的蒸馏方式,它有它的适应前提。“Rethinking On-Policy Distillation of Large Language Models”指出,即使 teacher 更强,如果 student 和 teacher 的 top-k token 分布重叠率(overlap ratio)低,OPD 就失败。类比人类学习的故事,就是你开始自己做题前,还是要先认真读书预习,认真听老师讲,拉齐你们的基本概率分布!
汇总
强化学习在LLM训练中的作用的思考 建议细看下,不可避免的要与sft 对比。
- RL方法共享相同的更新原则:即通过对目标函数进行梯度更新来调整模型参数。最简单的形式表示为:$\theta \leftarrow \theta + \alpha\nabla J$。其中 $\theta$代表模型参数,$\alpha$是学习率,$\nabla J$是目标(通常是期望奖励)的梯度。然而,这个梯度的计算方式以及包含哪些项在不同方法之间可能有很大差异。
- 近端策略优化(PPO)是一种策略梯度方法,它在优化目标的同时,确保策略更新与之前的策略保持”近端”。它通过计算概率比率来实现:$r(\theta) =\frac{\pi_\theta(a \mid s)}{\pi_{\theta_{\text{old}}}(a \mid s)}$,这个比率然后乘以优势估计(通常使用广义优势估计或GAE计算),并应用裁剪操作以防止更新过于偏离旧策略。由此对精心设计的目标进行更新,使得策略变化较大时提供稳定性。
- 人类反馈的强化学习(RLHF)就是在PPO方法的基础上集成了人类偏好数据的一种方法。首先使用人类评注者提供的成对的比较或评分来训练奖励模型。随后的RL阶段使用这个奖励信号来优化模型,通常将其与PPO的技术如裁剪和KL散度惩罚结合起来,以确保渐进的更新。
- DeepSeek-R1的GRPO进一步修改了这一思想,消除了对之前PPO单独价值函数的使用。不依赖于状态价值的外部估计,而是就每个提示词生成一组回复,标准化得到的奖励分之后来计算群体相对优势,简化了架构并减少了计算开销,同时仍能捕获组内回复的差异性。
在强化学习优化算法层面,当前实践形成了一条从通用策略梯度到偏好优化的谱系,包括三类算法家族(PPO、DPO、GRPO)。Clip 通过截断 surrogate objective 在有利方向上的过度变化来提高训练稳定性,并不把 policy ratio 硬限制在某个区间;KL penalty 则用于惩罚当前策略与 reference policy 的偏离。

SFT→RL→OPD:LLM后训练的本质
SFT→RL→OPD:LLM后训练的本质如果把后训练方法放在“分布”这个角度来看会怎样。语言模型说白了就是一个关于序列的概率分布。我们对它做后训练,教它学某个任务,本质上就是在改变这个分布的形状。不同的后训练方法,区别就在于它们怎么改这个分布、把什么当成学习目标,以及这个目标是直接给出来的还是间接推导出来的。
| 维度 | SFT | RL | OPD |
|---|---|---|---|
| 分布动作 | 把模型拉向一个外部分布 | 在模型当前分布附近,寻找奖励更高的区域 | 在学生当前分布经过的区域,用教师信号重新塑形 |
| 目标分布 | 训练前已经固定的外部数据分布 | 满足高奖励的策略集合中,靠近当前策略的分布 | 教师在学生当前状态上给出的分布 |
| 数据从哪里来 | 预先生成的数据集 | 当前模型自己 rollout | 学生模型自己 rollout |
| 学习信号 | 每个 token 的标准答案 | completion 的 reward / advantage | 教师对每个 token 的概率分布 |
| 目标如何给出 | 直接给出完整答案 | 由奖励间接定义 | 教师逐 token 直接给出 |
| 泛化来源 | 模仿教师访问过的状态 | 在自身状态分布中探索并纠错 | 在学生自己的错误状态上接受教师指导 |
- SFT 从几何角度看,它是对一个外部目标的直接牵拉,几乎不考虑 starting policy。这使得它非常适合”冷启动”类任务,即预期输出格式需要被大幅改变的场景。SFT 在整个模型分布上均匀地施加梯度压力,而不仅仅作用在与新任务相关的区域。灾难性遗忘的根源在于:交叉熵损失没有任何内建机制来区分”任务关键 token”和”数据集中偶然出现的伪影”。
- online rl看起来很不一样。模型从自身生成分布中采样;这些样本由某个奖励函数打分;然后模型通过策略梯度更新,以最大化它获得的期望奖励。不存在一个任意的、外部的分布把模型往里拉(PS:估计是往一个特定方向拉的意思)。与 SFT 不同,SFT 在外部数据集上施加逐 token 的压力,RL 主要重塑模型本来就会访问的高概率区域。这种局部性解释了为什么 RL 能提升任务表现,而不会像 SFT 那样对无关能力施加广泛的压力。当然,这一切成立的前提是奖励是有意义的。在 RLVR中,奖励是可验证的,奖励方向通常是”模型质量”的一个相当好的 proxy,因此沿着奖励方向移动,理应能得到一个更好的模型。而在 RLHF 中,奖励模型本身是不完美的,情况就要混乱得多了。
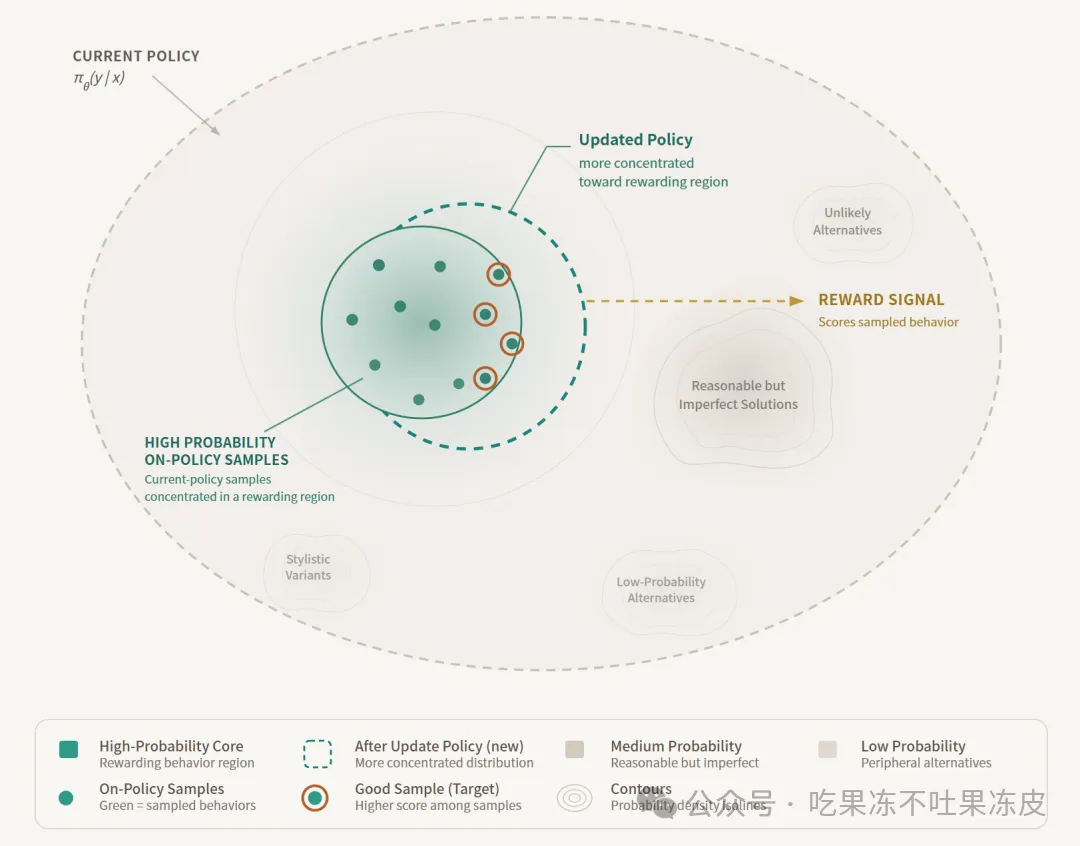
- On-policy distillation(OPD)介于 SFT 和 RL 之间。核心流程只有三步:
- 给定 prompt $x$,student $\pi_\theta$ 自己采样回答 $y \sim \pi_\theta(\cdot \mid x)$。
- 对 student 生成的每个前缀 $c_t=(x,y_{<t})$,teacher $q$ 计算当前 token $y_t$ 的概率。
- 用 teacher 对 student 自己 token 的评价更新 student。$ r_t = \log q(y_t \mid c_t) - \log \pi_\theta(y_t \mid c_t) $
这里的关键术语对应:student模型就是 RL 中的策略(policy),每个被选出的 token 是动作(action),teacher 对该 token 的 log-prob 就是反馈信号。像 SFT 一样,它有教师信号——学生模型被训练去匹配另一个分布;但像 RL 一样,数据来自学生自己。在每一步,算法执行的是 on-policy 采样,但梯度把学生模型拉向与教师分布匹配的方向——通过反向 KL 散度(reverse KL)。粗略地说,OPD 在本质上可以看作一种类似 RL 的过程:只不过 RL 是用 advantage(优势值)对 completion 加权,而 OPD 是用学生与教师之间的 log 概率比来加权。
OPD 和前面方法的核心区别在于两个维度。
- 谁生成训练轨迹:SFT 用 teacher 写的答案,GRPO 用 student自己的探索,OPD 也用 student 自己的轨迹。
- 反馈有多密:GRPO / RLVR 通常是结果级奖励——答案对了给 1 分、错了给 0 分,一个 2000 token 的解题过程只有最后那个 0 或 1;OPD 则几乎每个 token 都有信号,因为 teacher 对每个 token 都能给出 log-prob。
案例
- Qwen2.5的后训练路径是SFT + Two-stage Reinforcement Learning,即PPO->DPO->GRPO。
- TULU 3的后训练路径是SFT->DPO->RLVR。
- DeepSeek-V3的后训练路径是DPO->PPO->GRPO。RM的策略也在不断演进,rule-based RM与model-based RM并重,同时最新的DeepSeek-V3中还使用了self-rewarding策略,使得模型能够不断自我改进。
- Llama 3后训练方法是迭代式的,总共做了6轮。每轮的核心操作是:Reward Modeling,Rejection Sampling,SFT,DPO。
有几点结论:
- GRPO/PPO 与 DPO之争,似乎还没有明确的高下之分。LLaMA偏向DPO,DeepSeek偏向使用GRPO,Qwen则是两者相结合。
- 不管使用GRPO/PPO还是使用DPO, RM都是特别关键的(即便采用DPO进行RL,也需要使用RM进行Rejection Sampling),各个模型每次更新几乎都会提及一些RM的优化点和关键。
- RL阶段几乎是必须的,尤其是对于代码/数学等强推理场景,RL对于模型能力提升起到关键作用。
张俊林:MCST树搜索会是复刻OpenAI O1/O3的有效方法吗 讲的很详细。post-trainning 分为几个阶段,每个阶段准备什么样的数据。尤其是有几张图,很有借鉴意义。
常见技术
拒绝采样(Rejection Sampling)
Rejection Sampling最初来自统计学,解决的是这样一个问题:想从某种分布中抽样,但直接实现这个分布的采样器很困难。能不能先用一个容易实现的采样器,再通过筛选(基于规则或者reward?)得到想要的分布?比如 想从一个目标分布(每个事件的概率为$\frac{1}{7}$)中采样,但直接实现较为困难。于是,我们从另一个易于采样的分布(单次掷骰子,概率为$\frac{1}{6}$)中生成样本。由于该分布无法完全覆盖目标分布,我们通过扩展它(即掷两次骰子),将样本空间扩大到6*6=36种可能性,从而包含目标分布。接下来,按照某种规则丢弃不符合条件的样本(例如,双六的组合)。对于剩余的样本,我们重新调整概率分布(平均分成7组),使其匹配目标分布。最终,接受的样本可以视为从目标分布中采样得到的。
数学解释:假设我们想从一个复杂的目标分布 p(x)中采样,但直接采样难度很高。我们引入一个辅助分布 q(x),它满足:
- 易采样性,我们可以轻松从 q(x)中生成样本。
- 包络条件,存在一个常数 M使得对任意 x,目标分布满足 p(x)≤Mq(x)
步骤:
- 从 q(x)中生成一个候选样本 $x^*$。
- 计算样本的接受概率:$Paccept(x^∗)=p(x^∗)/Mq(x^∗)$
- 生成一个随机数$u∼U(0,1)u$ (从均匀分布中采样)。
- 如果 $u≤Paccept(x^∗)u$,接受这个样本;否则拒绝并重新采样。
拒绝采样LLM 的拒绝采样操作起来非常简单:让自己的模型针对 prompt 生成多个候选 response(rollout?),然后用 reward_model 筛选出来高质量的 response (也可以是 pair 对),拿来再次进行训练。 解剖这个过程:
- 提议分布是我们自己的模型,目标分布是最好的语言模型;
- prompt + response = 一个采样结果;
- do_sample 多次 = 缩放提议分布(也可以理解为扔多次骰子);
- 采样结果得到 reward_model 的认可 = 符合目标分布。 经过这一番操作,我们能获得很多的训练样本,“这些样本既符合最好的语言模型的说话习惯,又不偏离原始语言模型的表达习惯”,学习它们就能让我们的模型更接近最好的语言模型。
RLHF 的优化目标,并不是获得说话说的最好的模型,而是获得 reward_model 和 reference_model (被优化的模型)共同认可的模型。在 RLHF 的训练框架下,reward_model 认为谁是最好的语言模型,谁就是最好的语言模型,人类的观点并不重要。与此同时,即使 reward_model 告诉了我们最好的语言模型距离当前十公里,但 reference_model 每次只允许我们走两公里,所以 RLHF 需要反复迭代进行。
合版方式
- 最土的办法是一人一个榜单方向,贡献sft数据,最后合一起梭哈。
- 高级点的,一人一个后训练模型训,最后adapter权重平均一下。最后总会陷入扯皮,“我这个榜合版前效果还是很好的”。
- OPD/On-Policy Distillation。
- 它同时解决了后训练领域的三个老问题,信号密度低、分布错位、能力干扰。提供了一种在 logit 空间而不是参数空间整合知识的方法。说到底,语言模型的能力,在 logit 空间比在参数空间更容易合并、迁移和保留。
工程
RLHF开源框架主要有DeepspeedChat、Trlx、ColossalAI-Chat,同时在这些框架中会包括一些常用的节省GPU资源,加快训练速度的框架例如Accelerate、PEFT等。在整个RLHF的优化训练中,少则涉及2个模型,多则涉及4个模型(base-model,sft-model,reward-model,ppo-model),超参数较多,训练优化存在较多不确定性。还有一个需要关注的问题,就是RLHF的优化训练耗时较多,少则半月,多则数月才会训练完成,训练资源成本较多。
一键式 RLHF 训练 DeepSpeed Chat(一):理论篇ChatGPT模型的训练是基于InstructGPT论文中的RLHF方式。这与常见的大语言模型的预训练和微调截然不同,目前仍缺乏一个支持端到端的基于人工反馈机制的强化学习(RLHF)的规模化系统,为使RLHF训练真正普及到AI社区,DeepSpeed-Chat应运而生。 一键式RLHF训练 DeepSpeed Chat(二):实践篇 值得细读
PAI-ChatLearn :灵活易用、大规模 RLHF 高效训练框架(阿里云最新实践)
开启训练之旅: 基于Ray和vLLM构建70B+模型的开源RLHF全量训练框架 DeepSpeedChat和LLaMA Factory这些框架往往是基于 ZeRO 等并行方式,将 RLHF 算法中的四个模型切片后放到同一个 GPU 上。在模型规模越来越大的今天,这种调度方式无法满足 70B+ 甚至仅 13B+模型的全量 RLHF 训练,必须通过合并 Actor Critic 模型或者使用 LoRA 等方式妥协内存使用量。而这些PEFT的方式往往意味着模型效果的妥协。
TRL 是由大名鼎鼎的Transformer 针对强化学习专门设计的,旨在打造一个针对大语言模型开展强化学习所用到的全栈类库。提供三阶段训练框架,包括微调训练阶段的SFTTrainer、RM模型训练阶段的RewardTrainer、以及强化学习训练阶段使用的PPOTrainer。 PS:对应训练的LLM的Trainer
数据集格式
Karpathy:当我们为 LLM 创建数据集时,本质上与为它们编写教科书并无二致。为了让 LLM 真正“学会”,我们需要像编写教科书一样,提供这三种类型的数据:
- 大量的背景知识 (Background information): 对应预训练,让模型积累广泛的知识。
- 示范性的例题 (Worked problems): 对应监督式微调,让模型学习高质量的输出。
- 大量的练习题 (Practice problems): 对应强化学习,让模型在实践中学习,通过试错和反馈不断改进。 卡帕西总结道,我们已经让 LLM 经历了大量的“阅读”和“学习例题”,但更重要的是,我们需要引导它们进行大量的“实践练习”。 LLM 需要阅读,更需要实践。 只有通过大量的实践练习,才能真正提升 LLM 的能力,让它们更好地理解世界、解决问题。
数据准备
sft
- 主要数据格式:QA问答
- 适用类型:微调的主要场景,垂直领域应用私有化重点能力
# 带有历史的QA
{
    "instruction": "你是谁?",
    "input": "",
    "output": "我是一个由XXX自主训练的生成式自然语言处理模型,名字为GPT,专门用于回答运维相关问题。",
    "history":[
        [
            "你好",
            "你好呀!请问有什么需要帮助的地方?"
        ]
    ]
}
# 不带历史的QA提问
{
    "instruction": "你是谁?",
    "input": "",
    "output": "我是一个由XXXX自主训练的生成式自然语言处理模型,名字为GPT,专门用于回答运维相关问题。"
}
rm
- 主要数据格式:带有排序的QA方案
- 适用类型:用于SFT后的模型能力增强,训练奖励模型协助对模型结果进行优化符合人类预期
{
    "instruction": "我需要举办6人晚宴。你能帮我推荐三道不包括坚果或海鲜的菜吗?",
    "input": "",
    "output": [
      "好的,我将为您推荐三道不包含坚果或海鲜的菜。这三道菜都是容易做且好吃的家常菜,希望您能满意。\n1. 青椒土豆丝\n2. 西红柿炒鸡蛋\n3. 土豆炖豆角",
      "尖椒干豆腐,土豆丝,红烧肉",
      "如果是六个人,就点八个菜,一般是荤素搭配,凉菜+热菜,两三个素凉,一个肉凉,以及两三个素热,两三个肉热。"
    ],
    "history": []
  }
# 和sft的主要差异在于output中,需要排序给出对应的回答,依次从好到差这样排序
损失函数就定为排序中常见的 pairwise ranking loss。其中$r_{\theta}$是奖励模型的输出标量; $y_w$是一对回答中相对较好的那个; $y_l$是相对较差的那个回答。 \(loss(\theta)=-\frac{1}{\binom{K}{2}} \mathbb{E}_{(x, y_w, y_l) \sim D}\left[\log \left(\sigma\left(r_{\theta}\left(x, y_w\right)-r_{\theta}\left(x, y_l\right)\right)\right)\right]\) PS: 这意思就是 $y_w$ 评分比 $y_l$ 大的越多,loss越小。
DPO\PPO 直接偏好优化
- 主要数据格式:
- 使用类型:直接跳过对应的RM训练过程中,利用数据来完成强化学习操作
{
    "instruction": "解释为什么下面的分数等于 1/4\n4/16",
    "input": "",
    "output": [
      "分数 4/16 等于 1/4,因为分子和分母都可以被 4 整除。将顶部和底部数字都除以 4 得到分数 1/4。",
      "1/4 与 1/4 相同。"
    ]
}
# 在output中有两个答案,分别表示choosen和reject来表示数据是否接收。
基于 LoRA 的 RLHF: 记一次不太成功但有趣的百川大模型调教经历 非常经典。 PS:大模型统一的一个好处是input字段统一,进而数据集格式统一。这不像以前的专有模型,input字段各式各样。数据集格式是什么样子,就侧重训练模型哪些方面的能力。
- sft 数据集/Instruction 数据集。
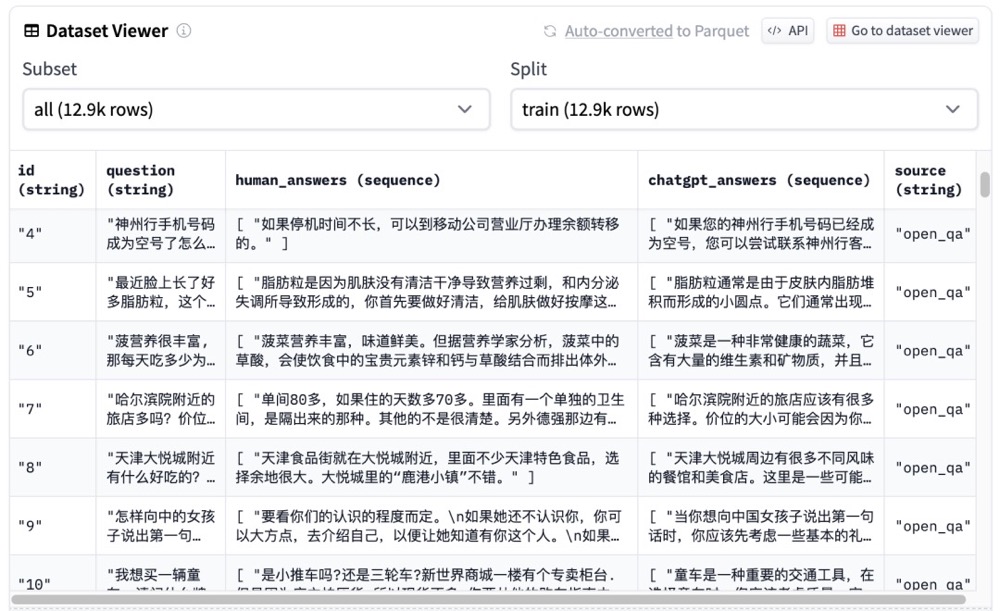
- sft训练之后的大概效果是这样的:
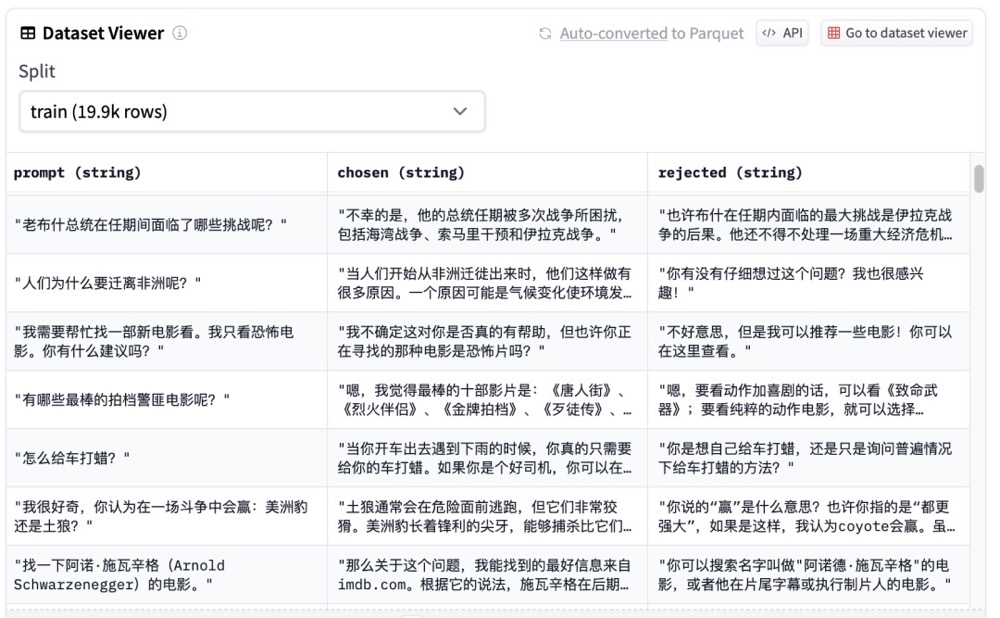
输入: "你是谁开发的啊" 原始 baichuan-7B: "我就是你,我是你自己。(自性)" ChatBaichun-HC3: "我是一个计算机程序,由一个人或一群人编写。我的目的是帮助人们解决问题和回答问题。" - rl 数据集,这个是训练reward model 用的,不是训练sft model 用的。
代码
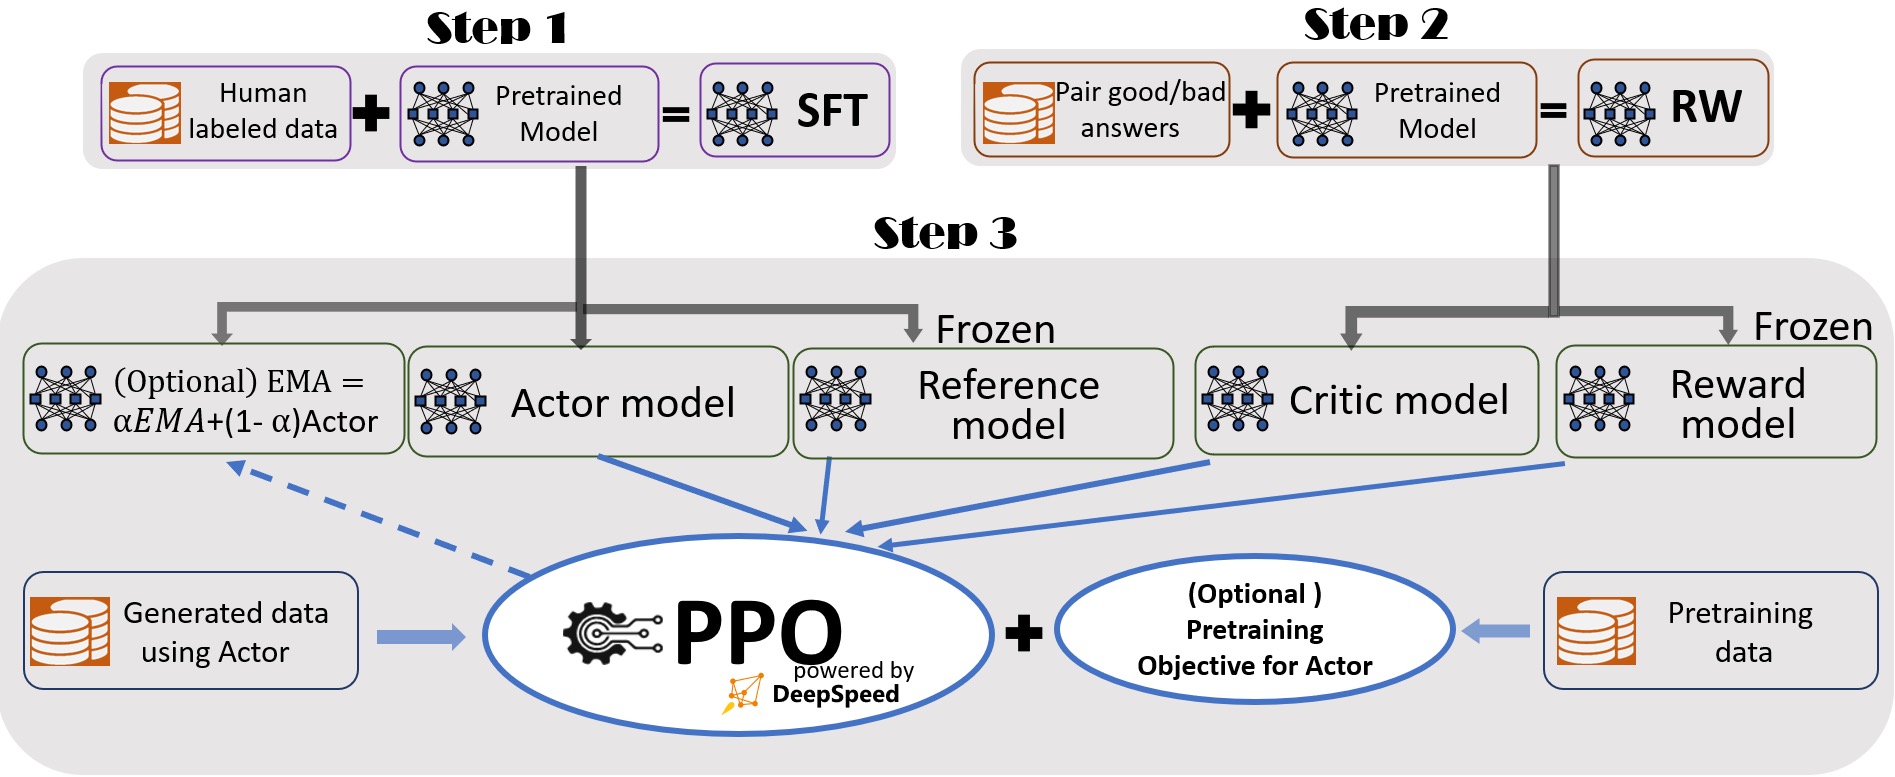
SFT是指令学习, 而RM和PPO合在一起用于RLHF的对齐, 先做SFT,再做RM,最后做PPO
# 训练
experience_list = []
for i in range(epoch):
# 生成模型所需的input_ids
    input_ids = tokenizer.batch_encode_plus(prompt_list, return_tensors="pt",...)["input_ids"]
    experience = make_experience(args, actor_model, critic_model,ref_model,reward_model,input_ids, ...)
    experience_list.append(experience)
    mr = np.mean(np.array(mean_reward))
    actor_model.train()
    critic_model.train()
    ppo_step = update_model(args, experience_list, actor_model, actor_optimizer, critic_model,critic_optimizer, tb_write, ppo_step)
# 模型保存
actor_model.save_pretrained(os.path.join(args.output_dir, "checkpoint-{}".format(ppo_step)))
tokenizer.save_pretrained(os.path.join(args.output_dir, "checkpoint-{}".format(ppo_step)))
def make_experience(args, actor_model, critic_model, ref_model,reward, reward_model, input_ids, generate_kwargs):
    actor_model.eval()
    critic_model.eval()
    with torch.no_grad():
        # 获取prompt内容长度
        prompt_length = input_ids.shape[1]
        # 使用动作模型通过已有提示生成指定内容,其中:seq_outputs为返回序列,包含prompt+生成的answer
        seq_outputs, attention_mask = actor_model.generate(input_ids, **generate_kwargs)
        # 通过动作模型和原始模型同时计算生成结果对应的log_probs
        action_log_probs = actor_model(seq_outputs, attention_mask)
        base_action_log_probs = ref_model(seq_outputs, attention_mask)
        # 通过评判模型计算生成的answer的分值
        value, _ = critic_model(seq_outputs, attention_mask, prompt_length)
        value = value[:, :-1]
        # 通过奖励模型计算生成奖励值,并对奖励值进行裁剪
        _, reward_score = reward_model.forward(seq_outputs, attention_mask, prompt_length=prompt_length)
        reward_clip = torch.clamp(reward_score, -args.reward_clip_eps, args.reward_clip_eps)
        # reward_clip = reward_score
        # 对动作模型和原始模型的log_probs进行kl散度计算,防止动作模型偏离原始模型
        kl_divergence = -args.kl_coef * (action_log_probs - base_action_log_probs)
        rewards = kl_divergence
        start_ids = input_ids.shape[1] - 1
        action_mask = attention_mask[:, 1:]
        ends_ids = start_ids + action_mask[:, start_ids:].sum(1)
        batch_size = action_log_probs.shape[0]
        # 将奖励值加到生成的answer最后一个token上
        for j in range(batch_size):
            rewards[j, start_ids:ends_ids[j]][-1] += reward_clip[j]
        # 通过奖励值计算优势函数
        advantages, returns = get_advantages_and_returns(value, rewards, start_ids, args.gamma, args.lam)
    experience = {"input_ids": input_ids, "seq_outputs": seq_outputs, "attention_mask": attention_mask,
                "action_log_probs": action_log_probs, "value": value, "reward_score": reward_score,
                "advantages": advantages, "returns": returns}
    return experience
def update_model(args, experience_list, actor_model, actor_optimizer, critic_model, critic_optimizer, tb_write,ppo_step):
    # 计算actor模型损失值
    actor_loss = actor_loss_function(experience["action_log_probs"][:, start_ids:],...)
    # actor模型梯度回传,梯度更新
    actor_loss.backward()
    actor_optimizer.step()
    actor_optimizer.zero_grad()
    # 计算critic模型损失值
    # critic模型梯度回传,梯度更新
数据
对模型自我进化的思考与设计作为一位大模型用户,我对大模型有以下几点期待:
- 大模型能越来越懂我(千人千面):比如我今天花了很多时间撰写了一个比较复杂但准确的指令,成功得到了符合预期的回复,第二天我使用一个更为简洁但任务相同的指令也能得到类似的回复,我不想重复写那么复杂的指令。又比如我经常告诉大模型在返回代码的时候不要解释,那么我希望以后即使我没有明确说不要解释,大模型也能够尽量帮我避免给出解释,这样会让我感到惊喜。
- 大模型的回复方式越来越智能(千题千面):比如对于一个比较复杂的问题,大模型能够自动使用CoT模式帮我解答并得出正确的回答,而对于更为简单的问题(即使是相同任务),大模型能够直接给出答复,而不是一直使用CoT形式进行回复,这样会显得很呆。又比如对于一个较难的问题,大模型今天还需要使用很复杂的模式进行回复,一段时间之后就能以更为简洁的方式进行回复,这会让我感觉大模型一直在进步,值得期待。
- 大模型对复杂问题的支持度越来越好:这是对模型的基本要求。
但是,我认为当前的技术架构很难满足期望1和期望2,或者说对人力的要求过大。而对于期望3,目前的智能体、O1是一种解决方案,但智能体或者O1没能和普通模型融合,纳入到一个统一的系统中是一种遗憾。下面解释为什么我认为现行的大模型对齐技术路线无法很好地满足期望1和期望2,无法统一普通模型和专有的智能体模型。目前业内主要采用SFT+RM+DPO/PPO指令对齐技术架构,其主要由以下几个步骤构成:
- 训练一个SFT模型;
- 收集query并抓取SFT(optional :第三方模型、人工撰写)的输出
- 给SFT输出打分(optional:收集开源数据),得到偏好数据
- 在step 3得到的数据基础上训练一个打分模型RM(可以是一个囊括了各种工具的打分系统)(optional: 在偏好数据上训练一个DPO模型)
- 收集query,基于SFT/DPO和RM,训练一个PPO模型
在此框架下,PM或RD一般会预先确定一个输出标准(这一输出标准往往反映在评测数据集上),然后按照这一标准构建SFT、RM(DPO)数据,同时在这一标准下评估各个阶段的模型。比如有些模型喜欢在回复的最后给出一段注释,或者在用户要求给出理由的时候先给出核心答案再给出理由。但是,用一个统一的标准来约束对齐的每个阶段会极大地限制模型的自我进化和对不同需求的满足能力。统一的输出标准天然地限制了大模型的千人千面、千题千面能力,进而也限制了大模型的自我进化和能力的统一。具体来讲,统一的输出标准具有但不限于如下几点问题:
- 不利于输出形式的调整:随着新老用户的交替以及用户对模型需求的变化,模型的期望输出形式也会发生改变。如果模型的输出形式固化,后期调整模型输出形式需要对数据进行大规模的改动——已有数据的退场和新数据的构建。
- 不利于实现千人千面、千题千面:统一的输出形式很难满足不同用户的需求,也无法充分挖掘用户的偏好反馈为将来的千人千面做储备。从任务完成层面来看,即使是同一个任务,不同问题的难易程度不同。对于比较难的问题,模型可能需要使用CoT甚至更复杂的Agent模式进行回复;而对于简单的问题,模型可以直接回复。一致性地采用复杂的输出模式会造成资源的浪费,而一致性地采用简单的回复模式又可能导致模型在一些复杂问题上犯错。
- 不利于模型自我进化:一个比较理想的模型能力进化路径是从复杂模式出发,不断强化模型在简单模式下的能力,不断形成正确性和简洁性的新平衡。固化模型的输出形式会限制了模型的探索能力,不利于模型实现能力的自动进化。
- 不利于在性能上构建护城河:首先,因为无法很好地支持千人千面,导致无法有效形成用户越多-效果越好-用户越多的飞轮,在用户体验上无法和其他平台拉开差异。其次,因为输出的模式化,其他平台可以大规模抓取我方模型的输出,快速对齐我方模型的性能。事实上,如果能让模型从多样化的输出形式出发,引入用户因子,然后逐步根据自身能力收敛输出模式,那么模型的输出就和模型能力进行了深度绑定,第三方模型很难通过抓取该模型的输出来得到和该模型相同的效果。
小结
流程与技术放在一起如下图
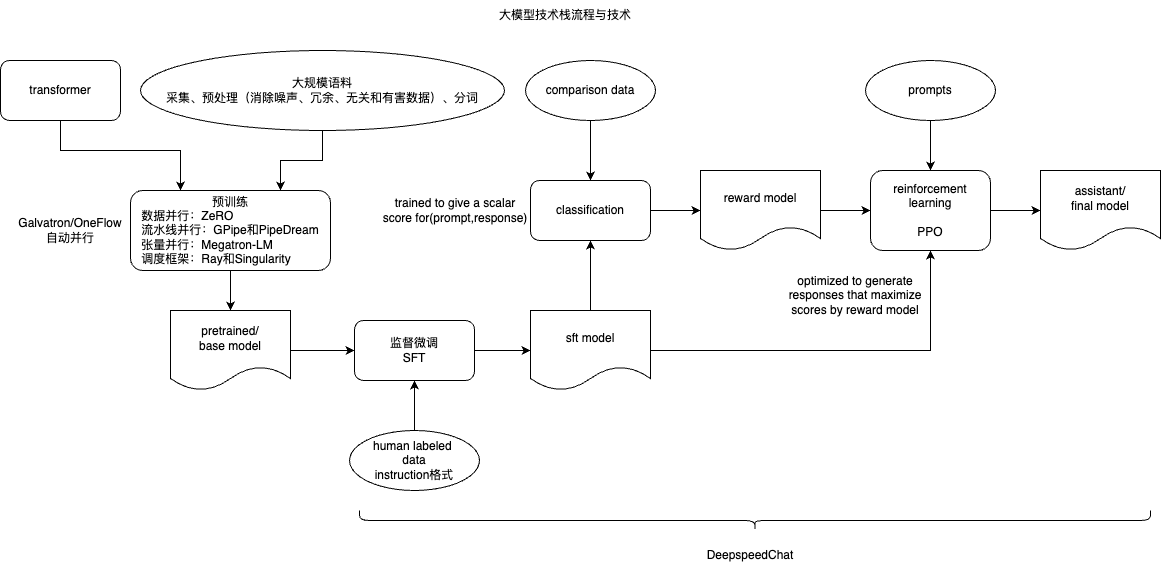
BaiChuan2技术报告细节分享&个人想法 当产出一个新的模型结构时,可以从以上视角、阶段来一一对比。PS: 提示词在不同模型之间,还是有细微差别的,那想要提示词效果比较好,自然需要了解对应模型的细节。
大模型RLHF中PPO的直观理解 未读,有几个图不错。
留下评论