机器人如何生成动作:从动作回归到 Flow Matching
- 简介
- Learning-based approaches
- Action Chunking:生成什么/不要每次只预测一个动作
- 异步推理 asynchronous inference
- Generalist Robot Policies
- Robot (Imitation) Learning 示范给机器人看,让它学会一个任务。
简介
自 20 世纪 50 年代机器人学诞生以来,该领域一直受到广泛研究。近年来,机器学习(ML)的进步推动了一类相对较新的方法的发展,这些方法利用大量数据和计算资源来解决机器人学问题,而非依赖人类的专业知识和建模技能来开发自主系统。机器人学研究的前沿确实正日益脱离传统的基于模型的控制范式,转而拥抱机器学习的进步,旨在实现
- 从感知到动作的一体化控制流程;
- 多模态的数据驱动特征提取策略
- 减少对精确世界模型的依赖;
- 更好地把握利用日益丰富的开放机器人数据的机会。
作为一个仍处于相对初期阶段的领域,目前没有任何主流技术被证明在domain of robot learning明显优于其他技术。尽管如此,两大类方法已崭露头角:强化学习(RL)和Behavioral Cloning(BC)
Learning-based approaches
Learning-based approaches to robotics are motivated by the need to
- 在不同任务和具身形态之间实现泛化
- 减少对人类专业知识的依赖
- leverage historical trends on the production of data
Robotics is concerned with producing artificial motion in the physical world in useful, reliable and safe fashion. Thus, robotics is an inherently multi-disciplinar domain: producing autonomous motion in the physical world requires, to the very least, interfacing different software (motion planners) and hardware (motion executioners) components. Methods to produce robotics motion
- Explicit models vs dynamics-based,基于动力学的方法,利用对机器人刚体力学及其与环境中潜在障碍物相互作用的精确描述
- implicit models vs learning-based methods. treating artificial motion as a statistical pattern to learn
绝大多数情况下,Robotics致力于通过驱动连接近乎完全刚性的链接的关节来产生运动。传统方法怎样让机器人动起来,会遇到什么困难?以 SO-100 固定几个关节,只留下肩部、肘部的运动(简化成平面里的“两根杆、两个转轴”)为例
- 程序控制的是两个关节角度:$q=[\theta_1,\theta_2]$,而任务关心的是夹爪的位置:$p=[x,y]$,首先要解决这两种表达之间的转换:知道关节角度,能算位置(正运动学/Forward Kinematics);知道目标位置,要反过来求角度(逆运动学/Inverse Kinematics)。
- 算出终点姿势,“怎么走过去”。实际执行时,问题一层层增加:
- 给求解加入约束。桌面和障碍物限制了哪些姿势可行。
- 轨迹规划。终点姿势可行,不代表走过去的路径不会碰撞。
- 要沿路径平滑运动,还要计算关节速度,由此引入 Jacobian 和 微分逆运动学/Differential IK。其中,微分逆运动学的核心关系是:$\dot p=J(q)\dot q$,当前姿势下,各关节的转速$\dot q$(单位是 rad/s)怎样共同决定夹爪的移动速度$\dot p$(单位是 m/s)。Jacobian $J(q)$ 就是这两种速度表达之间的局部转换关系。
- 实际位置与预计位置有偏差,或者障碍物移动了,还要根据观测不断纠正,引入反馈控制。 所以,“把夹爪移过去”背后,其实是一整套建模、求解、规划、反馈纠偏的程序。
“把夹爪移动过去”是一套持续规划、执行、观测和纠偏的过程。
- 哪些东西能从数据中学?即使只有两个活动关节,加入现实约束后,也已经需要不少人工建模和工程设计。换机器人、换任务、增加复杂接触,还会带来新的适配工作。能否让机器从示范或试错中学会一部分感知到动作的映射,减少逐项设计这些规则和模型的负担?
- 真实物理过程很难建模准确。两根刚性杆的几何关系比较好写;抓东西时的摩擦、接触,以及布料等柔性物体的变化,就难以用简单模型准确描述。
- 更多数据不会自动让系统变强。收集了一万条成功操作记录,手工设计的规划器和控制器不会仅仅因为这些数据存在,就自动掌握更多技能;需要引入利用数据学习的机制。
Learning-based technique通常依赖单体式的预测到动作流水线(视觉运动策略),可直接将感觉运动输入映射为预测动作,通过消除与多个组件对接的需求来简化控制策略。将感觉输入映射为动作,也使得纳入多种输入模态成为可能,并能利用现代学习系统的自动特征提取能力。此外,基于学习的方法原则上可以完全绕过显式建模,转而仅依赖交互数据——当动力学难以建模或完全未知时,这一优势将带来变革性影响。最后,learning for robotics (robot learning) 天然适合利用日益增多且可公开获取的robotics data,正如计算机视觉和自然语言处理在历史上受益于大规模数据语料库一样。
由于机器人控制问题本质上具有交互性和序列性, robotics control problems can be directly cast as RL problems. 强化学习是机器学习的一个子领域,主要关注自主系统(agents)的开发,使其能够在不断变化的环境中持续行动,并制定(理想情况下表现良好的)控制策略(policies)。对机器人学而言,至关重要的是,强化学习智能体通过试错不断改进,绕过问题环境动力学的显式模型,转而利用交互数据。In RL, this feedback loop between actions and outcomes is established through the agent sensing a scalar quantity (reward) measuring how desirable a given transition is for the accomplishment of its goal.
Streamlined end-to-end control pipelines, data-driven feature extraction and a disregard for explicit modeling in favor of interaction data are all features of RL for robotics. However, RL still suffers from limitations concerning safety and learning efficiency, particularly pressing for real-world robotics applications.首先,尤其是在训练早期,动作通常具有探索性,因此可能难以预测。在物理系统上,未经训练的策略可能会发出高速度指令、导致自碰撞的配置,或超过关节限制的扭矩,从而造成磨损并可能损坏硬件。缓解这些风险需要外部保护措施(例如看门狗、安全监控器、急停装置),而这往往需要大量人工监督。其次,在强化学习中,高效学习仍然是一个难题,因此训练所需的时间尺度往往高得令人望而却步,限制了强化学习在现实世界机器人学中的适用性。强化学习用于robotics时,一个或许更根本的局限是,通常无法获得复杂任务的稠密回报函数;这类函数的设计本质上依赖于人类的专业知识、创造力和反复试错。在实践中,稀疏回报函数可用于判断某个特定目标是否已经达成——这件T恤是否已经正确折叠,尽管已取得显著成功,但由于监督减少,通常会导致学习速度慢得多,即使是成功检测本身,往往也需要定制仪器。sample-efficient learning也至关重要,因为在真实世界中训练本质上受时间瓶颈限制。
Action Chunking:生成什么/不要每次只预测一个动作
最初的模型是:$o_t\longrightarrow a_t$,Action Chunking 改成:
\[o_t\longrightarrow A_t=(a_t,a_{t+1},\ldots,a_{t+H-1})\]也就是根据当前观测,一次预测接下来 (H) 步的动作序列。这样更容易一起表达“持续向左绕过去”这样的连贯行为,而不是每一步都重新猜一次。
如何学习/预测动作块?ACT 全称 Action Chunking with Transformers。可以先把它理解成三个部件:
- Action Chunking:输出一段动作。
- Transformer:组织图像、关节信息,预测动作序列。
- Conditional VAE:帮助模型表示示范中不同的动作风格或变化。
异步推理 asynchronous inference
机器人执行动作需要连续,而模型生成动作块需要时间。如果每次都是:动作执行完 → 停下来等模型 → 再执行。机械臂可能一顿一顿。
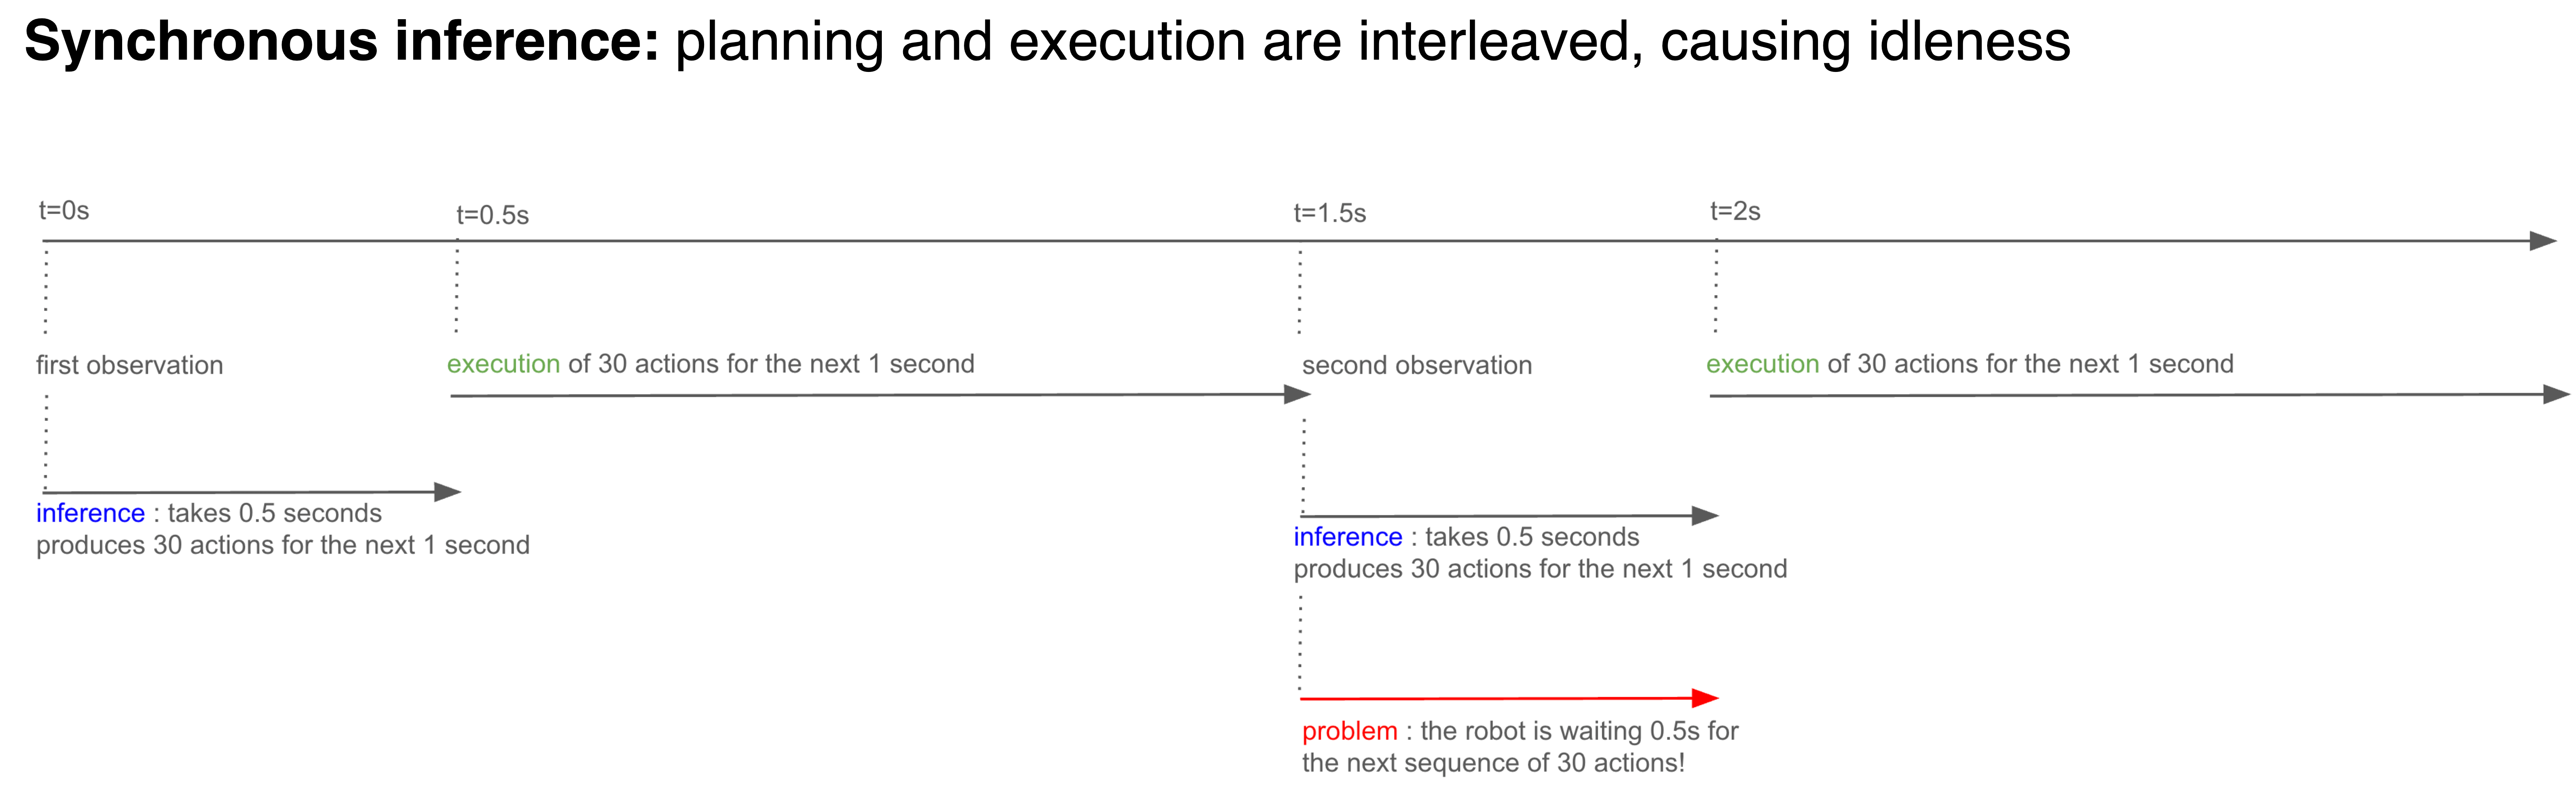 控制端Robot Client持续消费已有的动作队列。推理端Policy Server (possibly hosted on GPU) 提前根据新观测生成下一块动作。新结果回来后,按执行时间对齐、更新队列。异步不是让模型算得更快,而是让计算时间与执行时间重叠。
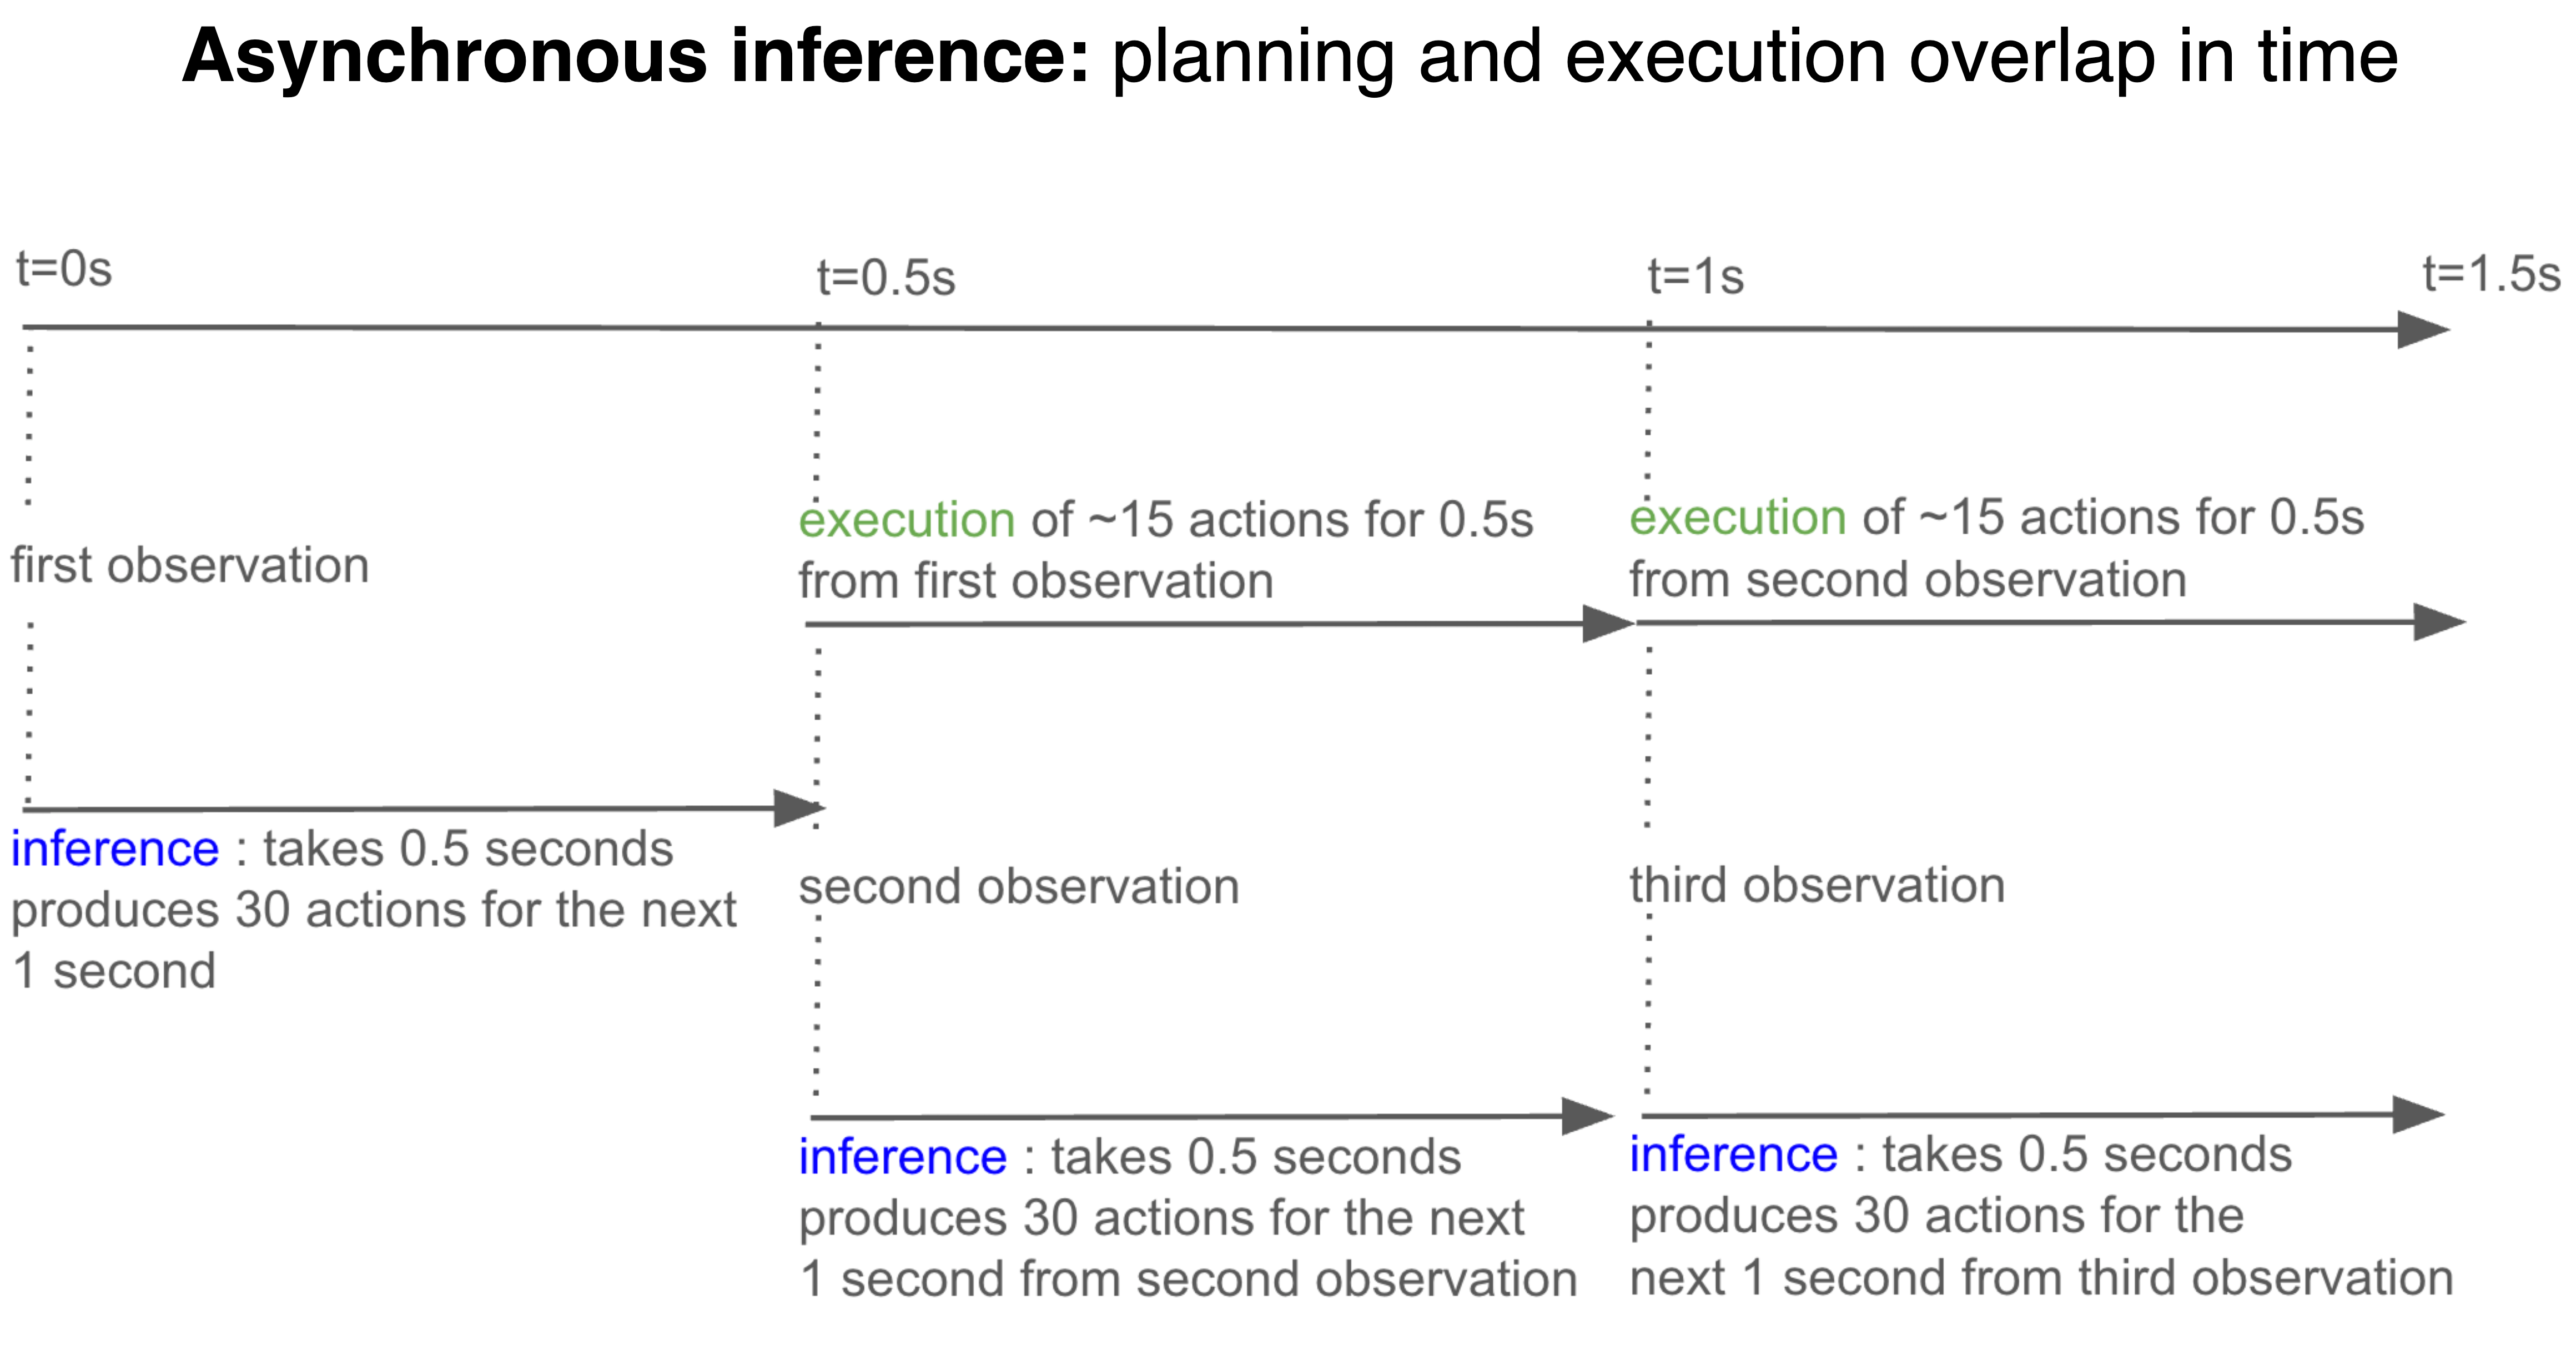
将动作预测与动作执行解耦,动作块推理可以在独立的机器上运行,而该机器通常配备比机器人机载资源更好的计算资源。在异步推理中,机器人客户端将时刻t的观测o发送给策略服务器,并在推理完成后通过网络接收一个动作块$A_t$。
Generalist Robot Policies
能不能像训练大语言模型一样,先训练一个有广泛能力的模型,再让它适应不同任务、场景和机器人?大规模预训练 → 用少量目标任务数据微调。但机器人比 LLM 多一道困难:数据和“身体”(embodiment)绑在一起。文本可以由不同的人写,却共用一套文字表达;机器人数据里,同样一个动作向量,在六轴机械臂和双臂机器人上可能根本不是一个意思。摄像头位置、关节数量、动作单位也可能不同。
Vision-Language-Action,VLA。借用了预训练 VLM 已有的视觉和语言知识。 | 模型 | 输入 | 输出 | |—|—|—| | VLM | 桌面图片+“红杯子在哪里?” | “在盒子左边” | | VLA | 桌面图片+“把红杯子放进盒子”+机器人状态 | 一段机器人动作 |
VLA利用 VLM 已经学到的视觉和语言知识,再通过机器人数据学会把这些知识落实为动作。 \(A_t \sim p_\theta(A_t\mid I_t,q_t,\ell)\)
其中:
- $I_t$:相机画面。
- $q_t$:关节位置等机器人自身状态。
- $\ell$:语言/任务指令。
- $A_t=(a_t,\ldots,a_{t+H-1})$:未来一段动作,而不是一个文字答案。
LLM 输出词表里的 token,机器人究竟输出什么?如何把大模型的表示能力连接到机器人的动作空间?
- 把连续动作离散化,变成 token。例如,把某个动作分量的数值范围切成 256 档,模型预测该选哪一档。这样就能借用分类、token 预测的训练方式。RT-2、OpenVLA 是这条路线的代表。
- 保留连续动作,用专门的生成模型输出。
- VLM Backbone:处理图像和语言,提供场景与任务的表示。
- Action Expert:结合这些表示、机器人状态,用 Flow Matching 生成动作块。 但它不必先写出一段文字计划,再交给另一个模型翻译成动作。两个部分通过 Attention 在内部特征层面交换信息。
一轮推理大概是
context = vlm.encode(images, instruction)
action_chunk = action_expert.generate(context, robot_state)
robot.execute(action_chunk[:execute_steps])
# 获取新观测,继续下一轮
本体信息远比“关节数量 + 电机型号”复杂。相同的零件,用不同方式组装,就会形成不同的身体,也需要不同的控制方式。一个关节角度向量:$q=[0.2,\,-0.5,\,0.8,\ldots]$ 脱离身体结构和关节顺序约定,并不能唯一说明机器人摆出了什么姿势。 同一组数,放在狗型与人型机器人上,可能对应完全不同的姿态。
机器人领域 URDF是一种描述身体结构的格式:用 link 表示刚性部件,用 joint 描述连接关系,并记录几何、惯性等属性。
可以把一个通用策略写成: \(A_t\sim p_\theta \left( A_t\mid \text{图像},\text{指令},\text{当前状态},\text{本体信息} \right)\)
Robot (Imitation) Learning 示范给机器人看,让它学会一个任务。
Behavioral Cloning (BC)sidesteps these constraints by casting control an imitation learning problem,绕开了这些限制,并利用先前收集的专家示范来锚定所学习到的自主行为。最值得注意的是,通过模仿学习,自主系统能够自然地遵循数据中隐含编码的目标、偏好和成功标准,从而减少早期探索失败,并完全免去人工设计reward shaping。
机器人控制,也可以是监督学习
既然人能够示范“看到这个场景时应该怎么操作”,能不能把这些操作当成 Label,用监督学习训练一个机器人控制程序?这是BC的出发点,BC 是设法把机器人控制变成一个SL问题(给输入,也给期望输出)。比如你通过遥操作控制机械臂,成功完成几十次搬积木。系统同步记录:
- 输入 Observation,摄像头画面、当前关节位置等。
- 示范动作 Action,人在这一刻发出的控制指令:例如各关节的目标位置,以及夹爪开合指令。
于是我们得到了 $\mathcal D={(o_t,a_t^{\text{expert}})} $ ,训练一个网络:$\hat a_t=f_\theta(o_t) $
用熟悉的回归损失:
\[L(\theta) = \mathbb E_{(o,a^{\text{expert}})\sim\mathcal D} \left[ \|f_\theta(o)-a^{\text{expert}}\|^2 \right]\]人类示范的动作,就是这里的 Label。没有 Reward,也不需要 Policy Gradient。部署时则循环执行:
while running:
    observation = read_cameras_and_joints()
    action = policy(observation)
    robot.execute(action)
直接回归动作有哪些局限?
- 预测结果会改变下一次输入。动作预测偏了一点 → 机械臂走偏了一点 → 下一帧画面变了 → 模型面对一个示范数据里没见过的场景 → 继续预测错误。 它学会了顺利时怎么做,却未必学会偏离之后怎么补救。这叫 Distribution Shift / Covariate Shift,连续执行时会产生 Compounding Errors,误差累积。所以:单步动作预测误差很小,不等于整段任务成功率很高。
- 同一场景可能有多个正确答案。假设积木前面有一个障碍物:有些示范从左边绕,有些示范从右边绕。两种都正确,如果用平方误差训练一个只能输出单个动作的回归器,它倾向于预测条件平均值,但“左绕”和“右绕”的平均,可能恰好是“直直撞上去”。
针对同一场景下存在多个合理动作的问题,我们可以从:“给定场景,预测一个动作数值”(point-estimate policies),转向:“给定场景,学习哪些动作可能是合理的,以及它们各自的分布”(Generative BC),即:$a\sim\pi_\theta(a\mid o)$,理想情况下,这个分布在“向左绕”和“向右绕”附近都有较高概率,在“撞向障碍物”附近概率很低,生成时选择其中一种合理方案,而不是强行输出两者的平均。
向左绕:49%
向右绕:49%
往前撞: 2%
Diffusion Policy 根据眼前情况,生成一段合理动作
扩散模型已被证明在逼近复杂的高维分布方面非常有效,例如图像或视频上的分布,也可以用于robot learning, leveraging diffusion to model expert demonstrations in a variety of simulated and real-world tasks.
待生成的样本从图片换成 Action Chunk,条件信息换成当前图像、机器人状态等 observation。训练时,向专家动作块添加不同程度的 noise,让模型学习预测所添加的 noise;生成时,从一个随机动作块开始,在 observation 的条件下逐步去噪,得到动作序列。
Flow Matching:根据当前观测生成 Action Chunk
robot Flow Matching,我们要学习的是条件分布 $p(A\mid c)$:给定当前观测和任务,哪些动作序列是合理的。
对于动作生成,真实样本不再是一个数字,而是一段专家动作:
\[A_1\in\mathbb R^{H\times D}\]其中,$H$ 是预测的动作步数,$D$ 是每一步的动作维度。例如,预测未来 20 步、每步控制 6 个关节,那么一个 Action Chunk 就包含 $20\times6$ 个数。同时,模型还需要知道当前任务和机器人所处的状态。把语言、图像、身体状态等条件信息记作 $c$,模型变为:
\[v_\theta(A_t,t,c)\]训练时,从示范数据中取得条件 $c$ 及其对应的专家 Action Chunk $A_1$,再与同形状的 noise $A_0$ 构造中间样本,学习如何更新动作序列。生成时,固定当前条件 $c$,从 noise 开始逐步更新,最终得到适合当前任务和观测的 Action Chunk。
训练:把专家动作块转成速度监督
以机器人实际时刻 $k$ 为例,条件 $c_k$ 包含当前图像、关节状态,以及 VLA 使用的语言指令;专家动作块则取自同一段示范,从这个时刻开始的连续 $H$ 步:
\[A_1=(a_k^{\text{expert}},a_{k+1}^{\text{expert}},\ldots,a_{k+H-1}^{\text{expert}})\]这里的 $A_1$ 表示生成进度为 1 时的目标动作块。关节状态记录机器人实际处于什么位置,专家动作记录希望机器人接下来执行什么控制目标,两者不能混为一谈。
采用直线插值的训练方式时,抽取与专家动作块形状相同的 Gaussian noise $A_0$,再随机选取生成进度 $t$,构造模型输入和目标速度:
\[A_t=(1-t)A_0+tA_1,\qquad U=A_1-A_0\]模型根据 $(A_t,t,c_k)$ 预测整个动作块的变化速度,用下面的误差训练:
\[\mathcal L(\theta)= \mathbb E_{(c_k,A_1)\sim\mathcal D,\,A_0,\,t} \left[ \left\|v_\theta(A_t,t,c_k)-(A_1-A_0)\right\|^2 \right]\]专家动作块用于构造中间样本和监督目标,不作为额外输入直接交给模型。模型需要结合当前观测和任务,学会如何更新带噪动作块。这仍然是在做 Behavior Cloning,Flow Matching 提供了具体的动作分布学习目标。
生成:先得到动作块,再交给机器人执行
实际推理时没有专家动作块。固定本轮的条件 $c_k$,从新的 noise 开始,反复调用同一个模型。以 Euler method 为例:
\[A_{t+\Delta t}=A_t+\Delta t\,v_\theta(A_t,t,c_k)\]到 $t=1$ 时,得到预测的动作块 $\hat A_1$。同一观测下,从不同 noise 出发,可以生成不同的合理动作序列,例如完整的左绕或右绕方案。
虽然这里仍然使用 MSE,模型回归的是给定中间样本和生成进度下的局部速度,而不是只根据 observation 回归唯一的最终动作块。局部速度的条件平均不等于最终动作的条件平均,因此这种训练方式可以表达多峰动作分布。
这里有两个不同的时间维度:
| 时间维度 | 含义 |
|---|---|
| Flow time:$t$ | 一整个 Action Chunk 从 noise 变成动作预测的生成进度 |
| Action Chunk 内的步数 | 机器人未来执行动作的物理时间顺序 |
一次 Flow 更新,会更新整个 Action Chunk,而不是让机器人执行其中一步。 模型预测的 velocity 也是动作序列在生成过程中的变化率,不应直接理解为关节的物理转速。
生成完成后,机器人运行时才按实际控制周期执行动作。系统可以先执行其中一部分,再根据最新观测生成下一段,从而形成“观测 → 生成 → 执行 → 再观测”的闭环。
留下评论