用户语言如何转换为机器人动作
简介
Robots still struggle to generalize across diverse objects, environments, and tasks.This limited progress stems from a lack of high-quality, diverse data and the absence of models that can reason and act like humans in the physical world. 机器人该以什么为单位、什么表征、什么结构,把”看见的世界”变成”该做的动作”?
难点
机器人的”大脑”必须同时做到三件事——看懂世界(感知)、想象后果(世界建模)、输出动作(控制),但这三项能力对架构的要求互相打架:感知要快、想象要准、控制要稳,而且每一步决策都必须被压在毫秒级、毫焦级、低显存的计算预算内。我们想让机器人模型在真实物理世界里可靠地长程操作,但
- “看/想/做”三种能力对架构的要求互相冲突;
- 世界模型的”预测未来”能力与”实时控制”成本难以兼得,且像素预测 ≠ 物理理解;
- 历史记忆的多与少、稠与稀、显与隐存在根本权衡;
- 学习单位(chunk/事件/关键帧)与计算预算(固定/自适应)必须在语义对齐和工程成本之间做选择。
有几条路线
- 分层(Hierarchy)规划与控制,把”想”和”做”切开,根据动作表达粒度的不同又分为
- 语言 → LLM → Command/Skill(结构化指令) → 运动 Policy → 动作。
- 分层规划与控制,语言 → LLM → 自然语言子任务 → 运动 Policy → 动作。
- Flat VLA,语言 + 图像/身体状态 → VLA → 动作
如何屏蔽不同microduck 舵机和身体的差异
GPT-3.5推出之前NLP领域,那时,Pretrained Model/Foundation Model已经出现,但情感分析、信息抽取、问答等任务,仍经常需要各自的数据、微调模型和专门接口。当前机器人策略仍具有较强的 embodiment dependence(身体依赖性)。基础模型正在提高跨任务与跨身体的知识复用,但对新身体的可靠控制,往往仍需要接口适配、目标身体数据微调,或经过训练的在线适应机制。且机器人的统一更困难:不同 NLP 任务大多共享文本输入输出,而不同机器人不仅动作接口不同,同一个动作产生的物理结果也不同。
| 差异 | 主要处理方式 |
|---|---|
| 舵机品牌、通信协议、设备 ID | SDK、硬件 adapter 封装 |
| 零点、转向、单位、关节顺序 | 标定与动作转换 |
| 力矩、响应延迟、摩擦、重量略有变化 | 仿真参数辨识、Domain Randomization、必要时微调 |
| 腿明显更长、重心变化、关节布局变化 | 更新身体模型,并重新训练或适配策略 |
VLA(Vision-Language-Action model)
VLA aim to unify perception, language understanding, and action prediction within a single architecture. VLA 通常以原始视觉观测和自然语言指令为输入,输出相应的机器人动作。
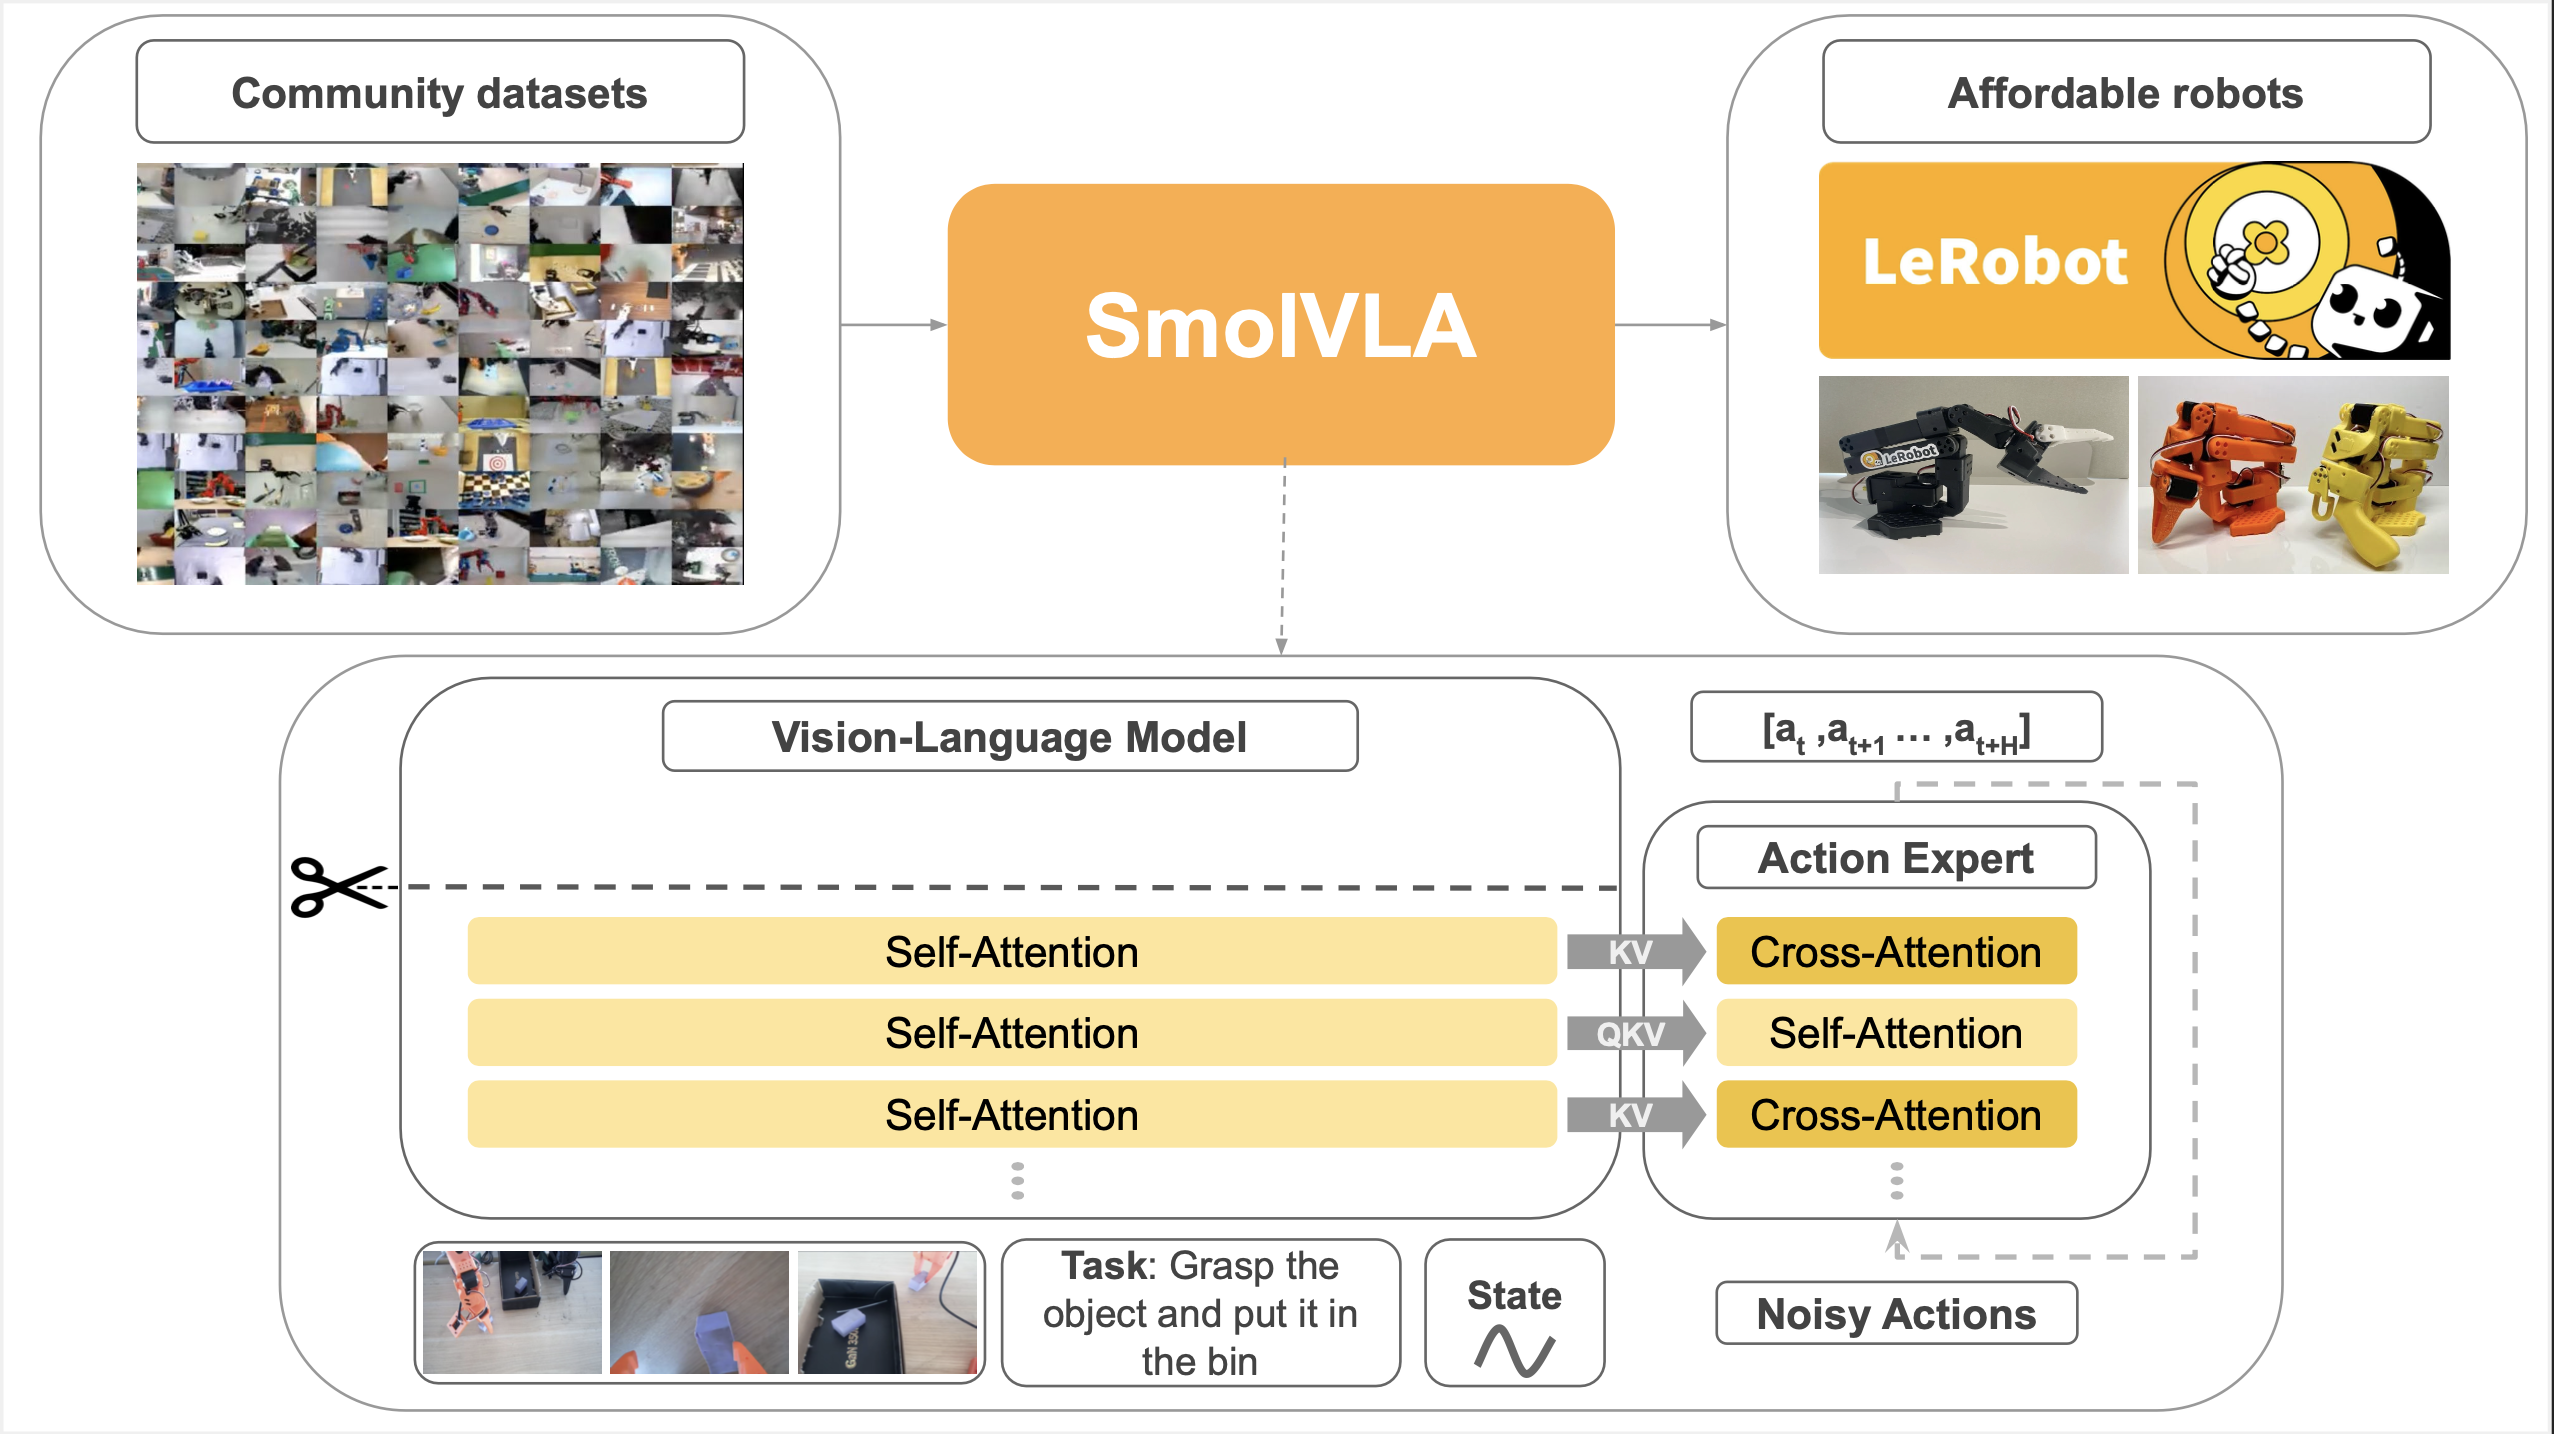
SmolVLA 是约 450M 参数的预训练模型,支持输入自然语言、图像和机器人状态,输出 Action Chunk,适合用来验证“语言与观测直接生成动作”的流程。SmolVLA 主要由两部分组成:
- 视觉语言骨干(VLM):提取图像与语言特征,结合身体状态形成动作生成所需的条件信息。SmolVLM 是一个开源2B 的VLM。SmolVLM - small yet mighty Vision Language Model
- multimodal AI 发展趋势先是扩大计算规模,随后通过利用大模型生成合成数据来提升数据多样性,而近期则转向轻量化,以提高这些模型的运行效率。小型开源模型支持在浏览器或边缘设备上本地部署,不仅降低了推理成本,还能实现用户自定义定制。
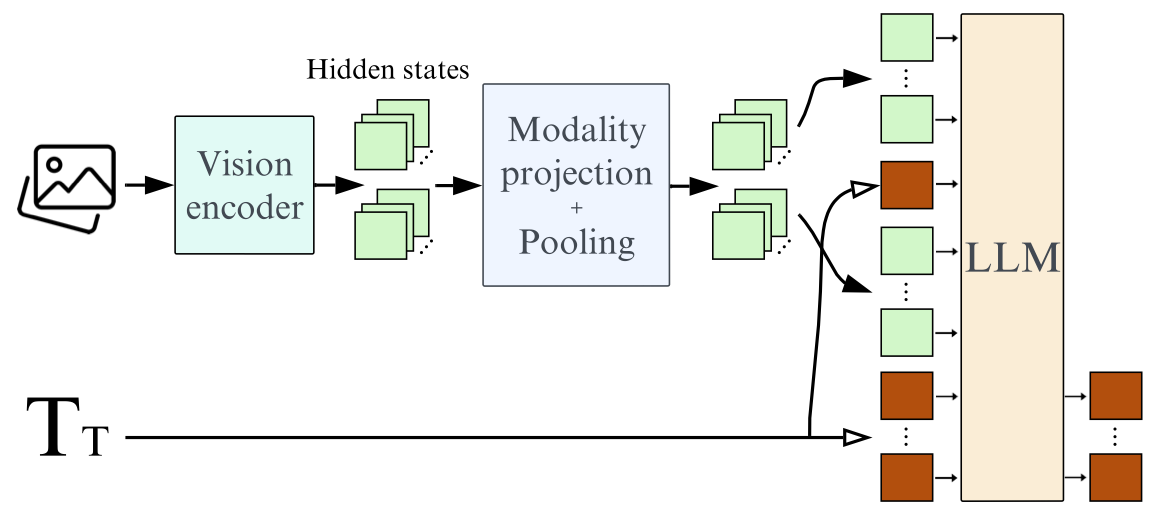
- multimodal AI 发展趋势先是扩大计算规模,随后通过利用大模型生成合成数据来提升数据多样性,而近期则转向轻量化,以提高这些模型的运行效率。小型开源模型支持在浏览器或边缘设备上本地部署,不仅降低了推理成本,还能实现用户自定义定制。
- 动作专家(Action Expert ,~100M parameters)):根据这些信息,生成未来一段时间的连续动作序列,采用 Flow Matching 训练。
为了让实时机器人技术更易用,我们推出了一套异步推理栈。该技术将机器人执行动作的方式与它们感知视听信息的方式分离开来。SmolVLA takes as input a sequence of RGB images from multiple cameras, the robot’s current sensorimotor state, and a natural language instruction. The VLM encodes these into contextual features, which condition the action expert to generate a continuous sequence of actions.
生成action chunk
SmolVLA’s action expert is a compact transformer (~100M parameters) that generates action chunks conditioned on the VLM’s outputs. It is trained using a flow matching objective, which teaches the model to guide noisy samples back to the ground truth. 相比之下,离散动作表示法(例如通过分词实现)虽具备强大性能,但通常需要自回归解码,这会导致推理过程缓慢且效率低下。而流匹配技术则支持对连续动作进行直接、非自回归的预测,从而实现高精度的实时控制。
LLM 通常输出词表中的 Token,而机器人需要的可能是关节位置、末端位姿增量、夹爪开合量等连续数值。举一个简化例子:两关节机械臂,预测未来三个控制时刻的目标角度:
            关节1    关节2
未来时刻1    0.10     0.30
未来时刻2    0.15     0.25
未来时刻3    0.20     0.20
这是一个 3 × 2 的 Action Chunk。问题变成:怎样让预训练模型生成这个矩阵?
- 将连续动作离散化为 Token,一次输出一个关节在一个时刻的action token,并自回归生成。 当然也有把多个动作值压缩成 Token 的方案。
- 比如 关节的角度范围都是
[0, 1.28)rad,均匀划分成 256 个区间,每个区间宽:1.28 / 256 = 0.005 rad,比如bin_0 对应[0.000, 0.005),bin_60 对应[0.300, 0.305),模型输出 Action Token,通过预先约定的映射转成 bin_id,最后换算成角度。 - 训练时,先把专家示范中的动作数值量化为离散区间,再按约定顺序编码成 Token 序列,训练模型预测下一个动作 Token。
- 推理时,模型逐个生成 Token(先生成关节 1 的 Token,才能生成关节 2 的 Token),随后解码为连续动作值。若每个关节在每个时刻对应一个 Token,包含 H 个时刻、D 个关节的动作块,就需要约 H × D 个动作 Token。
- 直接生成连续的动作矩阵。SmolVLA 保留 VLM 对图像、语言和身体状态的处理能力,再用 Action Expert 生成连续动作。两者之间传递的是特征张量,不需要先生成一段文字计划。Flow Matching 的直觉,可以理解为:学习怎样把一个随机矩阵,逐步变成符合当前任务和观测的动作矩阵。
- 训练时,将专家动作与随机噪声按随机比例混合,得到中间动作矩阵;让模型结合任务和观测,预测这条噪声到动作路径上的变化速度,并用真实速度作为监督信号。
- 推理时,从随机噪声矩阵开始,模型反复预测整个矩阵的变化速度,通过数值积分逐步得到最终 Action Chunk。非自回归指不逐个生成动作 Token,并不意味着只需一次模型计算。
未知
在训练过程中,我们会向机器人的真实动作序列添加随机噪声,然后让模型预测出能将这些序列恢复到正确轨迹的“correction vector”。This forms a smooth vector field over the action space, helping the model learn accurate and stable control policies.We implement this using a transformer architecture with interleaved attention blocks, and reduce its hidden size to 75% of the VLM’s, keeping the model lightweight for deployment.
- Cross-attention (CA), where action tokens attend to the VLM’s features
- Self-attention (SA), where action tokens attend to each other (causally—only to the past)
CA ensures that actions are well-conditioned on perception and instructions,while SA improves temporal smoothness—especially critical for real-world control,where jittery predictions can result in unsafe or unstable behavior.
现代视觉运动策略输出动作块——即需要执行的动作序列。管理这些动作块有两种方式:
- synchronous (sync): The robot executes a chunk, then pauses while the next one is computed. Simple, but causes a delay where the robot can’t react to new inputs.
- Asynchronous (async): While executing the current chunk, the robot already sends the latest observation to a Policy Server (possibly hosted on GPU) for the next chunk. This avoids idle time and improves reactivity.
Our async stack decouples action execution from chunk prediction, resulting in higher adaptability, and the complete lack of execution lags at runtime. It relies on the following key mechanisms:
- Early trigger: When the queue length falls below a threshold (e.g., 70%), we send an observation to a Policy Server, calling for a new action chunk.
- Decoupled threads: Control loop keeps executing → inference happens in parallel (non-blocking).
- Chunk fusion: Overlapping actions from successive chunks are stitched with a simple merge rule to avoid jitter. In short, async inference keeps the robot responsive by overlapping execution and remote prediction.
工程
SmolVLA 先在通用操作数据上进行预训练,随后开展任务特定的后训练。
长期:人形机器人和 Microduck 能共用吗?
PS: 对同一种构型的机器人,能搞定一个机制 部件、尺寸等差异已经有很大价值了。 沉淀下来的思路/方法论、框架等迁移成本并不是很高。
把动作向量从 14 维补齐到更多维,解决不了动作语义和动力学差异。
- 框架可以共用:数据格式、训练流程、推理服务。
- 部分模型参数可以共用:例如视觉、语言 backbone
留下评论