经典强化学习:基本概念与学习直觉
简介
强化学习(reinforcement learning)领域的奠基人之一理查德·萨顿:从 70 年的 AI 研究中可以得出的最大教训是:利用计算能力的通用方法终将是最有效的,而且会遥遥领先。为什么说它”苦涩”?因为同样的故事在 AI 历史上一遍又一遍地上演。在计算机国际象棋中,研究者精心编码开局定式和残局策略,结果被暴力搜索的深蓝击败;在语音识别和计算机视觉中,人们手工设计特征提取器,结果被从数据中自己学特征的深度网络全面取代。围棋更是登峰造极——研究者投入巨大精力利用人类知识来减少搜索量,而 AlphaGo Zero 干脆去掉一切人类输入,从零自我对弈,反而下得更好。萨顿总结道:研究者总是试图让系统按照他们认为人类心智运作的方式去工作,但最终这被证明是适得其反的。 真正推动突破的两大元技术——搜索和学习——之所以有效,恰恰是因为它们能随算力的增长而无限扩展。而”学习”最自然、最原始的形态是什么?不是坐在教室里听课,不是阅读标注好的数据集,而是像所有生物一样:在真实世界中行动、观察后果、调整行为——也就是试错。想一想,你人生中最早学会的那些技能——走路、说话、骑自行车——有哪一个是靠”读教材”学会的?没有人给你列一 张”左脚先迈、重心前移”的步骤清单。你只是不断地尝试,摔倒,再爬起来,直到某一天身体自己记住了该怎么做。这种能力——在未知环境中通过试错来学习,以最终的回报为导向——是所有生物最本能的学习方式。
过去十年的人工智能恰恰绕开了它。我们教会了机器认猫认狗、翻译语言、生成图片,用的全是同一种方法:给它成千上万个标注好的正确答案,让它照着学。但当问题从”识别”变成”决策”——让机械臂抓取水杯,让 AI 在星际争霸中打败职业选手,或者让大语言模型学会得体地回答问题——你根本无法为每一步标注出标准答案。面对这些需要在动态变化中做连续决策的难题,强化学习(Reinforcement Learning, RL)提供了一套截然不同的思路: 不告诉 AI 怎么做,只告诉它什么好、什么不好,剩下的让它自己摸索。
依赖注入里的 inject 可以想象成注射器:外部容器 ──注入──> 对象,对象不再自己创建依赖,而是由外部把依赖“送进去”。reinforce 也可以建立类似的画面:想象一面不够坚固的墙,在里面增加钢筋和支撑。reinforcement 不是把正确答案“注射”给智能体,而是像给某条行为路径加钢筋,做得好,就把这条路径加固;反复加固后,它逐渐成为稳定策略。这也解释了为什么强化学习不叫 reward learning:奖励只是反馈,真正发生的是行为概率被逐渐加固。
从训练机器人行走开始
策略梯度法入门—强化学习该例是要设计一个两腿机器人,使其能自动的行走。机器人左右腿的跨、膝、踝共有6个关节,都装有小电机,希望能自动控制它的6个小电机,使机器人能和人一样正常的行走。
强化学习需要一个软件系统,其基本组成包括:
- 代理(Agent智能体):是个软件,相当于机器人的大脑,是强化学习的核心。它可以接受环境状态的信息,还可以将计算的结果传输给环境。其中,负责计算的是个函数,称作策略(policy),是强化学习最重要的部分。
-
环境(Environment):代理以外的部分都是环境。和通常的环境概念不同,机器人所处的周边当然是环境,不同的是,机器人的躯体四肢都在代理之外,也都归于环境,比如躯干的高度,各个腿及各个关节的位置、速度等。此例中,环境状态使用31个观测值。包括
- 躯干沿Y和Z轴方向的坐标值,
- 躯干沿X、Y和Z方向的速度,
- 躯干旋转的角度和角速度,
- 6个关节的角度和角速度,
- 脚和地面之间的接触力。
- 状态(State):指环境的状态。机器人一直在移动,所以,周围环境的状态,以及自身各关节的状态也在不断的变化。
- 行动(Action):指代理根据当前状态采取的动作,比如机器人向左或向右,向前或向后移动等。
- 奖励(Reward):代理在当前状态下,采取了某个行动之后,会获得环境的反馈,称作奖励。但可能是奖励,也可能是惩罚,实际是代理对行动的评价。在强化学习中,奖励非常重要,因为样本没有标签,所以奖励起到引领学习的作用。
使机器人正常行走要做的工作。让两腿机器人正常行走,要做的工作是,用正确的指令控制每个关节,使机器人的腿和躯干正确的移动,这需要有六个关节的扭矩指令。在给定的环境状态下,如何得到正确的指令,这就是强化学习要做的工作。用传统方法开发机器人的行走程序,要人工设计逻辑、循环、控制器及参数等等,需要很多的环路,非常复杂。而强化学习的思想极为简单,它不考虑整个过程的具体步骤,不进行一步步的具体设计,而是把这一切复杂工作都塞到一个函数里,这个函数称作策略函数。策略收到环境传来的31个状态值,会自动计算出6个可供执行的指令,指令正确,机器人就会正常的行走。可以看出,强化学习中,机器人能正常行走的关键,就是这个策略函数。
所以下面的重点是:智能体里的策略函数是什么形式?它如何进行学习?如何通过环境状态值计算出6个正确的指令,使机器人能正常的行走。
- 策略是个函数,因其过于复杂,很难用显性的公式来表式。对于这种连续且复杂的问题,强化学习是采用功能强大的神经网络来近似这个函数。这里策略神经网络是用的多层感知机(最基本的前馈神经网络),并以此为例进行说明。
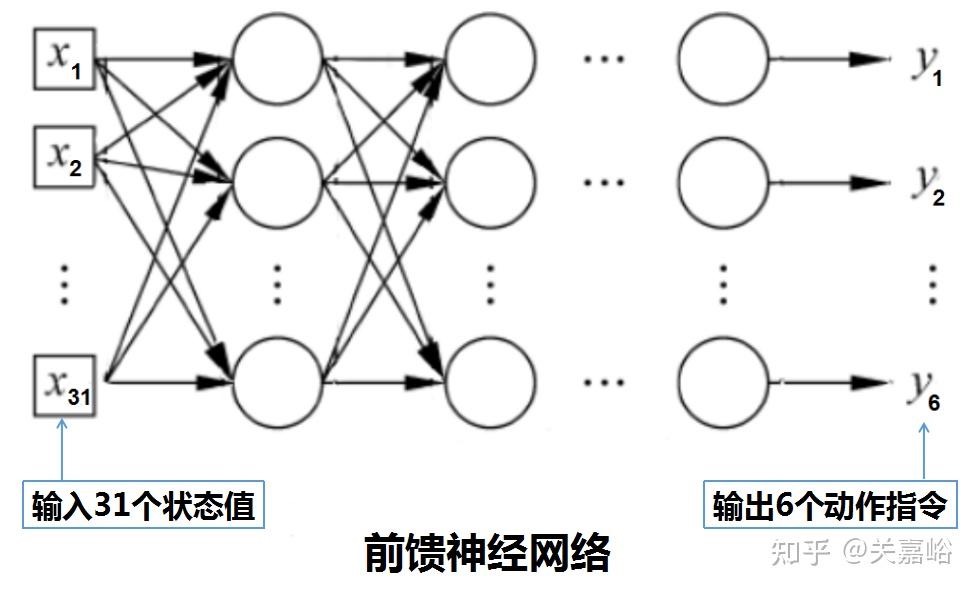 神经网络包含多个隐藏层,每层都有数百个神经元,没有足够多的神经元,网络无法拟合这么复杂的非线性函数,不可能将31个观察值正确的映射到6个动作。但是,神经元过多,将花费更多的时间训练,还容易得到过拟合的逻辑。所以,如何选择网络结构,包括网络层的数量,各层如何连接,以及每层神经元的数量等等,需要丰富的经验和知识找到最佳平衡点,使训练即可行又有效。
- 神经网络的学习过程。策略函数的学习过程,可以选择仿真或真实行走的方式。方法是让机器人不断行走,不断调整策略函数里的参数w和b,直至得到能使机器人正常行走的网络模型(策略函数)。一般监督学习的样本带有标签,可以直接根据预测与标签构造损失函数,再通过反向传播求损失函数对参数w和b的梯度。强化学习没有这种逐样本的标准答案,但没有监督标签不等于没有损失函数。环境给出 reward,算法再把 reward 加工成 return 或 Advantage,并构造可反向传播的策略损失,例如 $L_{policy}=-A_t\log\pi_\theta(a_t\mid s_t)$。反向传播穿过的是策略网络输出的 log-prob,而不是环境或 reward 本身。
- 奖励函数。奖励函数是人工精心设计的外部反馈信号,用于告诉智能体当前行为或整段轨迹有多好;它不是监督学习中的标签,也不直接等于最终用于反向传播的 loss。此例已经设计好的奖励函数是$ r_t = v_x -3y^2 - 50z^2 + 25xx - 0.22xx $,其中 $v_x$ 是前进速度,$v_x$ 越大,机器人走得越快。y是侧向位移,使机器人沿着一条直线移动,不向左右偏移,越小越好。z是机器人重心的垂直位移,是要机器人的躯干保持一定的高度,不摔倒、不跳跃或蹲着走路,越小越好。其余设置,这里不逐一深究。总之,这个奖励函数值越大,机器人走的就越好。奖励函数非常重要,但其设置是个难点,需要丰富的经验和专业知识。
- 策略函数的学习过程。现在,策略函数是一个神经网络(多层感知机),策略能否做出正确的动作指令,取决于网络里的所有参数w和b。环境通常不在策略网络的可微计算图中,因此不能直接求 reward 对w和b的梯度。策略梯度使用 log-derivative trick,把“提高期望回报”转换成“按 return 或 Advantage 加权采样动作的 log-prob”,再通过这个策略损失更新参数。就这样反复采样、评估和更新,最终得到能做出较好指令的策略网络。
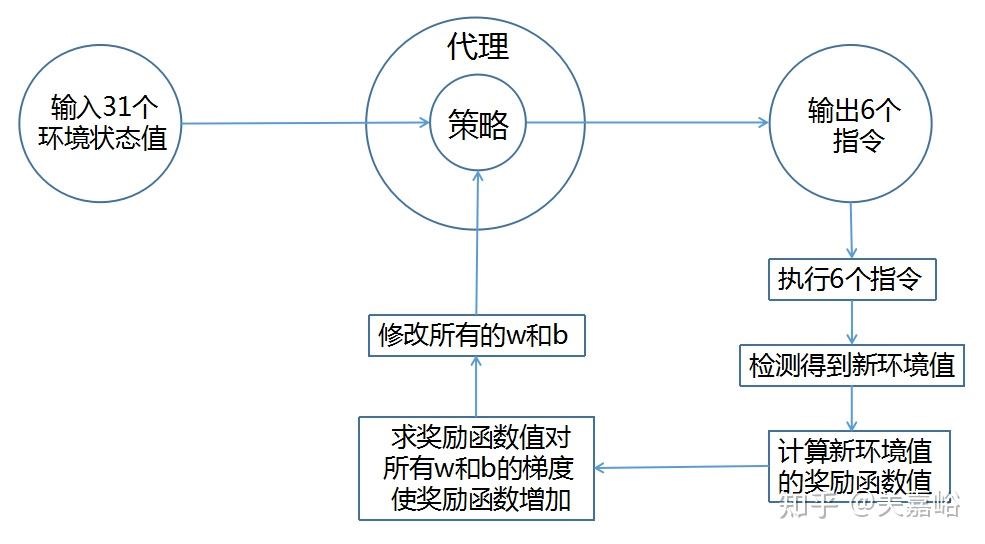 具体作法大意是
- 输入31个环境值;
- 网络计算得到6个指令,执行指令改变了环境,检 测得到了31个新环境值;
- 根据一段交互得到的 reward 计算 return 或 Advantage;
- 用 Advantage 加权动作的 log-prob,构造策略损失并反向传播;
- 修改网络参数w和b,返回到1进行下一轮采样。 就这样,代理不断与环境交互,不断修改策略的参数。强化学习的过程就是不断优化策略的过程。环境检测到的新状态和 reward 虽然没有与策略网络直接连成可微计算图,但策略梯度可以利用采样动作的 log-prob,将这些反馈转换成可用于更新策略参数的梯度估计。
PS: rl和dl都是在想办法,算一个loss,优化w和b。 李宏毅老师提到 ml 约等于looking for a funtion, 对监督学习 label = func(input), 对rl来说,action=func(observation)。
什么是强化学习
如果只用一句话概括,强化学习是一类解决序列决策问题的计算方法:让模型在与环境的持续交互中,通过奖励反馈不断修正策略,最终最大化长期回报。强化学习和监督学习最大的不同在于:监督学习面对的是静态训练集,而强化学习面对的是一个闭环系统。当前策略会影响你接下来看到的状态、动作和奖励,所以“训练数据”本身会随着策略变化而变化。
介绍强化学习经常提到几个游戏
- CartPole(倒立摆),智能体通过控制小车向左或向右移动,让竖在车上的杆尽可能长时间保持平衡。每坚持一步都会获得奖励,因此它可以直观展示智能体如何通过反复试错学会策略。
- 老虎机/多臂老虎机。
通过多臂老虎机来谈探索和利用
假设智能体面前有 A、B 两台老虎机。它每次选择一台,拉动摇臂并获得一个分数。这里,选择哪台老虎机是动作,拉动后得到的分数是奖励。 智能体第一次拉动 A 得到 6 分,第一次拉动 B 得到 4 分。根据这两次结果,下一次选择 A 是很自然的。不过,每台老虎机给出的奖励并不固定。一次得到 6 分,不代表以后每次都能得到 6 分;一次得到 4 分,也不能说明这台老虎机一定较差。因此,智能体需要多次拉动老虎机,根据已经得到的奖励估计它们的平均奖励。老虎机也可以不止两台。把可选的老虎机数量记为 K,智能体要在 K 台老虎机之间反复选择。这样的任务称为多臂老虎机问题(Multi-Armed Bandit Problem)。有了平均奖励的估计,智能体可以继续选择当前估计最好的老虎机。这样做称为利用(exploitation)。不过,如果总是选择同一台老虎机,其他老虎机的数据就不会增加,早期的错误判断也无法得到修正。因此,智能体还需要尝试那些选择次数 较少、平均奖励仍不确定的老虎机。这样做称为探索(exploration)。利用是选择当前估计最好的动作,探索是尝试仍然不确定的动作。探索会暂时消耗行动机会,却能产生新的信息;利用使用已有信息获得奖励,却可能把智能体锁定在早期误判的动作上。
怎样估计动作的平均奖励?以及怎样在探索和利用之间进行选择?
- 需要一个工具回答“一个随机选择平均能得多少分”。这个工具就是期望(expectation)。是期望的算法:每种结果的数值乘以它出现的概率,再全部相加。期望的含义是长期平均:单次结果会上下波动,重复次数多了,平均值会趋近期望值。 \(\mathbb{E}[X] = \sum_{i=1}^{n} p_i \cdot x_i\) 其中,$x_i$ 是第 $i$ 种结果,$p_i$ 是它出现的概率。期望的含义是长期平均:单次结果会上下波动,重复次数多了,平均值会趋近期望值。真实期望看不到,能看到的只有一次次尝试的样本。策略设计要解决的,就是怎样用这些有限样本估计和使用动作价值。动作价值不是提前给出的,而是在交互中估计出来的。
- 探索的样本量直接决定回报:样本太少,误判概率高;样本太多,探索成本又吃掉收益。怎样分配探索机会?
- $\epsilon$-贪心策略, 以 $1-\epsilon$ 的概率选择当前估计最好的动作;以 $\epsilon$ 的概率随机选择一个动作。
- 让探索随时间减少。训练早期,智能体几乎没有经验,需要更多探索。训练后期,估计值已经比较稳定,继续大量随机尝试会降低收益。。于是可以让 $\epsilon$随时间下降
- 更有针对性的探索。$\epsilon$-贪心的探索方式很粗。只要进入探索分支,它会在所有动作中随机选择,包括那些已经明显很差的动作。更好的探索策略会继续追问:哪些动作仍然不确定,因而值得再试?
多臂老虎机可以看作强化学习过程的最小版本:
- 动作集合已经存在
- 奖励会在动作之后出现
- 策略决定下一步选什么;
- 智能体根据经验更新对动作好坏的估计 它缺少一个关键部分:状态不会因为动作而改变。语言模型生成一个 token 后,后续上下文会改变,下一步可选动作的意义也会改变。有了会变化的状态,问题就从“在同一个局面里反复选动作”扩展成“在一串连续变化的局面里做决策”。
MDP 与马尔可夫性
多臂老虎机让我们先看清了探索与利用。但游戏里你走一步,地图位置会变;大模型生成一个词,后面的上下文也会变。你不能只回答”哪个动作更好”,还得回答”在当前这个局面下,哪个动作更好”——而且回答完之后局面又变了,你得在新局面下重新决策。要描述这类问题,需要一套更完整的数学框架——马尔可夫决策过程(Markov Decision Process, MDP)。它不是抽象包装,而是把”动作会改变下一步局面”这件事写成了精确的数学语言。MDP 是强化学习的标准建模语言,核心公式
\[\mathcal{M} = (\mathcal{S}, \mathcal{A}, P, R, \gamma) \qquad \text{(MDP 五元组:描述序列决策问题)}\]马尔可夫决策过程(Markov Decision Process):
- $\mathcal{S}$:状态空间(State Space),所有可能局面的集合。
- $\mathcal{A}$:动作空间(Action Space),所有可能采取的操作的集合。
- $P$:状态转移概率(Transition Probability),描述环境的物理规律。 \(P(s' \mid s,a) = \text{在状态 } s \text{ 下采取动作 } a \text{ 后,转移到 } s' \text{ 的概率}\)
- $R$:奖励函数(Reward Function),描述环境对动作的打分规则。
- $\gamma$:折扣因子(Discount Factor),决定智能体有多“短视”或“远视”。
这五个要素环环相扣,构成一个完整的决策循环:你在某个局面(S)下做了一个选择(A),世界因此变了(P),你得到了反馈(R),然后进入下一个局面,继续循环——而 $\gamma$ 决定了你有多在乎”以后还能拿多少分”/权衡短期与长期。
\[P(S_{t+1} \mid S_t, A_t, S_{t-1}, A_{t-1}, \ldots) = P(S_{t+1} \mid S_t, A_t)\]MDP 最核心的假设是马尔可夫性:马尔可夫性(Markov Property):预测下一状态只需要当前状态和动作,不需要知道之前是怎么走到这个局面的,就能做出最优决策。就像下象棋,只需看当前的棋盘,不需要知道前面十步是怎么走的。这意味着状态必须”完整”,就像只看了一眼车速表,却不知道车是在加速还是刹车。状态必须包含做决策所需的所有信息。
- $S_t$:当前状态,必须包含预测下一步所需的信息。
- $A_t$:当前执行的动作。
- $S_{t+1}$:动作之后到达的下一状态。
- 等式表示:当前状态完整时,更早的历史不会为下一状态提供额外信息。
老虎机中,不管你选哪台,状态都不变。CartPole 中,P 由牛顿力学决定。一个关键区分:P 是否已知。知道 P 就能用动态规划直接算最优策略;不知道 P 就只能通过交互来”摸索”。大多数真实RL 问题中 P 是未知的——围棋有 10^170 个状态,LLM 有天文数字的 token 序列组合。”不知道 P”恰恰是 RL 区别于传统最优化的核心特征。
所有目标都可以被描述为”最大化期望累积奖励信号”,不管你想要智能体做什么——赢棋、开车、聊天——只要编码成奖励函数,RL 理论上就能学到。但设计好奖励函数是 RL 工程中最困难的环节之一。
$G_t$ 和 $\pi$
MDP 五元组已经描述了单步环境规则。奖励函数 R 只给出每一步的奖励,一次任务却会得到很多个(单步)奖励。怎样把它们合成一个长期结果,需要引入折扣回报(return) $G_t$。折扣因子让远期奖励的权重逐步减小,使无限时域任务的长期结果能够保持有限。$G_t$ 还可以写成递归形式:
\[G_t = r_t + \gamma G_{t+1}\]MDP 五元组还留下另一个缺口:动作集合 $\mathcal{A}$ 只说明智能体可以做什么,没有说明它在某个状态下实际选择什么。把状态变成动作的决策规则称为策略 $\pi$。策略有确定性和随机性两种形式。
-
确定性策略——对同一个状态永远输出同一个动作:
\[a = \pi(s)\]这个式子表示:输入状态 $s$,策略直接输出一个动作 $a$。
-
随机性策略——输出动作的概率分布:
\[\pi(a \mid s) = \P(A_t = a \mid S_t = s)\]
这个式子表示:已知状态 $s$ 时,策略给出各个动作的选择概率。
策略、价值与回报 ==> 价值函数很不好算
现在,环境已经能够用 MDP 表示,但强化学习问题还没有完整。动作集合没有说明每一步怎样选择,奖励函数也只给出单步奖励,没有说明怎样评价整条轨迹。现在加入策略 $\pi$。智能体根据当前状态选择动作,环境返回奖励并进入下一状态;不断重复,就得到一条轨迹,沿着轨迹可以算出每个时刻的回报 $G_t$。但真正做决策时,智能体不能等轨迹结束再判断——同一个状态在不同尝试中可能产生不同的动作、转移和回报,因此在行动之前,还需要对这些可能的未来取平均。具体来说:每一步怎么选(策略 $\pi$)、一条轨迹总共得到多少(回报 $G_t$)、行动之前怎样评价状态和动作($V^\pi(s)$、$Q^\pi(s,a)$ 和 $A^\pi(s,a)$)。
状态价值 $V^\pi(s)$ 是$G_t$ 在条件 $s_t$ = s 下的期望。 $r_t$ 是一步分数,$G_t$ 是从某一刻开始沿着一条轨迹实际拿到的总分,而 $V^\pi(s)$ 要回答的是:如果很多次都从同一个状态 s 出发,长期来看这些总分平均是多少。因为策略可能随机,环境转移也可能随机,所以即使都从同一个状态 s 出发,后面也可能走出不同轨迹,得到不同的$G_t$ 。好策略的 $V^\pi(s)$ 高,差策略的 $V^\pi(s)$低。RL 的目标,就是找到让价值最高的策略。
\[V^\pi(s) = \mathbb{E}_\pi\left[G_t \mid s_t=s\right] = \mathbb{E}_\pi\left[ \left. \sum_{k=0}^{\infty}\gamma^k R_{t+k+1} \right| s_t=s \right]\]$V$ 是 value 的首字母,表示价值;右上角的 $\pi$ 提醒我们,这个价值取决于后续采用哪条策略。竖线 $\mid$ 表示“在……条件下”。因此,$V^\pi(s)$ 的意思是:已知当前状态 $s_t=s$,之后按照策略 $\pi$ 行动时,回报 $G_t$ 的平均值。
$V$很有用,但它还不够用来做选择。比如 站在一个路口,$V^\pi(s)$像是在说“这个路口整体还不错”。可是你真正要决定的是:往左走,还是往右走? 只知道“这个路口不错”还不够,你还想知道“先往左走大概能拿多少分,先往右走大概能拿多少分”。
\[Q^\pi(s,a) = \mathbb{E}_\pi\left[G_t \mid s_t=s,\ a_t=a\right]\]动作价值$Q^\pi(s,a)$ 比 $V^\pi(s)$ 多固定了第一步动作。假设在同一个状态 $s$ 下,采取行动a(之后继续按照策略 $\pi$ 行动)的长期价值,它把“状态整体上好不好”细分成“在这个状态先做某个动作好不好”。策略改进需要的是后者。
$V$ 与 $Q$ 的关系,$V^\pi(s)$是把同一个状态下所有可能动作的 $Q^\pi(st, at)$ 按策略概率平均起来
\[V^\pi(s) = \sum_a \pi(a \mid s)Q^\pi(s,a)\]优势函数(advantage function)衡量动作 $a$ 相对于当前策略在状态 $s$ 下平均选择的动作好多少:
\[A^\pi(s,a) = Q^\pi(s,a)-V^\pi(s)\]MDP 定义环境 ==> 策略 $pi$ 与环境交互,产生轨迹$\tau$ ==> 轨迹产生奖励序列 ==> 用 $G_t$ 汇总未来奖励 ==> 用 V、Q、A 评价状态和动作。价值函数的定义已经清楚,但计算仍然困难,来需要枚举从 s 出发的所有未来轨迹,再对回报取平均,但未来轨迹可能很长,也可能分叉很多。幸好,回报本身有一个递归结构:$G_t = r_t + \gamma G_{t+1}$,而状态价值又定义为:$V^\pi(s) =\mathbb{E}_\pi[G_t \mid s_t=s]$,把这两件事放在一起,自然产生一个问题:既然一条轨迹的回报 $G_t$ 可以递归,那么评价策略用的 $V^\pi(s)$ 是否也能递归?答案是肯定的,这就是贝尔曼方程。
面对这种无限视野和庞大状态树的问题,1950 年代,美国应用数学家理查德·贝尔曼(Richard Bellman) 在创立动态规划(Dynamic Programming)理论时,提出了大名鼎鼎的最优性原理(Principle of Optimality)。他发现:我们不需要一眼望穿整个未来,因为“今天的价值”里,必然包含着“明天的价值”。这就像是算退休金。你不需要现在就把未来 30 年每一天的利息都分别算清楚再相加,你只要知道:“今天的总资产 = 今天的收益 + 明天本金带来的未来总资产”。这种把一个无限期的大问题,精妙地拆解成“当前这一步”和“剩下所有步”的思想,就是动态规划的灵魂。基于这个原理写出来的递推等式,就被称为贝尔曼方程(Bellman Equation)。
从 $V^\pi(s)$ 的定义出发,利用 $G_t$ 的递归结构,把“评价策略”改写成“当前一步+下一状态评价”的结果。把这个长远评价拆成一步递推:先看眼前奖励,再把剩下的未来交给下一状态的价值。这样,评价策略不再需要一次看完整个未来,而可以通过相邻状态之间的关系逐步传播回来。贝尔曼方程将策略评价从一个难以直接计算的“无限求和问题”,转化成只依赖相邻状态的递推关系,当前价值 = 即时奖励 + $\gamma$ × 下一状态价值的期望。这意味着,只要环境的规则(奖励和转移概率)以及策略$\pi$ 是公开透明的,我们理论上就能直接算出这个策略下所有状态的准确价值。
但现实很残酷,贝尔曼方程只给出了一条约束,并没有直接给出答案。要把方程变成算法,我们需要给每个状态分配一个存储位置,初始随便填个数(算法一开始没有真正的$V^\pi$),然后让程序反复修改它、逼近真实值——这就是价值表( V 的一种表示方式,程序里,它可以是 NumPy 数组、Python 字典、哈希表,或者数据库表中的一列)。同一个思想也会自然扩展到动作价值($Q^\pi(st, at)$ 也有自己的一步递推关系)。状态价值表只给每个状态存一个数;动作价值表则给每个“状态-动作对”存一个数,也就是 Q(s, a)。
在有限状态问题里,可以把 V(s) 存成价值表,让每个状态都有一个可更新的数字。这张表已经比只看即时奖励前进了一大步。它不再问”这一步拿几分”,而是问”从这个局面出发,长期来看值多少分”。然而,控制问题还差最后一步:智能体最终必须选择动作。只知道一个状态整体值多少分,并不一定能告诉我们在这个状态下应该向左、向右、跳跃还是停止。这就是动作价值函数 Q(s, a) 要解决的问题。如果环境模型已知,我们可以从 $V^\pi$ 推出动作价值。给定策略 $\pi$,在状态 $s$ 先执行动作 $a$,会得到即时奖励 $R(s,a)$,随后以概率 $P(s’ \mid s,a)$ 到达下一状态 $s’$。从下一状态开始,未来价值仍然由 $V^\pi(s’)$ 表示。因此有: \(Q^\pi(s,a) = R(s,a) + \gamma \sum_{s'} P(s' \mid s,a)V^\pi(s')\)
这个式子的含义很直接:动作价值等于“先做这个动作拿到的即时奖励”,加上“动作造成的下一状态价值的折扣期望”。问题在于,现实任务中我们通常不知道 $R$ 和 $P$。智能体看不到完整的转移概率表,也不知道每个动作的期望奖励;它只能一次次尝试,看到自己实际拿到的 $r$ 和实际到达的 $s’$。 于是,一个自然的想法出现了:既然模型未知时难以用 $P$ 和 $R$ 去计算动作价值,不如像学习 $V(s)$ 一样,直接学习每个状态—动作对的价值。我们把表格从“每个状态一格”扩展为“每个状态下的每个动作一格”。这张表就是动作价值表,也就是 $Q$ 表。
从 Q 到策略:动作是孤立的、局部的执行指令。比如在状态 (0, 0),你决定“向右走”,这是一个动作。它只解决“眼下这一步迈哪只脚”的问题。策略则是一本“全局指导手册”。譬如在状态 s 下,查看所有动作的 Q 值,然后选择其中最大的那个动作,这种“每次都选分数最高动作”的规则,称为贪婪策略。实际中策略并不一定非得这样定义。比如训练时,为了探索(Exploration)没有充分尝试过的动作(否则 Q 表的很多格子永远不会被更 新),往往还会在贪婪选择之外加入一定随机性。
如果状态空间稍微大一点(比如围棋的 10^170 种局面),价值表/动作价值表装不下,这辈子都算不完。所以,这种“上帝视角”的直接求解法通常只存在于理论和极简单的玩具环境中。面对复杂问题,如果表格装不下,用一个神经网络来”近似”整张 Q 表(DQN),转向动态规划(DP)、蒙特卡洛(MC)或时序差分(TD)等通过不断迭代来逼近真实价值的算法。
从 Q-Learning 到 DQN(略)
从DQN到策略梯度
Q-Learning 学的是一张“动作评分表”:$Q(s,a)$,真正选动作时,还需要再做一步:$a^*=\arg\max_a Q(s,a)$,在 CartPole 中只有左、右两个动作,这很容易。但机器人关节力矩是连续值,动作有无穷多个;此时不可能枚举所有动作,再比较所有 $Q(s,a)$。DQN 用神经网络解决了“状态太多,Q 表装不下”的问题,但没有从根本上解决“连续动作无法枚举并取 $\arg\max$”的问题。于是改变学习对象:不再学习“每个动作值多少分”,直接学习“在当前状态下,各动作应该以多大概率出现”:$\pi_\theta(a\mid s)$,离散动作可以输出 Softmax 概率;连续动作可以输出高斯分布的均值和标准差。
策略怎样评价?策略会与环境交互,产生轨迹:$\tau=(s_0,a_0,r_1,s_1,a_1,r_2,\ldots)$,同一个策略可以产生许多不同轨迹。我们希望找到一个参数 $\theta$,让这些轨迹的平均回报最大:
\[J(\theta) = \mathbb E_{\tau\sim\pi_\theta}[G_0]\]这里的 $J(\theta)$ 就是“当前策略总体有多好”。
奖励不能直接反向传播。环境通常不在神经网络的可微计算图中。机器人执行动作后摔倒、游戏角色撞墙、语言模型答案被 verifier 判错,这些结果都不能直接对参数 $\theta$ 求导。但策略网络输出的动作概率可以求导:$\log\pi_\theta(a_t\mid s_t)$。因此可以把两个信息乘起来:
- $\log\pi_\theta(a_t\mid s_t)$:这个动作由策略产生的概率;
- $G_t$:这个动作之后实际获得的回报。
策略梯度定理把梯度写成:
\[\nabla_\theta J(\theta) = \mathbb E_{\pi_\theta} \left[ \sum_t G_t \nabla_\theta \log\pi_\theta(a_t\mid s_t) \right]\]直觉是:
- 后续回报高,就提高这次动作的概率;
- 后续回报低,就少提高或降低这次动作的概率;
- 多次采样后,高回报轨迹中的动作逐渐变得更常见。
这就是 REINFORCE,代码里通常通过最小化负号形式实现:
\[L_{\text{policy}} = -\sum_t G_t\log\pi_\theta(a_t\mid s_t)\]直接使用 $G_t$ 有一个问题:它只表示绝对成绩,不说明这次结果是否超过当前状态下的正常水平。例如,考 80 分是好是坏,要看这场考试平均多少分。因此引入基线:$G_t-V^\pi(s_t)$,它是优势函数的一种采样估计:
\[A^\pi(s_t,a_t) = Q^\pi(s_t,a_t)-V^\pi(s_t)\]最终策略损失可以写成:
\[L_{\text{policy}} = -\sum_t A_t\log\pi_\theta(a_t\mid s_t)\]现在因果链闭合了:
$G_t$ 告诉我们这次经历拿了多少分,$V$ 给出当前状态的平均预期,$A$ 判断动作比平均水平好多少,策略梯度用 $A$ 加权动作的 log-prob,从而修改策略参数。
MDP 定义问题
→ 策略产生轨迹
→ Gt 评价一次经历
→ V/Q/A 评价状态和动作
→ Q-Learning 学 Q,再用 argmax 间接得到策略
→ 连续/巨大动作空间让 argmax 路线变困难
→ 直接参数化策略 πθ
→ 用期望回报 J(θ) 衡量策略
→ 用采样回报和 log-prob 构造梯度
→ 得到策略梯度
分类
在强化学习(Reinforcement Learning, RL)的发展历程中,研究者始终面临一个核心问题:如何设计智能体的决策机制以实现长期收益最大化?这一问题催生出两大主流研究范式——基于价值的方法(Value-based Methods)和基于策略的方法(Policy-based Methods),区别是:智能体最终把什么作为主要学习对象,以及怎样产生动作。PS:注意V 表、Q 表只是价值函数的一种存储形式,Policy-based也需要评价,也用到V、Q、A。
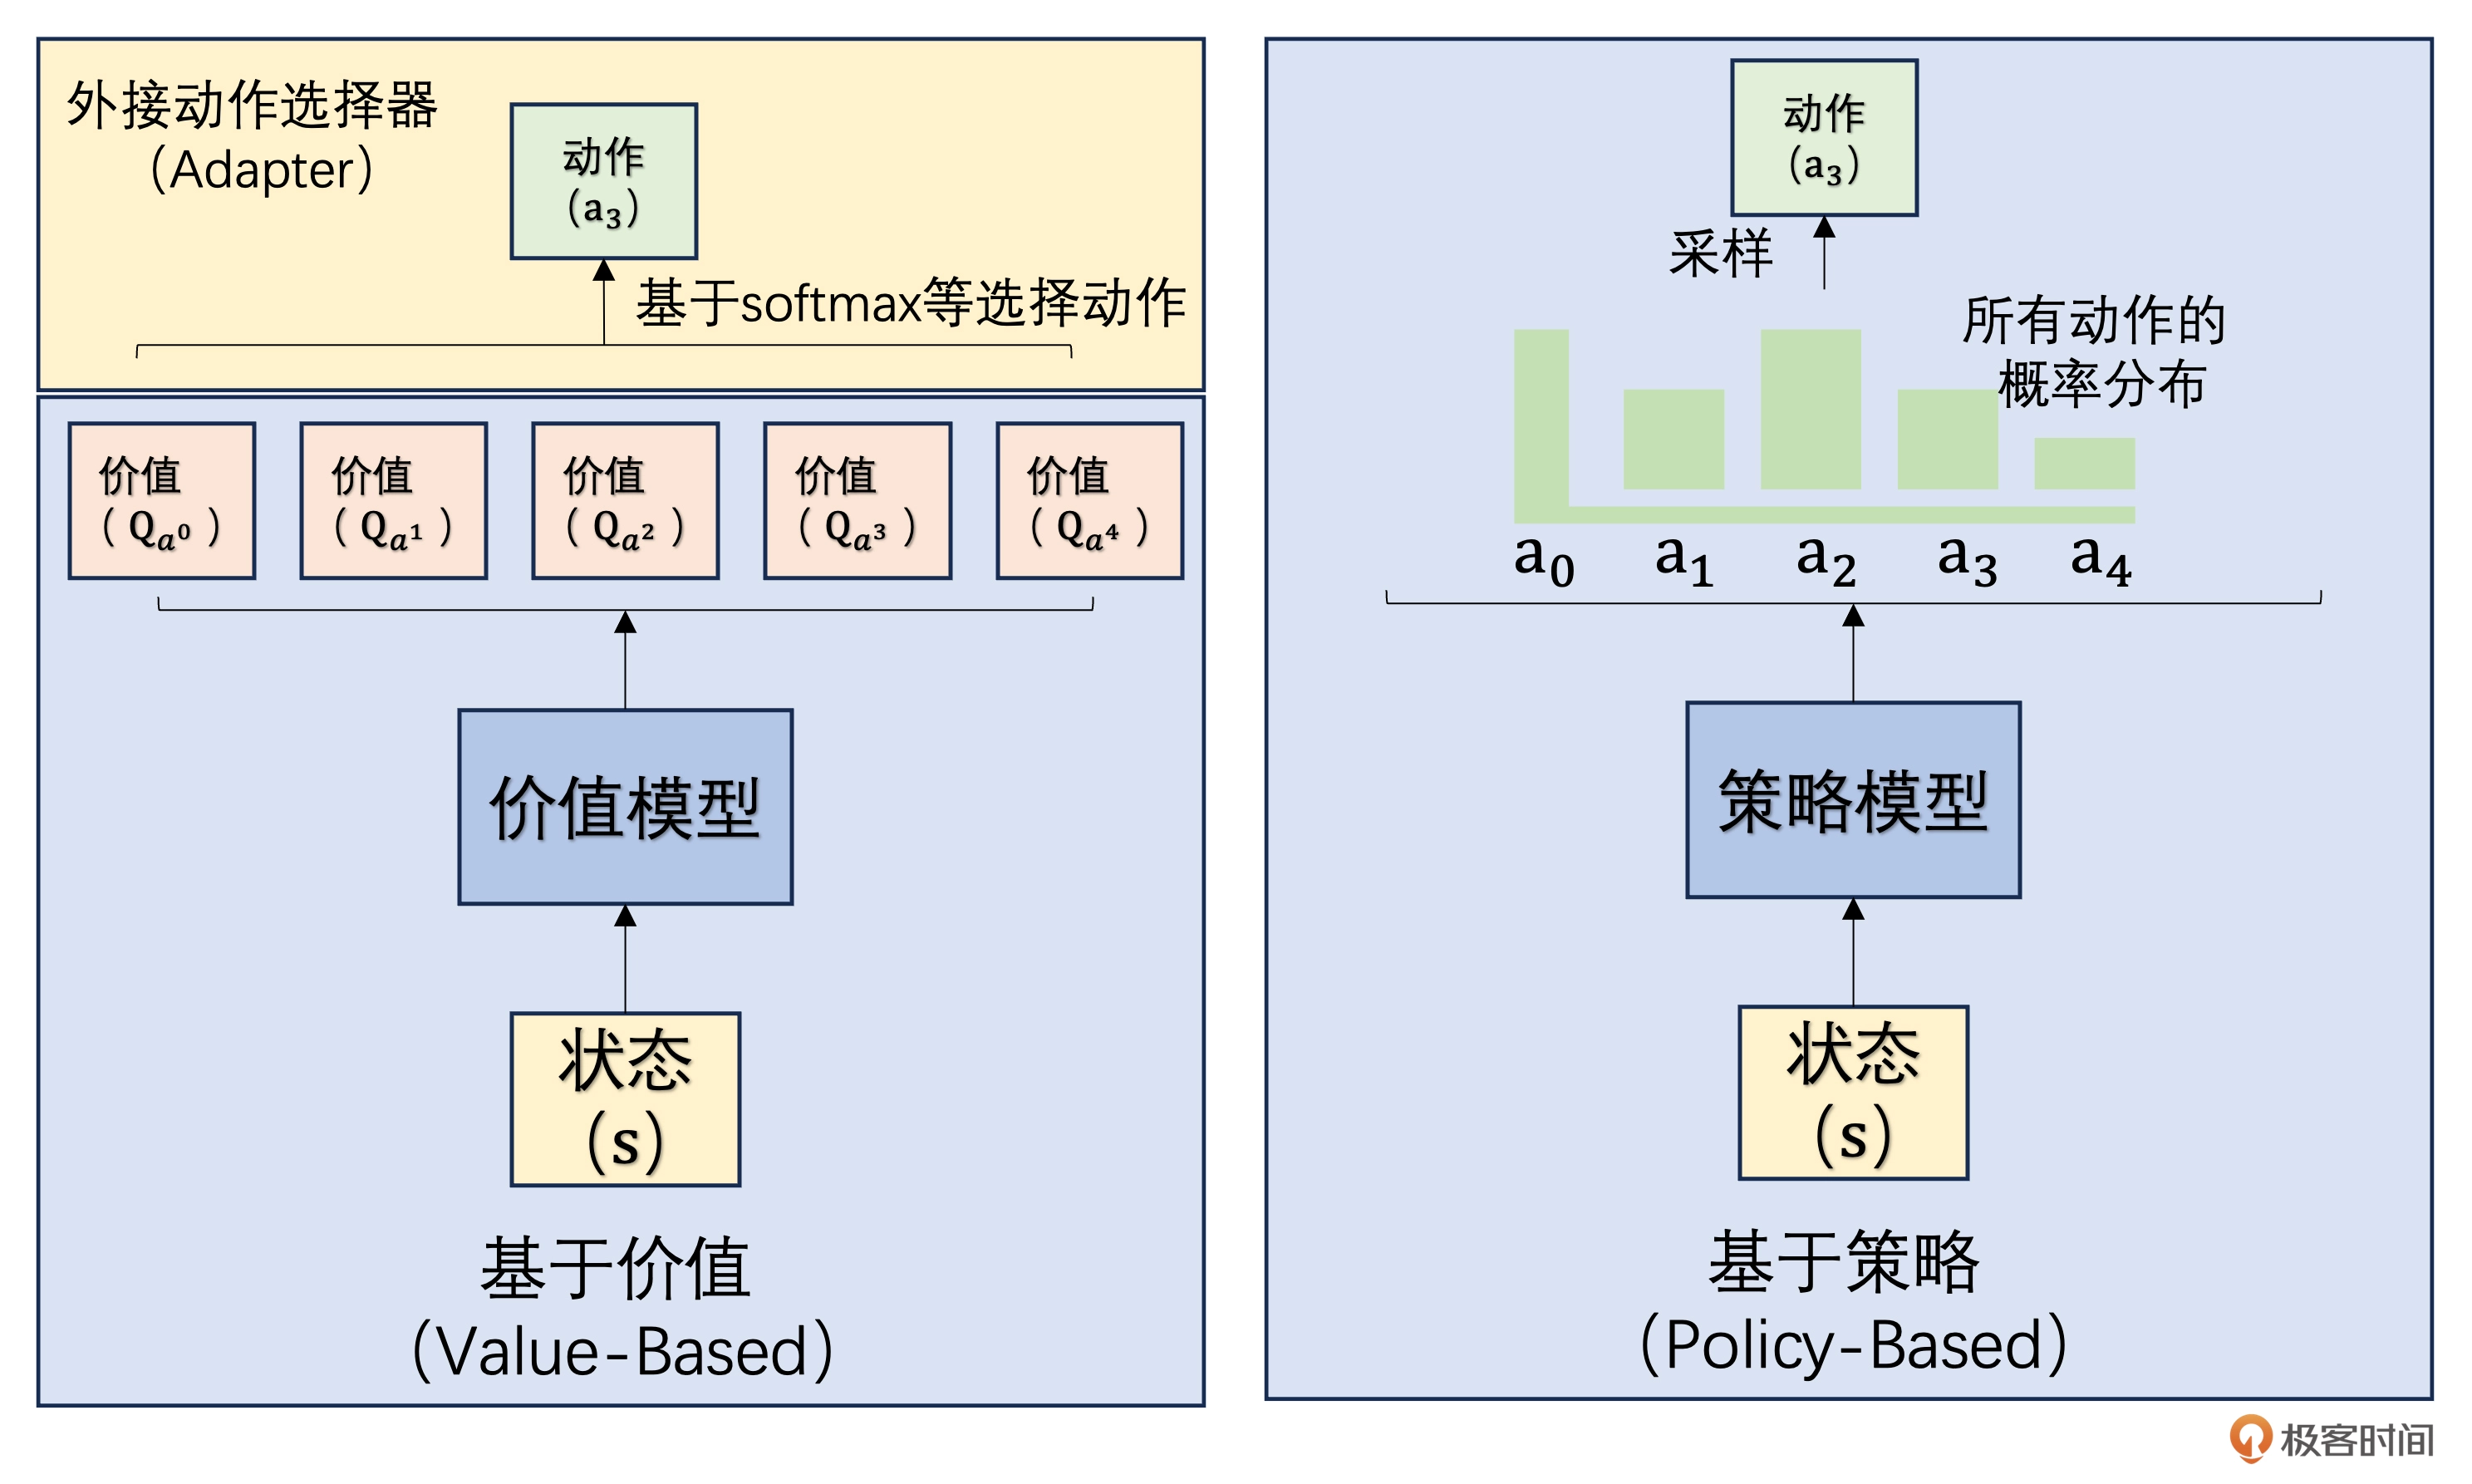
| 类型 | 主要学习对象 | 如何选择动作 |
|---|---|---|
| Value-Based | $Q_\phi(s,a)$ | $\arg\max_a Q_\phi(s,a)$ |
| Policy-Based | $\pi_\theta(a\mid s)$ | 从策略分布采样 |
| Actor-Critic | $\pi_\theta$ 和 $V_\phi/Q_\phi$ | Actor 选动作,Critic 帮 Actor 学习 |
Value-Based(参考)
先搞清楚每个动作”值多少分”,再选最高分。
在强化学习中,智能体的目标是通过与环境交互最大化累积奖励。但面对复杂环境,我们需要一种工具来评估“在某个状态下采取某个动作是否划算”——这就是价值函数的作用。智能体处于某状态时,依据当前状态与可选动作,查询 Q-table,就能得到对应的 Q 值。Q-Learning 算法通过不断与环境交互(试错),更新 Q 表中的 Q 值,让智能体逐渐学到:在什么状态下,执行什么动作,能获得更高的长期收益,最终掌握最优决策策略(比如游戏通关、机器人高效导航)。
- Q-table(Q 表):是存储“状态 - 动作 - Q 值”对应关系的数据结构,可理解为一张表格,行代表环境的不同状态(State),列代表智能体可执行的动作(Action),单元格数值就是 Q 值(Q-value)。
- 状态(State):智能体所处的环境快照,比如游戏里的当前关卡、角色位置;机器人导航中的坐标、障碍物分布等,是决策的环境基础。
- 动作(Action):智能体在当前状态下可选择的操作,比如游戏角色“移动、攻击、跳跃”,机器人“前进、转向、停止”等,是智能体与环境交互的手段。
- Q 值(Q-value):对“在某状态执行某动作后,未来累计收益”的估计。数值越高,代表该动作在当前状态下越“有价值”,是智能体学习“最优策略”的核心依据。
为了更精准地理解 Q 函数的作用,我们先明确强化学习中与“价值评估”相关的三个核心概念:奖励、回报与价值函数。
- 奖励(Reward):环境对智能体动作的即时反馈,用 $ R_t $ 表示。比如游戏中吃到金币得 10 分,碰到敌人扣 50 分。
- 回报(Return):从当前时刻开始的累积折扣奖励,公式为:$ G_t = R_t + \gamma \cdot R_{t+1} + \gamma^2 \cdot R_{t+2} + \dots + \gamma^{n - t} \cdot R_n $,其中 $ \gamma $ 是折扣因子($ 0 \leq \gamma \leq 1 $),用于权衡即时奖励和未来奖励的重要性。简单来说,回报是“从现在开始,所有未来奖励的加权总和”,折扣因子 $ \gamma $ 越接近 1,说明智能体越重视长远奖励;越接近 0,则更关注即时奖励。
-
动作价值函数(Q 函数):在状态 $ s $ 采取动作 $ a $ 后,遵循策略 $ \pi $ 能获得的期望回报,公式为:$ Q_{\pi}(s_t, a_t) = \mathbb{E}[U_t S_t = s_t, A_t = a_t] $,$ Q_{\pi}(s, a) $ 就是“在状态 $ s $ 做动作 $ a $ 的好坏程度”的量化指标。一旦找到 $ Q_(s, a) $,智能体在任意状态 $ s $ 下,只需选择对应 $ Q $ 值最大的动作 $ a $(即 $ a = \arg\max_a Q_(s, a) $),就是最优策略。 - 最优动作价值函数:在所有可能的策略中,能获得的最大 $ Q $ 值,公式为:$ Q_*(s_t, a_t) = \max_{\pi} Q_{\pi}(s_t, a_t), \forall s_i \in (S), a_t \in (A) $。
如果我还没走到终点,怎么知道未来能拿多少分?这些 Q 值到底是怎么算出来的?这正是强化学习最精妙的地方:靠“先瞎猜”,然后“一步步纠错”。而允许我们这么做的理论基石,就是马尔可夫决策过程(MDP)。MDP 的核心假设是“未来只依赖当前,与过去无关”。因为有这个地基,我们可以玩一个数学魔术,把无限长的未来从中间切断——这就是贝尔曼方程(Bellman Equation)。它告诉我们,Q 值不用非得玩到底才能算,它可以直接拆解成两部分: 当前的 Q 值 = 眼前的即时奖励 + 下一步的 Q 值有了这个等式,算法的实际运作就极其直观了: 以走迷宫为例,一开始,所有岔路口牌子上的分数都是乱写的(随机初始化)。你随便走了一步,拿到 1 分奖励,并看到下一个路口的牌子上写着 10 分。你立刻就明白了:“哦,刚才那一步的真正价值大约是1+10=11 分!”于是你掏出笔,把刚才路口牌子上的分数改成了 11。通过这样在迷宫里不断试错,用“下一步的牌子”来纠正“上一步的牌子”,所有 Q 值最终都会收敛到真实的分数(满足贝尔曼最优方程)。
我们的目标就是找到这个最优 $ Q $ 函数,因为它能直接告诉我们“在任何状态下该做什么动作”。Q-table 作为 Q 函数最基础的具象化形式,通过表格结构直接存储每个(状态,动作)对对应的 Q 值,实现价值信息的直观映射。当系统的状态空间与动作空间均为离散类型且规模可控时,Q-table 凭借其简洁的结构和高效的查询能力,成为价值函数表征的理想选择。当状态和动作是连续空间时,$ Q $ 函数的输出是对每个(状态 - 动作)对的价值估计,此时无法用表格存储,需通过函数近似(如神经网络)拟合。Q - learning 使用表格的形式,对离散的动作价值函数进行表示;DQN 使用一个参数为 $ \theta $ 的神经网络来拟合 $ Q $ 函数,可以通过梯度下降来更新网络参数 $ \theta $ 的值,从而逼近真实的 $ Q $ 函数。
Policy-Based(参考)
跳过打分,直接学”看到什么就做什么”。还是走迷宫的例子,你不给路打分了,而是反复走很多次迷宫:走到终点就加强沿途每个选择的信心,掉进陷阱就削弱。走得多了,好动作的概率自然上升,坏动作的概率自然下降。
在强化学习的策略梯度方法中,“策略”是定义智能体行为逻辑的核心要素,它本质上是智能体在环境状态(State)与动作(Action)之间建立的映射规则,通常用符号 $\pi(a \mid s)$ 表示,直观理解为“当智能体处于状态 s 时,选择执行动作 a 的倾向性或概率分布”。策略梯度方法中的“策略”,标志着智能体优化目标的关键转变:它不再是被动地对环境建模(如估计状态价值),也不是通过价值判断间接选择动作,而是直接将“策略本身”作为优化对象——通过梯度上升等数学方法,持续调整 $\pi(a \mid s)$的参数,让策略生成的行为序列在与环境的互动中,最终实现“长期期望奖励”的最大化。
深度强化学习中,策略函数通常由神经网络实现,通过多层非线性变换将状态特征映射为动作分布参数。这种端到端的表示方式避免了人工特征工程,引入非线性变换,极大提升了策略的表达能力。策略优化的核心目标是找到最优参数$\theta^*$,最大化智能体在环境中的期望累积奖励。
策略梯度方法的理论基础是策略梯度定理(Policy Gradient Theorem),该定理揭示了目标函数梯度与策略参数的关系。策略梯度方法的理论基础是策略梯度定理(Policy Gradient Theorem),该定理揭示了目标函数梯度与策略参数的关系。对于任意策略参数化形式,目标函数的梯度可表示为:$ \nabla_{\theta} J(\theta) = \mathbb{E}{\pi{\theta}} \left[ \sum_{t=0}^{\infty} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) G_t \right] $ 。其中 $ G_t = \sum_{k=t}^{\infty} \gamma^{k-t} r_k $ 为从时刻 $ t $ 开始的累积折扣奖励(Return)。这一优雅的公式将目标函数梯度转化为可通过采样估计的期望值,为策略优化提供了可行路径。定理的推导基于马尔可夫决策过程(MDP)的特性,通过对目标函数进行全导数展开,利用策略与状态分布的链式关系,最终消去了难以计算的状态分布梯度项,仅保留可采样的轨迹项。这一关键简化使策略梯度方法具备了实际可行性。PS:策略梯度定理的详细推导涉及较多数学技巧,若你对策略梯度的推导过程非常感兴趣,想提前了解背后的原理。推荐你参考 John Schulman 大神(TRPO、GAE 和 PPO 的作者,这个星球上没有人比他更懂策略梯度)在 2017 年 Deep RL Bootcamp Lecture 上的讲座。
早期的策略梯度算法 REINFORCE(Williams, 1992)正是基于这一原理实现,其完整流程如下:
- 基于当前策略 $\pi_{\theta}$ 采样多条轨迹;
- 计算每条轨迹中每个时刻的累积回报 $G_t$;
- 估计策略梯度$ \hat{g} = \frac{1}{N} \sum_t \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) G_t $
- 执行梯度上升更新$ \theta \leftarrow \theta + \alpha \hat{g} $
REINFORCE(是基于蒙特卡洛采样的策略梯度方法,所谓蒙特卡洛,可以简单理解为 Agent 的采样策略是从开始状态一直到最终状态,采样一个完整的轨迹。一个策略产生轨迹的奖励期望越高,这个策略也自然更好。因此我们用梯度上升方法更新参数时即是:$\theta’ = \theta + \alpha \nabla_\theta L(\theta)$。
接下来我们对梯度进行求解:
\[\begin{align*} \nabla_\theta L(\theta) &= \nabla_\theta \mathbb{E}_{\tau \sim \pi(\cdot|\theta)}[R(\tau)] \quad \text{--- (1)} \\ &= \nabla_\theta \sum_\tau \left[\pi(\tau|\theta) \cdot R(\tau)\right] \quad \text{--- (2)} \\ &= \sum_\tau \left[\nabla_\theta \pi(\tau|\theta) \cdot R(\tau)\right] \quad \text{--- (3)} \\ &= \sum_\tau \left[\pi(\tau|\theta) \frac{\nabla_\theta \pi(\tau|\theta)}{\pi(\tau|\theta)} \cdot R(\tau)\right] \quad \text{--- (4)} \\ &= \sum_\tau \left[\pi(\tau|\theta) R(\tau) \cdot \nabla_\theta \log \pi(\tau|\theta)\right] \quad \text{--- (5)} \\ &= \mathbb{E}_{\tau \sim \pi(\cdot|\theta)}\left[R(\tau) \nabla_\theta \log \pi(\tau|\theta)\right] \quad \text{--- (6)} \\ &= \mathbb{E}_{\tau \sim \pi(\cdot|\theta)}\left[R(\tau) \cdot \sum_t \nabla_\theta \log \pi(a_t|s_t, \theta)\right] \quad \text{--- (7)} \end{align*}\]这其中(1) -> (2)是按照期望的定义展开,(3) -> (4) 是利用了常见的对数变化公式来凑出log的形式,(5) -> (6) 是写为期望的定义。
| 蒙特卡洛(Monte-Carlo/MC)通常和时序差分(Temporal-difference/TD)作为对比概念,一个方差大,一个偏差大,下一节会进行更详细的介绍)算法结构简单,但存在梯度估计方差大的问题,导致收敛速度慢且不稳定。为缓解这一问题,研究者提出了基线调整(Baseline Subtraction)技术,将梯度估计修正为:$ \hat{g} = \sum_{t} \nabla_{\theta} \log \pi_{\theta}(a_t | s_t)(G_t - b(s_t)) $,其中 $ b(s_t)$为基线函数(通常用状态价值函数 $ V(s_t) $ 估计)。理论证明,基线的引入不改变梯度的无偏性,但能有效降低估计方差,显著提升算法稳定性。 |
如果神经网络学的是”打分表”(输入状态,输出每个动作的 Q 值),它就是 Value-Based(如 DQN);如果学的是”行为手册”(输入状态,输出动作的概率分布),它就是 Policy-Based(如 REINFORCE);如果同时学两者——一个网络打分,一个网络选动作——它就是 Actor-Critic(如 PPO)。
对比
同一个策略梯度公式,换一个输出层就能从离散动作空间(比如CartPole 的“向左”/“向右”)切换到与连续动作空间(机器人关节角度)。这就是策略梯度方法比 Value-Based 方法灵活的地方:DQN 的$\arg\max Q$在连续空间中根本算不出来,而策略梯度直接对概率密度求梯度,天然适用于连续空间。
Q-Learning 更新的是价值函数 $Q(s,a)$(“这个动作值多少分”),策略是通过 $\arg\max Q$ 隐式得到的。REINFORCE 直接更新策略参数 $\theta$,跳过了 Q 值这一步。这个区别带来两个关键后果:
- Q-Learning 是 off-policy 的(可以用旧数据反复训练),REINFORCE 是 on-policy 的(必须用当前策略的新数据);
- 经典表格 Q-Learning 和 DQN 通过枚举动作取最大值,而 REINFORCE 可以用连续概率分布直接参数化连续动作。
捋一下
Agent learns to take action to maximize expected reward. 单从训练视角看,RL 和 supervised learning 一样,也可以粗略理解成三步:function with unknown variable;define loss / signal from training data;optimization。
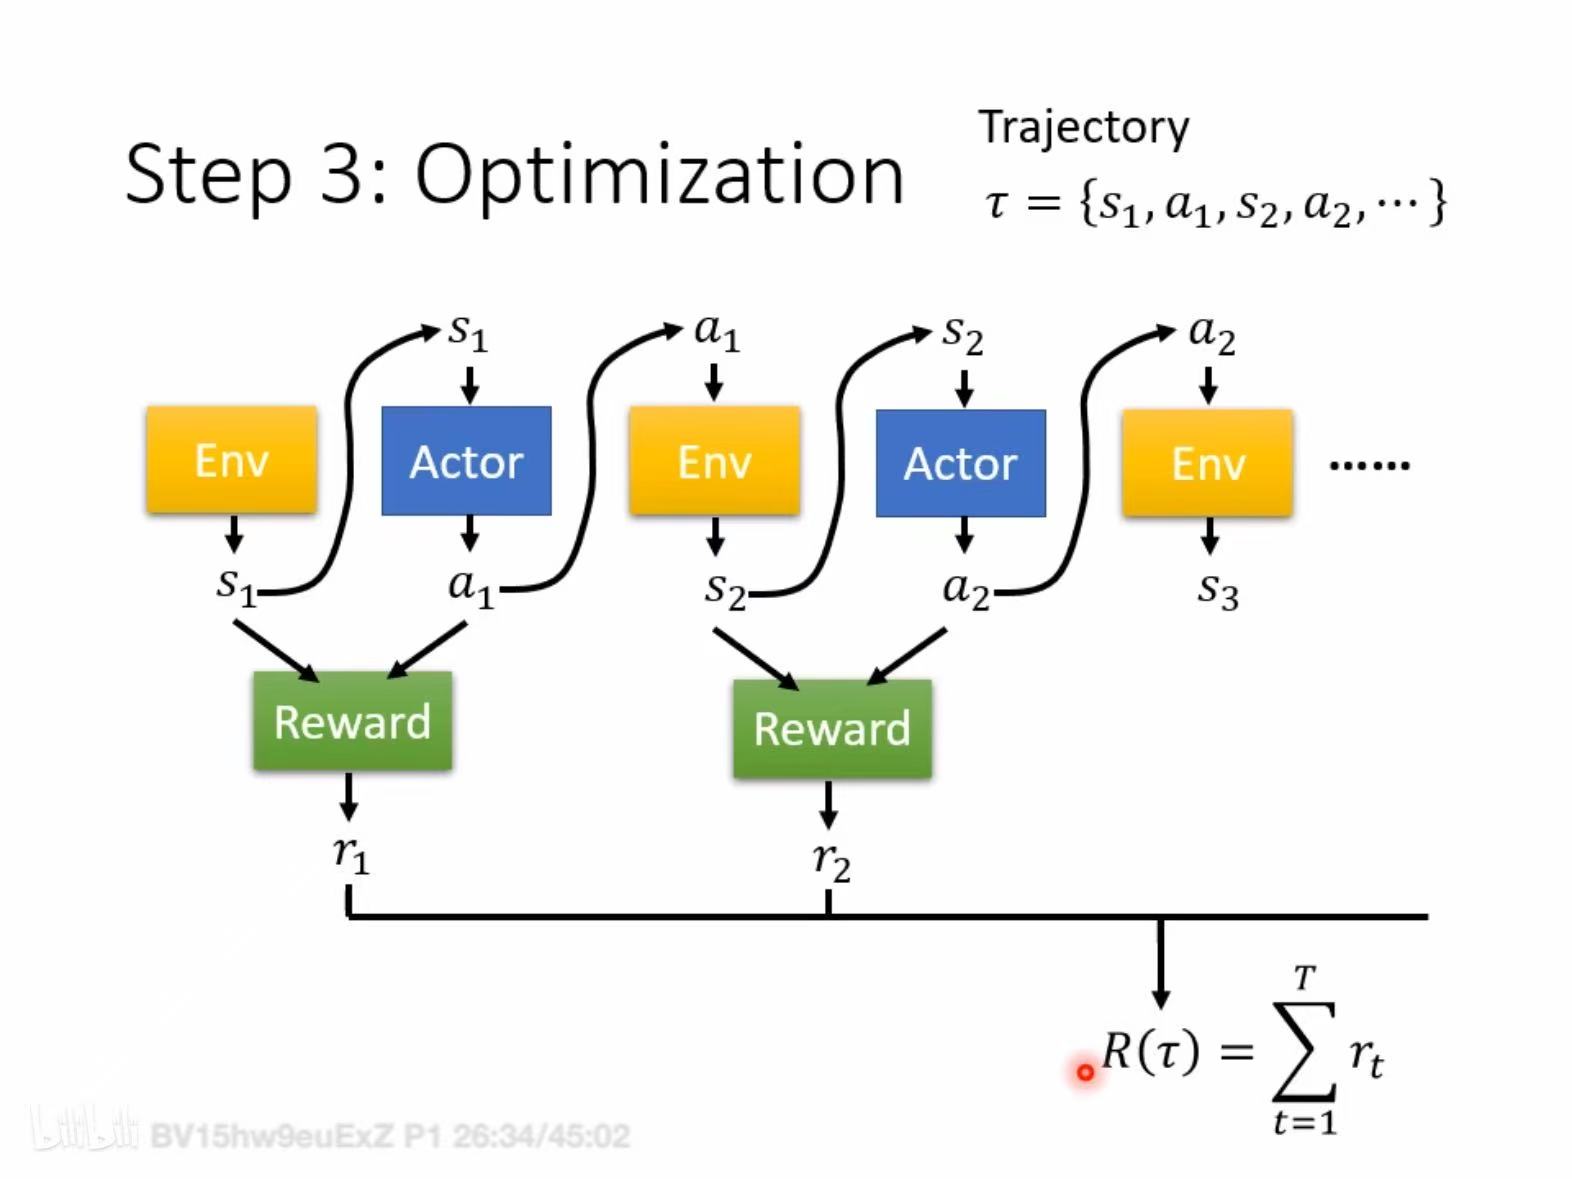
强化学习并不是根据“标准答案标签”来学,而是根据和环境交互得到的反馈来学。它优化的是累积奖励,而不是“这一步对不对”。也正因为如此,RL 往往更难收敛:奖励信号是否准确、参数更新是否平稳、交互环境是否稳定,都会直接影响训练效果。
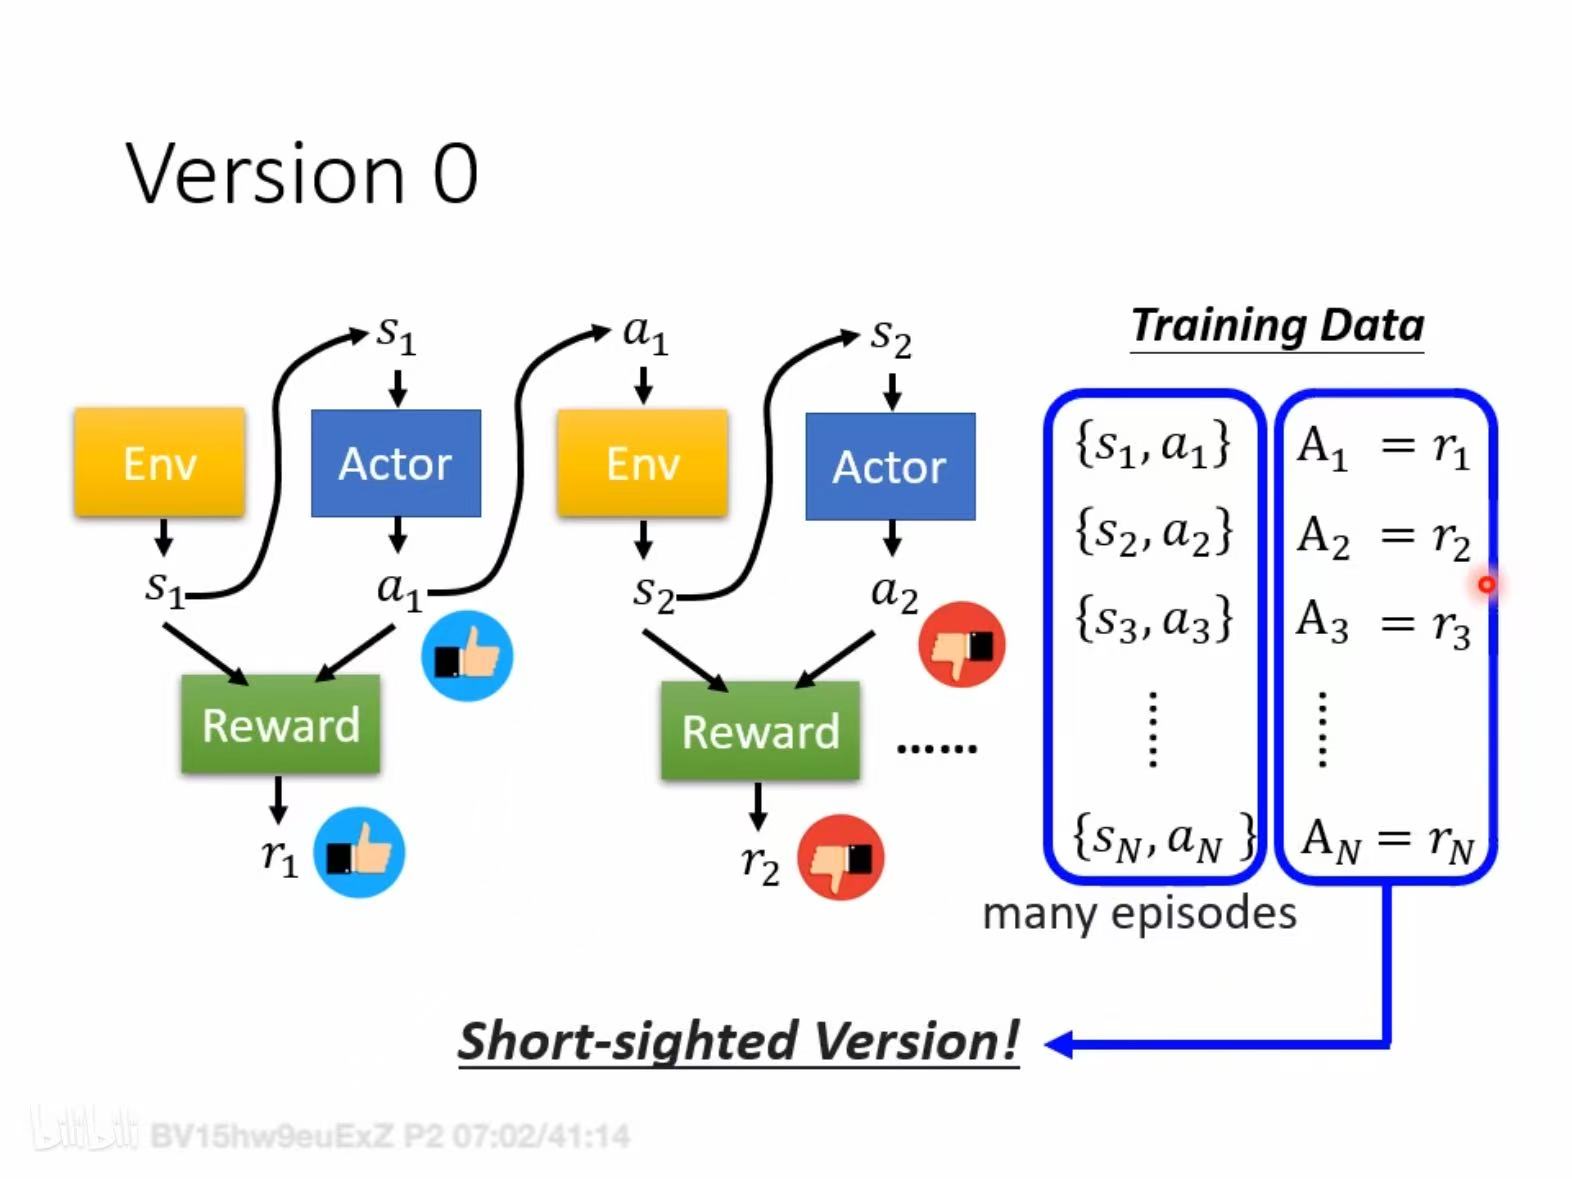
如果你能收集很多<s,a->r> training data, 就可以监督学习Agent(如果agent 是一个network的话),不过一般不直接用r,我们用A来表示你有多希望s时采取动作a,<s,a->A>,在实践中,A有多种表示方式。
- r 直接作为A,缺点是会导致actor 比较短视
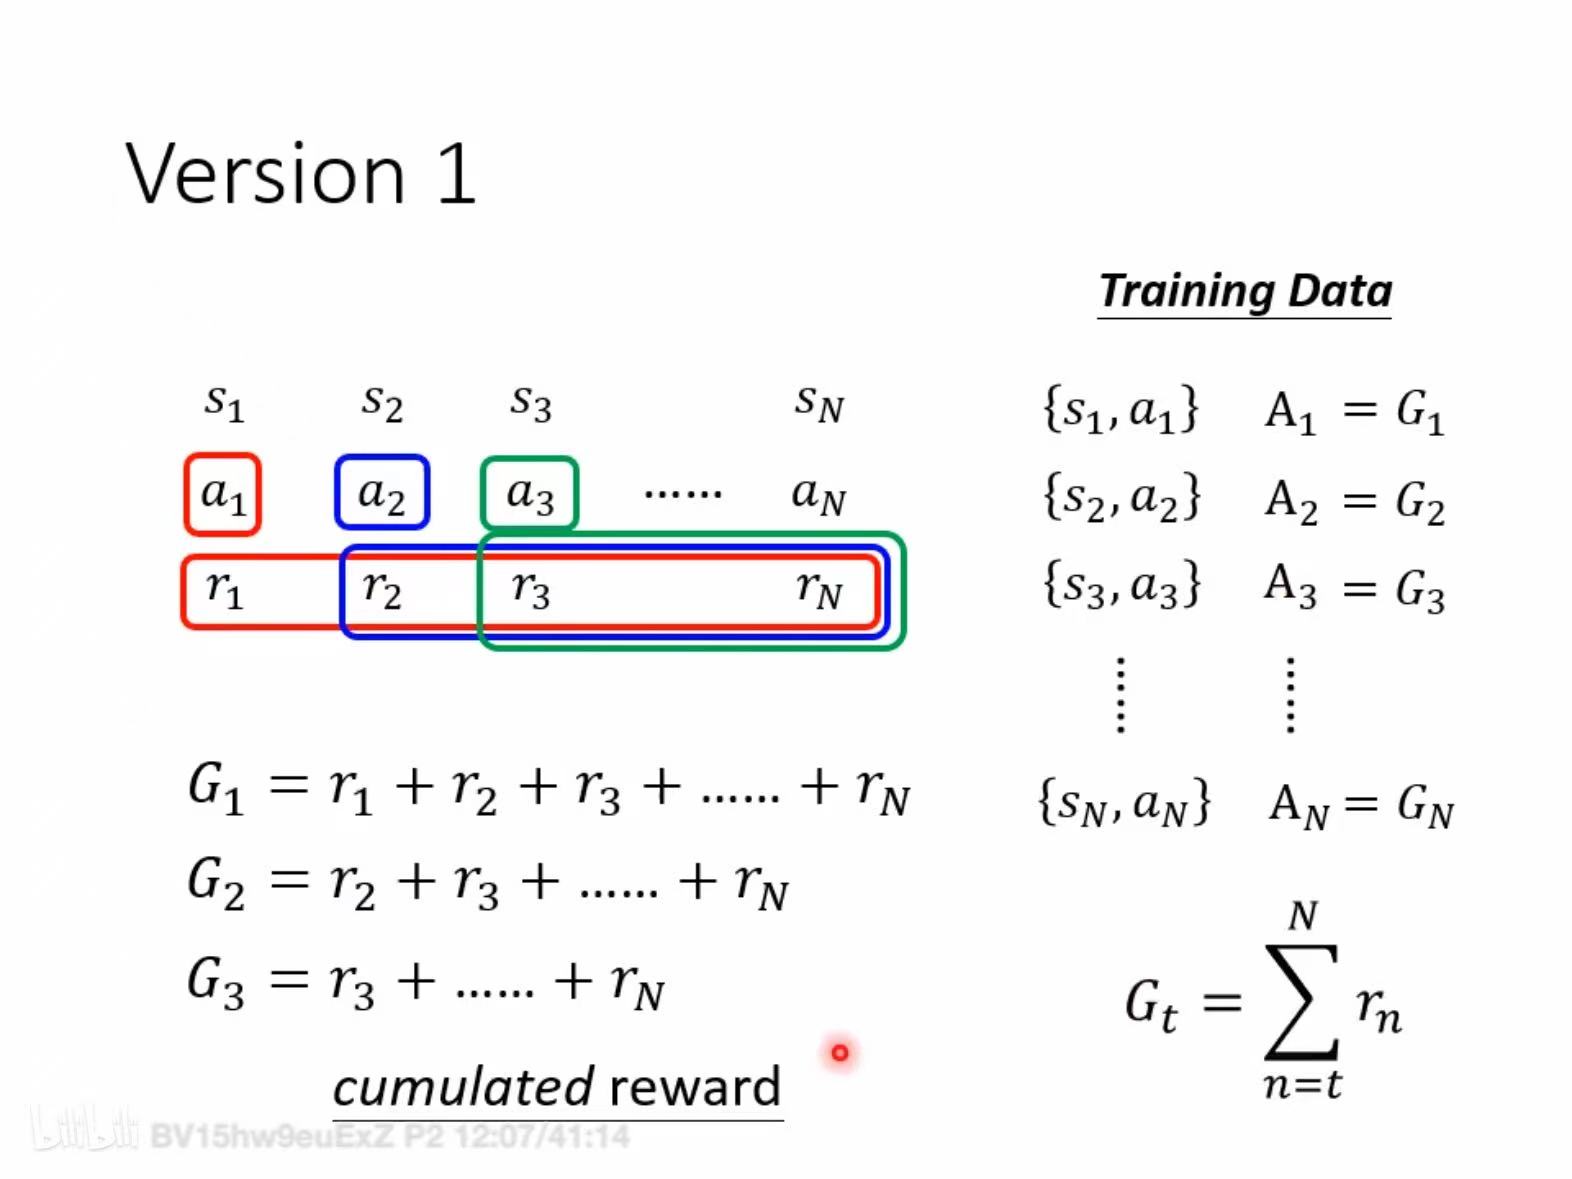
- G 作为A,缺点是越靠前的a的A越大,也不符合实际。
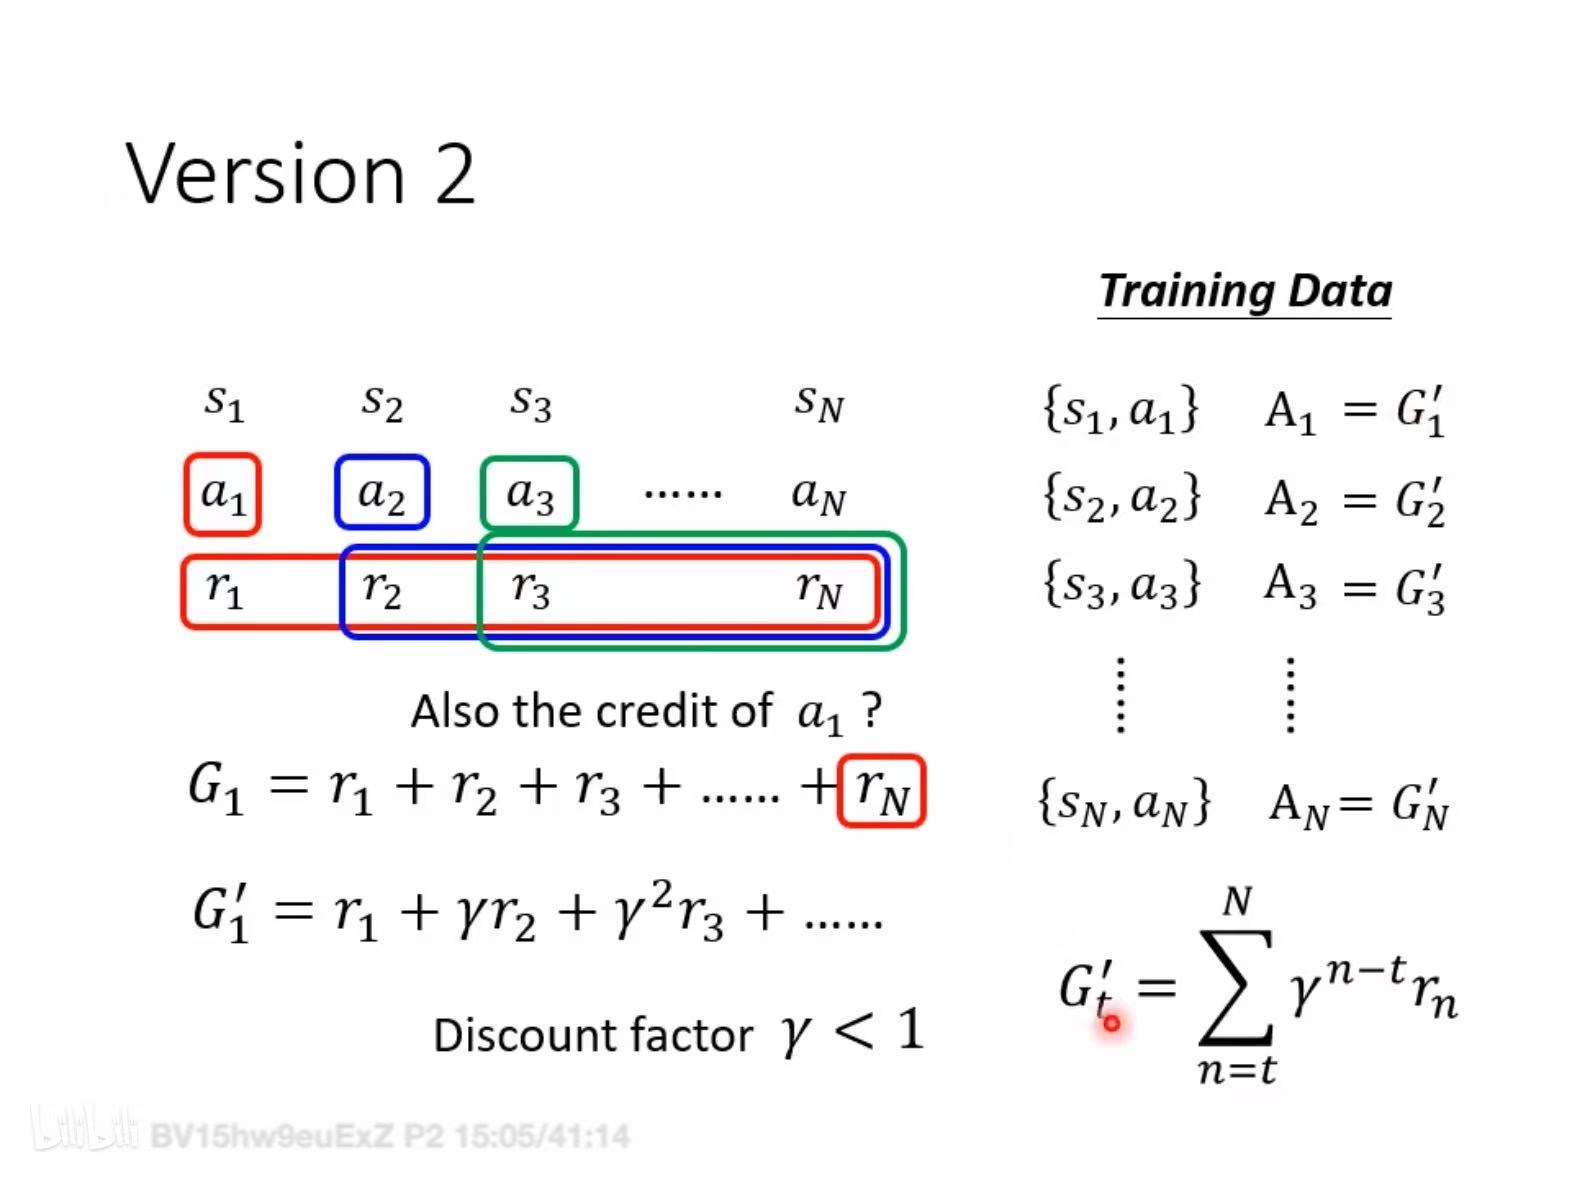
- 离a越远的r打一下折扣
- G是绝对值,不能直接用,比如一次考试你单说考了80分其实说不清楚你考的好与差,所以要对G标准化一下,一个简单的方法是减去一个baseline。,但如何选baseline也有很多花样了(下文会考)。
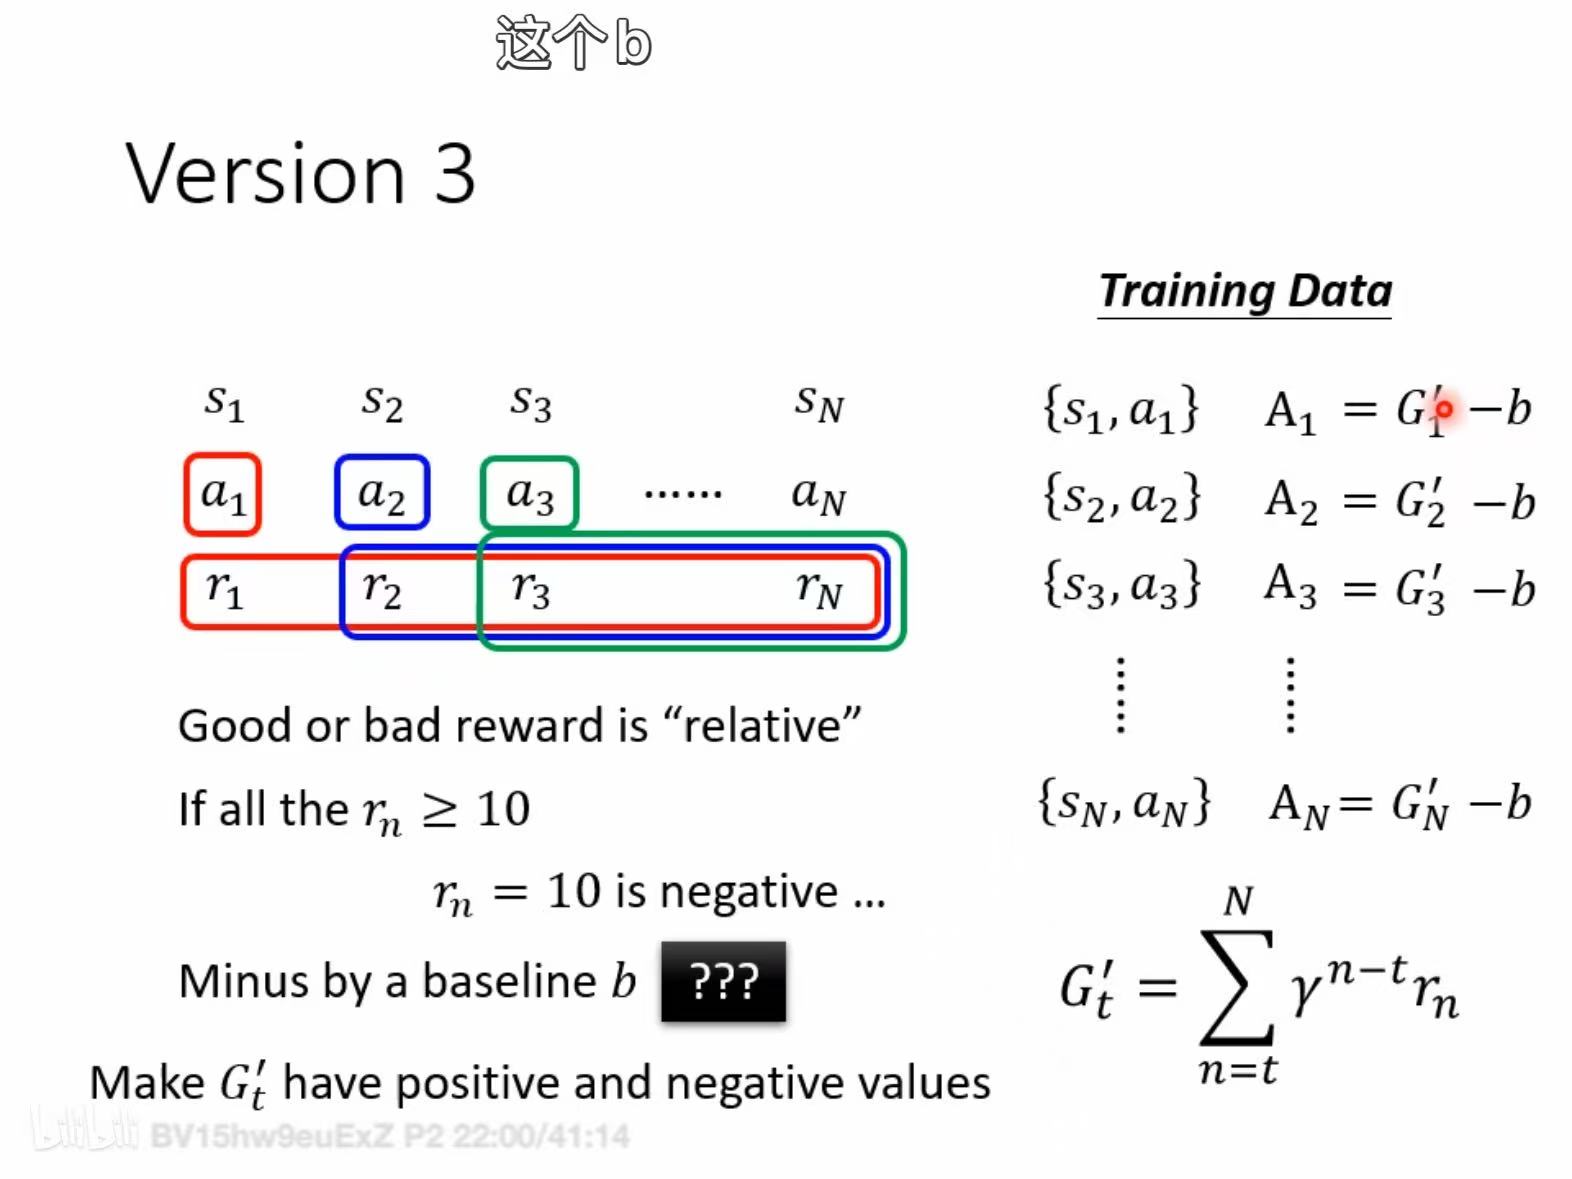
- 但其实这么做还有问题,比如对于下围棋来说,大部分a的$r_i$都是0,最后最后一步的a的r是1(赢)或-1(输)。所以A的花活很多,甚至专门安排一个模型来学习。
留下评论