LLM 强化学习训练链路:从 Rollout、Reward 到 Token Loss 与梯度
简介
- 简介
- RL 基础:LLM post-train 在优化什么
- Rollout:模型生成 response 并获得 reward
- 从 Rollout 数据到 Policy Loss
- Policy Update:用 Loss 更新模型
- 总结:从策略梯度到完整训练链路
- 其它
LLM 本质上不是“输入文字、输出文字”的黑盒,而是一个不断输出“下一个 token 概率分布”的模型。RL 做的事情,就是根据最终 reward,调整生成过程中这些概率分布。
RL 基础:LLM post-train 在优化什么
RL 的训练目标
强化学习的最终目标是什么,一言以蔽之:让LLM在某个评测维度下,rollout的数学期望最大。如何理解呢?评测指的是:当LLM输出了一大堆token,你要怎么eval这个response。这里分为两种
- Verified Reward,例如代码题,数学题,response是可以通过rule based的方法验证的
- Model-based reward,需要LLM as a Judge给出reward 总之,你要有办法eval模型的rollout,最后需要给出一个标量(最新的on-policy distillation不用)。假设某个$\tau$对应的reward很高,那就提高生成那个$\tau$的概率即可,这也就是训练模型的本质。
RL 概念与 LLM 的对应
| RL 概念 | LLM 对应 | |
|---|---|---|
| 状态 (State) $s_t$ | prompt + 已生成的 tokens | |
| 动作 (Action) $a_t$ | 下一个要生成的 token,动作空间即词表 | |
| 策略 (Policy) $\pi_\theta (a_t | s_t)$ | LLM 的推理过程/softmax 后的概率分布/输出分布 |
| 奖励 (Reward) R | 回答质量、格式、正确性、偏好分 | |
| V(s) | 当前上下文下,这条回答最后大概能拿多少分 | |
| A(s,a) | 在这个上下文下,选这个 token 比平均更好多少 | |
| PPO | 别让模型因为一批 reward 数据就把分布改得太激进 |
Rollout:模型生成 response 并获得 reward
从 Prompt 到 Reward
RL 首先让模型正常推理、生成回答,这叫 rollout:
Prompt
  ↓
LLM 自回归生成
  ↓
Response
  ↓
Reward Model / 规则 / 测试程序
  ↓
Reward
以下例子
- Prompt:abc
- 模型生成:def
- 最终 Reward:1
从 Token IDs 到 Logits
LLM 本质上不是“输入文字、输出文字”的黑盒,而是一个不断输出“下一个 token 概率分布”的模型。
- 文本先变成 token ID
- Token ID 查表得到 embedding
- Transformer 计算上下文表示
 embedding
     ↓
 causal self-attention
     ↓
 MLP
     ↓
 多层 Transformer
     ↓
 hidden states
输出形状是:
[B,L,D],Decoder-only LLM 使用 causal mask,保证每个位置只能看到自己和前面的 token。 - LM Head 把 hidden state 变成 logits,输出形状为:
[B,L,D]==>[B,L,V]/[batch, seq_len, vocab_size],其中每个 seq 位置,都有一个长度为 vocab_size 的向量,表示在当前上下文后面,词表中每个 token 作为下一个 token 的评分。注意,logits 还不是概率,经过 softmax才得到下一个 token 的概率分布。 - 注意
logits → sampling → token ID不可微,因为 sampling 把连续概率变成了离散整数。因此,RL 不是让梯度穿过整个生成过程。 - 从 Logits 到 Token
- 然后token 追加到prompt,循环往复,得到def。
从 Rollout 数据到 Policy Loss
Rollout 负责采样 response 并获得 reward;训练负责把 reward 变成可微的 loss,再用这个 loss 更新模型参数。下面继续使用同一个例子:prompt 是 abc,模型生成 def。
Rollout 时会保存:
- response token IDs
- 每个 token 当时的 log-prob,例如
d:log π_old(d | abc) = -0.51 e:log π_old(e | abcd) = -0.92 f:log π_old(f | abcde) = -0.36 - 最终 reward
SFT 与 RL 的训练信号对比
在llm 语境下,动作空间 = 词表(离散),预测token是一个多分类问题。SFT是针对Token级别的反馈(对token进行优化和反向传播,每一个token相同的贡献),而RL是针对整个答案文本的评价(对整个语句进行优化和反向传播)。
- sft的优化逻辑。逐 token 模仿学习(偏向语言建模),
- Loss 计算方式:常用交叉熵损失(Cross-Entropy Loss)。 \(loss_t = -logP_\theta(y_t \mid y_{<t}, x)\) \(\text{Loss} = -\frac{1}{N} \sum_{t=1}^{N} \log P_{\theta}(y_t \mid y_{<t}, x)\) $y_t$是真实token,$y<t$ 是前面生成的 token,N 是 token 数量。
- 反向传播:整个 response 的所有 token loss 加起来(通常是 求和 或 平均),这样 response 的 loss 就是一个 标量,再进行反向传播。所以每个 token 的贡献是均等的。
- 例如输入 “User: 你好\nAssistant: 我很好”,在监督微调时,模型预测 “我” 的概率与标注答案比对,计算 loss。预测 “很” 的概率与真实答案比对,再计算 loss……依次类推。训练过程就是让模型学会模仿人工答案的逐 token 分布。
- RLHF优化逻辑。整句优化(偏向人类偏好)。
- 训练目标不是让模型模仿 token,而是让整个 句子/输出序列 的质量更高(即 reward 更大)。
- Loss 计算方式:用 Policy Gradient (策略梯度) 方法,比如 PPO。梯度更新时,reward 对 整条输出序列 贡献一个分数。每个 token 的更新权重不再是均等的,而是由策略概率分布 + reward 信号共同决定,比如ppo每个 token 的更新强度 = 优势 $A_t$ × 概率比 $r_t(\theta)$。如果 token 在新策略里更被偏好($r_t$ > 1),且 reward 较高,则这个 token 的梯度被放大。如果 token 导致 reward 低,则会被削弱。每个 token 并不是直接用 cross-entropy,而是有权重的负 log 概率: \(\text{loss}_t = - A_t \cdot \log p_{\theta}(y_t \mid y_{<t})\) $A_t$ 是 advantage(整条序列的 reward 减 baseline),$\pi_{\theta}$是当前策略概率,每个 token 的“loss”本质上是 带权重的负 log 概率。
- 反向传播:把整个序列(甚至整个 batch)的所有 token loss 求和/平均,反向传播 → 更新参数。不是逐 token 单独更新,而是 序列/batch 一次性反向传播。
- 在实现层面,无论 SFT 还是 PPO,都会对每个 token 算 loss,然后反向传播梯度。区别只是:SFT 的 loss 是“平均的负 log prob”,而 PPO/GRPO/GSPO 的 loss 在“负 log prob”前面多了一个权重(advantage/reward)。
Log-prob:连接概率与梯度
log-prob 是连接概率世界和梯度世界的桥梁,是强化学习中“概率 → 损失 → 梯度”转化的关键中介。
$\pi_\theta(y_t|x, y_{<t})$ 模型给 token y_t 的概率,那么 $\text{log-prob}(y_t) = \log \pi_\theta(y_t|x, y_{<t})$ 是模型给出该 token 的对数概率。取对数的原因主要有三个:
- 数值稳定性。概率常常非常小(例如 $10^{-6}$),而对数后能避免下溢:$\log(10^{-6}) = -13.8$
- 便于求和。序列的整体概率是 token 概率的乘积:$P(y|x) = \prod_t \pi_\theta(y_t|x, y_{<t})$ 对数后变成可加形式: $\log P(y|x) = \sum_t \log \pi_\theta(y_t|x, y_{<t}) $ 方便计算和优化。
- 梯度友好。对数使得梯度公式简洁: 比如在策略梯度中,$\nabla_\theta \log \pi_\theta(a_t|s_t) $形式简单且方向正确。
一个 Reward 如何变成每个 Token 的 Loss
Reward 不是 token label。它不会告诉模型“第 3 个 token 应该改成什么”,而是告诉模型:这条采样轨迹里的 action,以后应该更容易出现还是更不容易出现。
def 的生成概率可以分解为:
取对数后,序列 log-prob 变成各 token log-prob 之和:
\[\log\pi_\theta(def\mid abc) = \log\pi_\theta(d\mid abc) +\log\pi_\theta(e\mid abcd) +\log\pi_\theta(f\mid abcde)\]直观地说,一段回答虽然只得到一个总分,却由多个 token 选择共同组成。整段回答的概率是这些 token 在各自上下文中被选中概率的连乘;取 log 后,连乘变成各 token log-prob 的相加,于是调整整段回答的概率,就能拆成对各个已生成 token log-prob 的调整。策略梯度把“最大化期望 reward” 转化为用 reward / Advantage 加权已采样序列的 log-prob,reward/Advantage 因而可以作用到每个已采样 token。reward 不需要变成 token label,只需要成为这些 log-prob 的权重。这就是 sequence reward 能够作用到 token loss 的桥梁。训练时通常先减去 baseline,得到 Advantage:
\[A=R-b\]- $A>0$:回答比预期好,提高已采样 action 的概率。
- $A<0$:回答比预期差,降低已采样 action 的概率。
-
$ A $ 越大:更新力度越大。
然后用 Advantage 加权每个已采样 token 的 log-prob:
\[L_t=-A_t\log\pi_\theta(y_t\mid x,y_{<t})\]对于最简单的 response-level Advantage,整条回答共用一个 $A$。例如 $A=0.8$:
d:A_d = 0.8
e:A_e = 0.8
f:A_f = 0.8
整条 response 的 loss 为:
\[L=-\frac{0.8}{3}\left[ \log\pi_\theta(d\mid abc) +\log\pi_\theta(e\mid abcd) +\log\pi_\theta(f\mid abcde) \right]\]对这个 loss 做梯度下降时,$A>0$ 会提高 d/e/f 在各自上下文中的概率,$A<0$ 则会降低它们的概率。每个位置虽然只取实际生成 token 的 log-prob,但 softmax 的分母包含整个词表,因此同一位置的其他 vocabulary logits 也会收到梯度。
不同算法如何构造 Token 级优化信号
不同算法主要就发力在这个阶段:同样拿到 rollout 数据后,如何估计 Advantage、是否引入新旧策略的概率比、这些量作用在 token 还是 sequence 粒度,以及最终如何聚合成 policy loss。policy loss 一旦聚合成标量,后面的自动微分、反向传播和参数更新机制基本相同。
这里要区分按 token 计算 loss和token-level credit assignment,也要区分“Advantage 是否相同”和“token loss 是否相同”:
| 算法 | Token Advantage | 概率比与约束粒度 | Token loss |
|---|---|---|---|
| REINFORCE | 常共享整条轨迹的 return,或减去 baseline 后的结果 | 通常没有 importance ratio | 通常不同,因为各 token 的 log-prob 不同 |
| GRPO | 一条 response 的 token 共用组内相对 Advantage $A_i$ | 通常使用 token-level ratio 和 clip | 通常不同,因为各 token 的 log-prob / ratio 不同 |
| PPO + GAE | 不同位置可以得到不同的 $A_t$ | 使用 token-level ratio 和 clip | 通常不同,Advantage 和 ratio 都可能不同 |
| GSPO | 一条 response 通常共用组内相对 Advantage $A_i$ | 使用 sequence-level ratio 和 clip | 按 sequence 聚合,不宜理解成每个 token 的 loss 相同 |
因此,GRPO 中“一条 response 的 token 共用同一个 Advantage”,不等于“每个 token 的 policy loss 相同”。前者仍然是 response-level 反馈;只有不同位置获得不同的有效信号时,才有更细的 token-level credit assignment。
Policy Update:用 Loss 更新模型
重新 Forward,但不再重新生成
Rollout 完成后,训练系统已经拥有完整的 prompt + response。Policy update 会把这段已知序列重新送进当前待训练的模型,计算每个已生成 token 的 log-prob;这次 forward 不会重新 sampling,response token IDs 仍然使用 rollout 的结果。之所以需要重新 forward,是因为 rollout 通常运行在 no_grad 下,甚至由独立推理引擎完成,不会保留反向传播需要的计算图。
PPO 中还要区分:
old_logprob:rollout 时旧策略产生这些 token 的概率,采样后固定不变。current_logprob:policy update 时用当前参数重新计算,保留梯度。
执行 optimizer.step() 后,当前策略已经改变;如果继续复用同一批 rollout 做 PPO epoch,就要再次 forward 得到新的 current_logprob,而 old_logprob 仍保持不变。
Full-sequence Forward 如何得到 Token Log-prob
Rollout 时,后面的 token 还未知,所以模型必须自回归 decode:
abc   -> d
abcd  -> e
abcde -> f
进入 policy update 时,def 已经生成完毕。它仍然是一个 rollout 样本,不是 abc → d、abcd → e、abcde → f 三个独立样本。此时可以把完整的 abcdef 一次送入模型;causal mask 保证每个位置看不到未来 token,同时 GPU 可以并行计算各个位置的 hidden state 和 logits:
c 位置的 logits → 预测 d
d 位置的 logits → 预测 e
e 位置的 logits → 预测 f
语言模型的输出与目标相差一个位置:
input token: a  b  c  d  e  f
预测目标:    b  c  d  e  f  ?
Rollout 保存的 response token IDs 在这里充当索引,用来从重新计算的 logits 中 gather 对应 token 的 log-prob。整数 ID 本身不需要梯度,真正连接 loss 与模型参数的是重新 forward 得到的 log-prob。
实现中先做 next-token shift,再根据实际生成的 token id,从 vocabulary 维度取出对应的 log-prob:
input_ids = torch.cat([prompt_ids, response_ids], dim=1)  # [B, L]
logits = policy(input_ids).logits                         # [B, L, V]

next_token_logits = logits[:, :-1, :]                     # [B, L-1, V]
target_ids = input_ids[:, 1:]                             # [B, L-1]
per_token_logps = torch.log_softmax(next_token_logits, dim=-1)
chosen_logps = torch.gather(
    per_token_logps,
    dim=-1,
    index=target_ids.unsqueeze(-1),
).squeeze(-1)                                             # [B, L-1]
然后用 response mask 排除 prompt 和 padding,只留下 d/e/f:
目标 token: b  c  d  e  f
mask:       0  0  1  1  1
一次 forward 就同时得到:
\[\log\pi_\theta(d\mid abc),\quad \log\pi_\theta(e\mid abcd),\quad \log\pi_\theta(f\mid abcde)\]完整的 shape 变化是:
logits               [B, L, V]
    ↓ shift + log_softmax + gather
chosen log-probs     [B, L-1]
    ↓ response mask
response log-probs   [B, T]
    ↓ × Advantage,求和或平均
scalar loss          []
最后,(backward() 最终要求一个标量)将 response / batch 中所有有效 token 的 loss 聚合(求和或平均)成一个 scalar loss。
Loss 怎样通过梯度修改模型
得到 scalar loss 后,后面的过程就是普通的神经网络训练:
scalar loss
    ↓ backward
log-prob
    ↓ log_softmax + gather 的反向传播
logits [B,L,V]
    ↓ LM Head
最后一层 Transformer
    ↓ Attention、MLP、Norm
前面的 Transformer 层
    ↓ Embedding lookup
输入 Embedding
    ↓ optimizer.step()
更新后的模型参数
反向传播会先计算 loss 对 chosen log-prob 的梯度,再继续传到 logits、LM Head、Transformer 和 Embedding 等可训练参数。优化器最终执行 $\theta \leftarrow \theta-\eta\nabla_\theta L$,让模型的概率分布发生一次小幅变化。
哪些环节没有梯度
整条链路中,并非每一步都必须可导:
- tokenizer 的文本切分和 ID 转换没有梯度;
- rollout 中的 sampling 是离散选择,没有梯度;
- decode 只是把 token IDs 还原成文本,没有梯度;
- reward model、规则程序或人工评价不在 policy 的反向传播路径上;
- response token IDs 只记录采样结果,并在 gather 时充当索引。
真正承载梯度的是 policy update 阶段重新 forward 得到的 logits 和 log-prob。RL 用 reward / Advantage 构造关于这些 log-prob 的 loss,从而绕开不可导的 sampling 和外部评价过程。
Rollout 与 Policy Update 的计算方式不同
因此,rollout 是逐 token decode,policy update 是 full-sequence forward + backward;“一次计算全部 token”指训练时并行算出所有位置的 log-prob,不是一次并行生成完整 response。
总结:从策略梯度到完整训练链路
从通用策略梯度到 Token-level Objective
如果从通用 RL 的视角往 LLM post-train 过渡,最自然的起点还是策略梯度。
一些基础概念,放到 LLM 语境里可以这样理解:
- $\pi$(Policy,策略):即 LLM 模型
- $\theta$(Parameter,参数):即模型参数
- $s$(State,交互状态):即上文,初始状态可以看成 $s_1$
- $a$(Action,交互行为):即输出的 token
- $\tau$(Trajectory,轨迹):$\tau = { s_1,a_1,r_1,s_2,a_2,r_2,\dots,s_T,a_T,r_T }$
Reward Function(奖励函数)用于评估某个状态 / 动作序列的好坏:
\[R(\tau) = \sum_{t=1}^{T} r_t\]因为同一个上下文下,模型并不一定每次都输出同样的 token,所以每条轨迹 $\tau$ 都有自己的采样概率,通常记作 $p_\theta(\tau)$。于是,模型参数 $\theta$ 下的期望奖励可以写成:
\[\overline{R}_\theta = \sum_{\tau} R(\tau) p_\theta(\tau)\]策略梯度希望做的,就是调整模型参数 $\theta$,让这个期望奖励尽可能大。通过 log-trick,优化目标会逐步从“整条轨迹的奖励”拆到“每一步 action 的对数概率”上。也正是从这里开始,RL for LLM 才真正走向 token 级训练信号。
但 LLM 场景有一个很具体的问题:奖励通常是 sequence-level 的,也就是整段回答结束以后才拿到一个 scalar reward。reward 只能告诉我们“哪条输出整体更好”,却不能天然告诉我们“这条输出里的每个 token 分别该负多大责任”。因此,真正困难的并不是写出一个 sequence-level 的目标,而是如何把这个目标稳定地拆成 token-level 的优化信号。
这也是为什么在 LLM RL 中,常常会看到下面这条主线:
- 先有 sequence-level reward
- 再减去 baseline,得到相对好坏
- 再用 Critic / GAE / group relative reward 等方式,把它变成更稳定的 Advantage
- 最后再把 Advantage 乘到每个 token 的 $\log \pi_\theta(a_t \mid s_t)$ 上
一句话概括这条主线:样本拿到的是一个绝对、序列级、每条一个的标量 reward;真正用来更新模型的是 Advantage 加权后的逐 token loss。
\[\underbrace{R(\tau)}_{\text{绝对、序列级、给定}}\ \xrightarrow{\ \text{减 baseline}\ }\ \underbrace{A}_{\text{相对好坏}}\ \xrightarrow{\ \text{加权 log-prob}\ }\ \underbrace{L_t}_{\text{逐 token loss}}\]这里必须区分两个容易混淆的概念:loss 是按 token 计算的,不代表 Advantage 一定具有 token 级的差异。在 PPO + Critic/GAE 中,通常可以为不同 token 估计不同的 $A_t$;在 GRPO 中,先计算整条 response 的 $A_i$,然后把同一个 $A_i$ 广播给这条 response 的所有 token。后者虽然也会产生逐 token loss,但本质上仍然是 response-level Advantage,没有精细解决 token 之间的 credit assignment。
完整训练链路
最后把完整链路压缩成一张图:
文本 Prompt
    ↓ tokenizer
token IDs
    ↓ embedding + Transformer + LM Head
logits [B,L,V]
    ↓ softmax + sampling
response token IDs
    ↓ decode / reward model / 规则
sequence reward [B]
    ↓ baseline / group normalization / critic
Advantage [B] 或 [B,T]
    ↓

重新 forward:prompt + response
    ↓
new logits [B,L,V]
    ↓ log_softmax + gather 已生成 token
chosen log-probs [B,T]
    ↓ × Advantage × response mask
token loss [B,T]
    ↓ sum / mean
scalar loss
    ↓ backward
LM Head、Transformer、Embedding 的参数梯度
    ↓ optimizer.step()
更新后的模型参数
    ↓
以后生成更高 reward token 序列的概率上升
模型推理负责“根据 logits 采样出 token”;reward 负责评价整条 token 序列;policy loss 再使用这些已采样 token 对应的 log-prob,把评价转化为梯度,最终改变模型以后产生 logits 的方式。
其它
RL for LLM本质理解大型语言模型的演进,长期以来依赖于标准的监督学习(Supervised Learning)范式,主要体现在预训练(Pretrain)和指令微调(SFT)两个阶段。该范式的核心在于,模型需要依赖人类给出的、从输入到输出的完整监督信号进行学习。若要仅凭此路径达到通用人工智能(AGI)的高度,必须满足两个近乎理想化的前提条件:
- 监督数据的无限性与完备性:数据量级需趋于无穷,且其分布能覆盖所有可能遇到的问题,以确保模型的全知性。
- 监督信号的绝对完美性:所有监督数据必须准确无误,不存在任何错误或偏见,以确保模型的正确性。 然而,在现实中,这两点均难以实现。一方面,高质量的人类标注数据已出现“数据瓶颈”,其生产成本高昂且效率有限(我们已经用完了几乎所有的互联网信息,把人类历史上所有的数据都压缩到了模型之中,现在我们已经只能依靠标注数据和合成数据勉强提升模型的性能了)。另一方面,人类知识本身存在边界(如许多科学未解之谜),且在标注过程中不可避免地会引入错误和主观偏见。因此,探索一种能够突破上述局限性的新扩展方法(scaling method)势在必行。这种新方法需要满足:
- 数据能够以更高效、低成本的方式进行规模化扩展。
- 对监督信号的依赖可以放宽,不再要求“专家级别”的完美答案。
RL之所以被视为LLM持续进化的关键,源于其两个显著特征:
- 数据由模型与环境交互自发生成:这从根本上解决了数据来源的限制,为模型的持续学习提供了近乎无限的原材料。
- 监督信息从“生成式”退化为“验证式”:RL的核心是奖励信号(reward),它不要求监督者提供完美的“专家答案”,而只需对模型生成的答案进行有效性或质量的“验证”。基于“验证答案的难度远低于生成答案”这一基本事实,RL大幅降低了对监督信息质量和标注难度的要求
图解大模型RLHF系列之:人人都能看懂的PPO原理与源码解读 文章后半部分没有跟上。
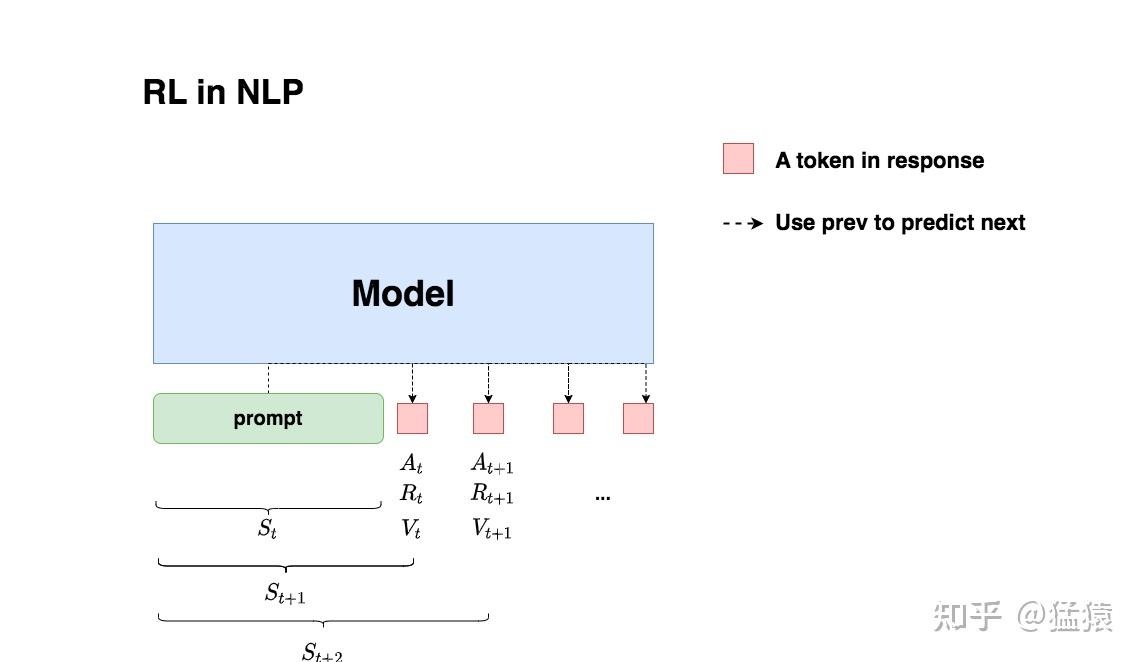 强化学习在LLM中的应用:给定prompt,调整policy,生成符合人类喜好(RM偏序信号)的response
- 状态S:输入prompt
- 在t时刻,模型根据上文,产出一个token,这个token即对应着强化学习中的动作,我们记为$A_t$。因此不难理解,在llm语境下,强化学习任务的动作空间就对应着词表。
- 在 t时刻,模型产出token $A_t$ 对应着的即时收益为 $R_{t}$,总收益为$V_{t}$ ,这个收益即可以理解为“对人类喜好的衡量”。此刻,模型的状态从 $S_{t}$变为$S_{t+1}$,也就是从“上文”变成“上文 + 新产出的token”
- 在llm语境下, 智能体是语言模型本身,环境则对应着它产出的语料
从trpo,ppo开始到后来的AWR,CFGRL,其实核心思想都是一样的:在“不要离旧策略太远”的前提下,尽可能把策略往更优的方向推一小步。这些方法最后的统一更新方式基本上可以写成:
\(\nabla_\theta \mathcal{L}_{\text{actor}} \approx -\mathbb{E}\big[w(s, a)\, \nabla_\theta \log \pi_\theta(a|s)\big].\) 这个目标是很多方法的“共同祖先”,但不同方法会在不同层面做近似。
- Policy Gradient, $\hat{A} > 0$ 增大这个动作概率, $\hat{A} < 0$ 减小这个动作概率。 \(w_{\text{PG}}(s, a) = \hat{A}(s, a)\)
- PPO,对naive的policy gradient乘上了一个因子/ratio $r_\theta(s, a)$, 并且对因子做了截断/clip。 PS:ratio clip \(w_{\text{PPO}}(s, a) = r_\theta(s, a)\hat{A}(s, a)\)
- GRPO,沿用 PPO 那套 ratio×clip,唯一差别是 $\hat{A}$ 不再来自 critic+GAE,而是组内相对的归一化优势(同一条输出 $o_i$ 的所有 token 共用这一个 $\hat{A}_i$)。 \(w_{\text{GRPO}}(s, a) = r_\theta(s, a)\,\hat{A}_i,\quad \hat{A}_i = \frac{r_i - \text{mean}}{\text{std}}\)
所以 PG → PPO → GRPO 在这张“共同祖先”表里,差的其实只有 $w$ 里那两件事:要不要乘 ratio(带 clip)、以及 $\hat{A}$ 从哪来(裸 return / critic+GAE / 组内相对)。
(DPO 不在这条线上:它是离线偏好优化,直接在 $(y_w, y_l)$ 偏好对上做闭式优化,绕开了 rollout 和 reward model,没有“采样 → 加权 $\log\pi$”这一步。硬要类比,它的梯度也能写成“按隐式奖励差给 $\log\pi$ 加权”,但那是另一支,不和 PG/PPO/GRPO 共享同一个在线祖先——这也呼应前面说的 DPO 只能定性 a>b、给不出“好多少”。)
PS:在强化学习中,模型的输出概率被称为模型的策略。无论我们如何训练LLM,不变的部分是其输入空间(提示词的字符串)和输出空间(所有token组成的词表)。在有了RLHF这一步之后,llm就不仅仅是统计模型。
留下评论