模型如何学习多种合理答案:多峰分布与生成模型
- 前言
- 为什么一个输入会有多个合理答案
- 从预测一个值到学习分布
- 生成顺序:AR 与 NAR
- VAE:通过潜变量表达多种可能
- GAN:通过对抗训练学习生成分布
- Diffusion:通过逐步去噪生成样本
- Flow Matching:通过 velocity regression 学习生成过程
- 生成领域的强化学习
- 小结
前言
人的直觉 “根据文字,一次前向计算直接生成图片”
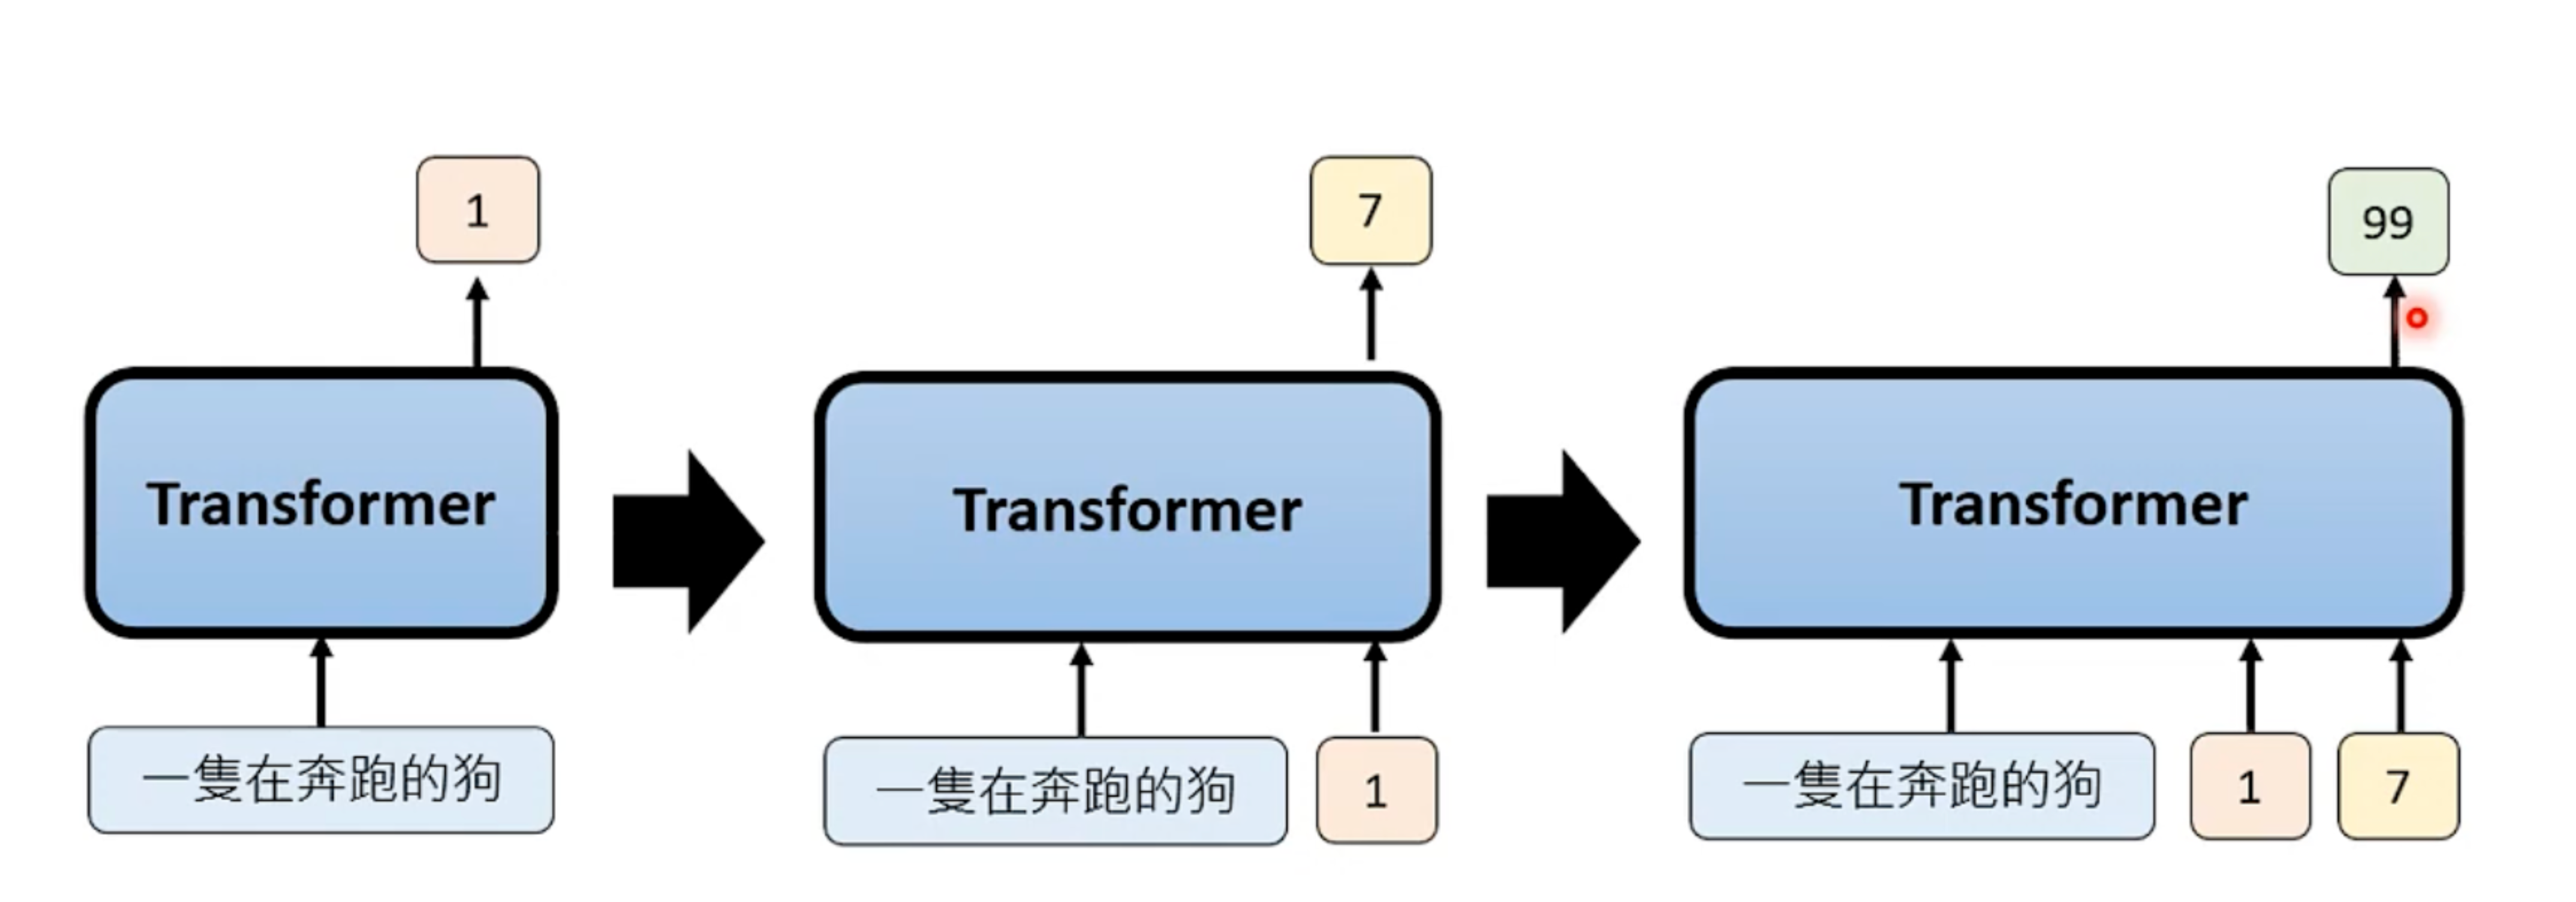
\[\text{Text} \xrightarrow{\text{Encoder}} c \xrightarrow{\text{生成网络}} \text{Image}\]比如一张 $256\times256$ 的 RGB 图片,本质上就是一个 256 × 256 × 3 的数组。NN 完全可以输出这么多数字(文字接龙 ==> 像素接龙/patch接龙),就是接龙次数有点多,图片越高清推理次数越多,1024 * 1024的图片要100w次,《红楼梦》也就是9xw字。使用 patch 或压缩后的 image token 可以缩短序列,但仍有串行依赖。因此,一条重要路线是 Non-autoregressive Generation(NAR):平行运算/一次生成所有基本单位。
同一个条件可以对应多种合理结果
          ↓
需要学习分布,并能从中采样
          ↓
VAE:能否通过潜变量表达不同结果?
GAN:能否让判别器教会生成器?
Diffusion:能否把生成转化成可监督的去噪任务?
Flow Matching:能否直接监督从噪声到数据的变化速度?
为什么一个输入会有多个合理答案
还有一个问题在于:拿什么作为训练目标? “猫的图片”没有唯一正确答案(所以说一图胜千言)。同一句“生成猫的图片”,可以对应:
- 正面的白猫。
- 侧面的橘猫。
- 躺着的黑猫。
- 不同背景、姿势、光照的猫。
如果让确定性网络 $f_\theta(c)$ 根据文字直接输出一张图片,这属于 Point Estimation(点估计)。采用像素误差训练:$L=|f_\theta(c)-x_{\text{真实图片}}|^2$,模型可能被要求:对相同或相似的文字输入,同时接近很多差异很大的图片。平方误差倾向于条件平均。不同猫的轮廓、位置、颜色平均起来,可能只剩一团模糊的影子。
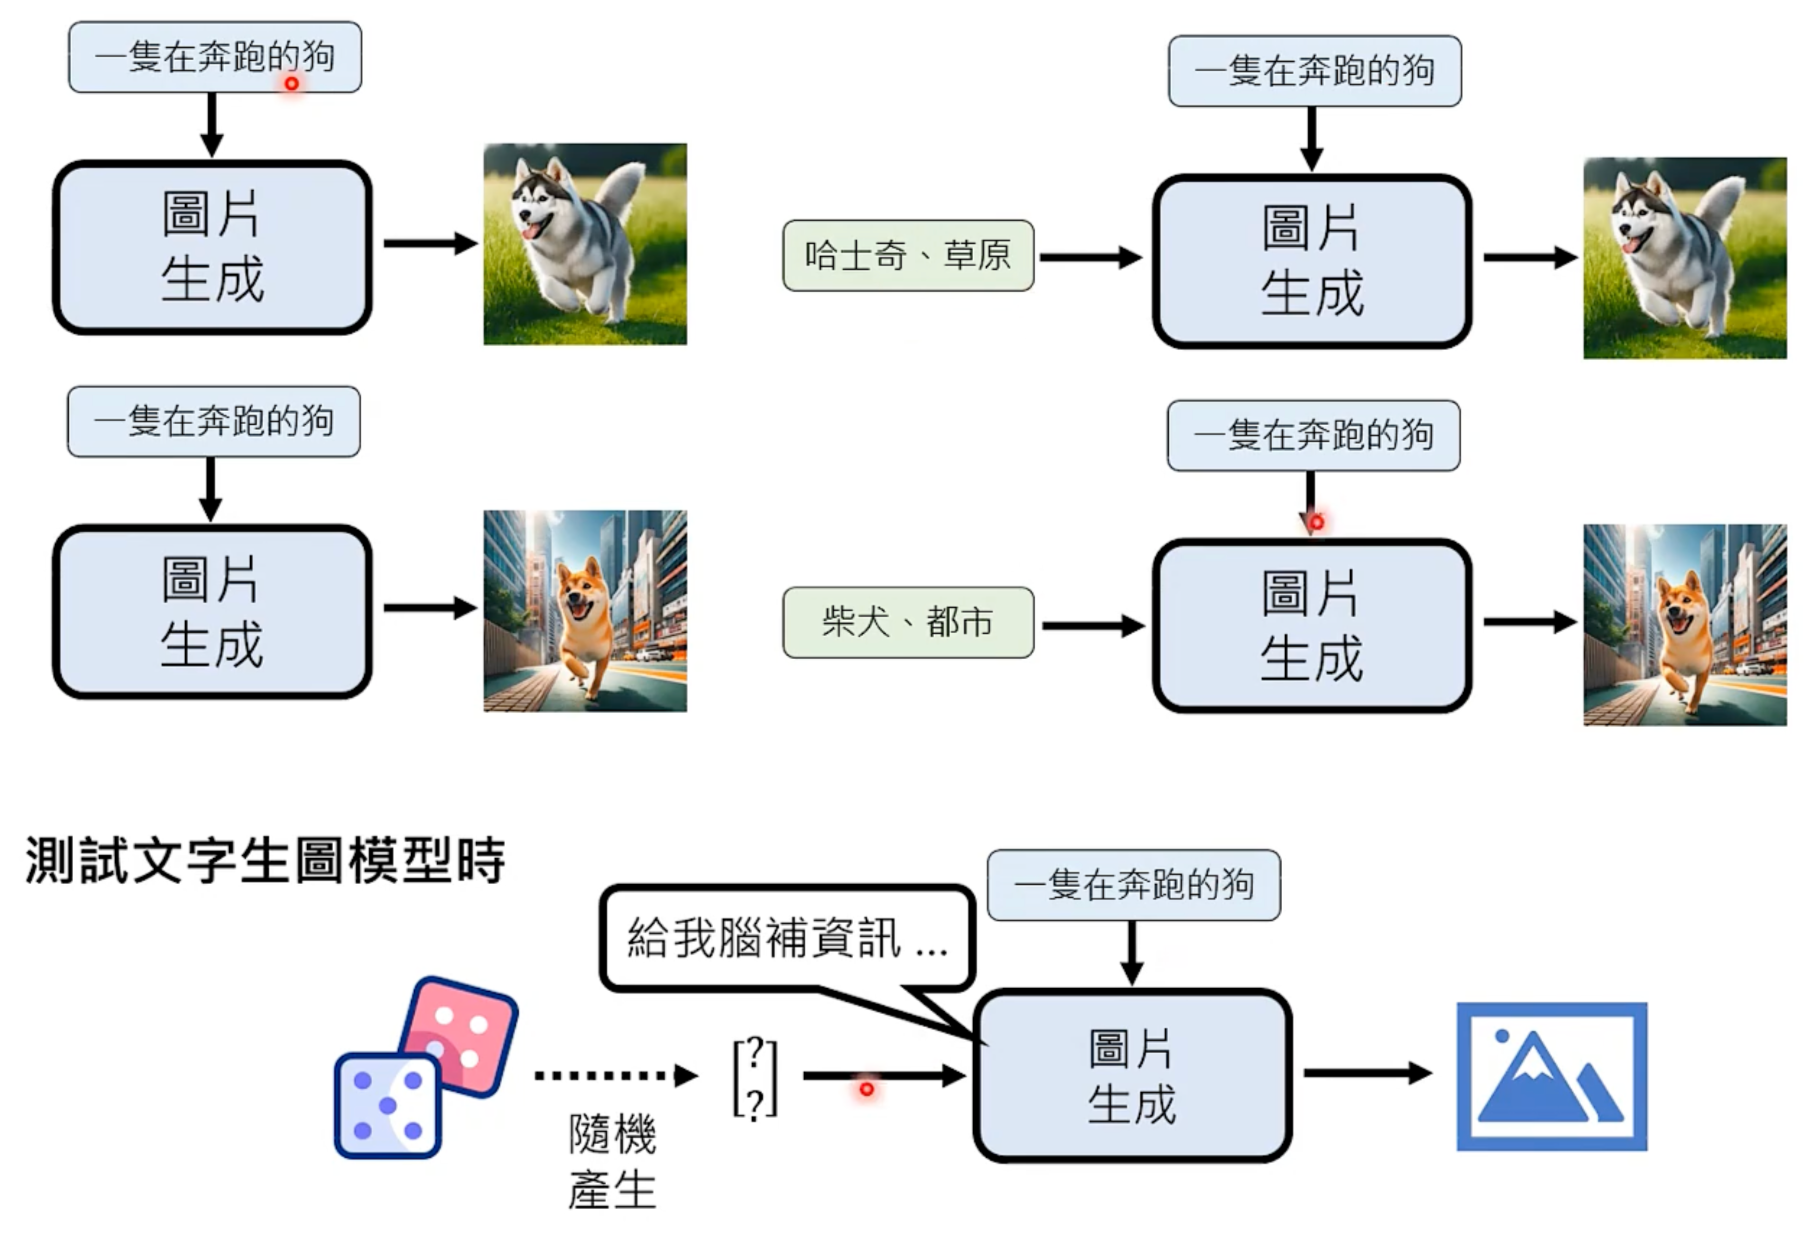
对相同条件下的多种真实图片求期望时,理想最优预测是 Conditional Mean(条件均值):
\[f^*(c)=\mathbb E[X\mid c]\]从预测一个值到学习分布
Generative Models (GMs) aim to learn the stochastic process underlying the very generation of the data collected, 通常通过拟合一个概率分布来近似未知的数据分布,并从中采样产生新的结果。对于条件生成,目标是让模型的 Conditional Distribution(条件分布)$p_\theta(x\mid c)$ 接近数据分布 $p_{\mathrm{data}}(x\mid c)$:给定条件 $c$,哪些结果 $x$ 合理,各有多常见。
LLM 在每一个生成位置输出下一 token 的 Categorical Distribution(类别分布)。由于单个 token 的候选集合是有限词表,这个分布可以用长度为 vocabulary size 的概率向量表示;完整回答的分布则由逐步条件概率共同确定。 \(\text{hidden state }h \xrightarrow{\text{Linear}} \text{logits} \xrightarrow{\text{Softmax}} \text{Token 概率} \xrightarrow{\text{采样}} \text{Token}\)
连续输出:用概率分布描述
机器人的动作通常处于连续、多维空间;如果要学习动作分布,可以用连续概率分布来描述。以一维动作的单高斯策略为例,nn不直接输出“移动 2 厘米”,而是输出一个(单)高斯分布(正态分布)的两个参数:$\mu=2,\qquad \sigma=0.2 $,表示:$a\sim\mathcal N(2,\;0.2^2)$,直觉就是:大多数动作在 2 厘米附近,偏离得越远,出现的可能性越小。
\[\text{hidden state }h \xrightarrow{\text{Output Head}} (\mu,\sigma) \xrightarrow{\text{确定分布}} \mathcal N(\mu,\sigma^2) \xrightarrow{\text{采样}} \text{动作 }a\]从单峰到多峰
单高斯只有一个峰。如果要表达之前的“向左绕、向右绕都合理,中间不合理”,就需要能表达多峰分布的模型,例如 Gaussian mixture。但描述分布不一定要直接输出一组分布参数。另一种方法是学习一个生成过程:从容易采样的 noise 出发,根据当前 observation 将它变换成合理动作。只要不同 noise 经过变换后形成的整体分布接近示范动作分布,我们就能通过运行这个过程生成动作。Diffusion 和 Flow Matching 都可以用于构建这样的生成过程。
这是一种通过生成过程表示分布的思路。把整个过程记作:
\[z\sim p_{\mathrm{noise}}, \qquad x=G_\theta(z,c)\]这里 $z$ 包含生成所需的随机性,$G_\theta$ 可以是一次网络调用,也可以是多步生成过程。大量随机输入经过它变换后,输出形成的分布就是模型的 Induced Distribution(诱导分布)。
因此,“能够采样”与“能够计算样本的概率或密度”是两种不同能力。GAN 是典型的 Implicit Generative Model(隐式生成模型):容易生成样本,但通常不直接提供样本的 likelihood。Diffusion / Flow 也可以通过生成过程理解,但其密度计算能力要看具体模型和方法,不能一概视为不可计算。
“学习分布”,就是让模型学到:左绕、右绕都是合理结果,应该有较高概率;撞上去不合理,应该有较低概率。学到分布之后,机器人最终需要的是一段具体的动作,不能执行“一组可能性”。所以还需要 “从中采样”:按照学到的概率规律,产生一个具体的 Action。这一次可能生成左绕,下一次可能生成右绕。采样带有随机性,但受到当前场景和所学分布的约束。
生成顺序:AR 与 NAR
生成一个复杂对象时,各个部分应该按什么顺序产生,才能既快又协调?
- AR(autoregressive generation):每轮只生成下一个单位。后面生成的内容,能看到前面已经选了什么,每次做新选择时,前面的选择已经确定,可以据此保持一致。代价是串行:第二个输出要等第一个,第三个要等第二个。
- NAR( non-autoregressive generation):不按固定顺序逐个生成输出单位,而是并行预测或更新多个位置。完整结果可以一次产生,也可以经过多轮修订。它需要解决的问题是:各位置怎样作出相互协调的选择?如果只根据文字条件独立采样每个位置,局部合理的选择可能拼成不合理的整体。。
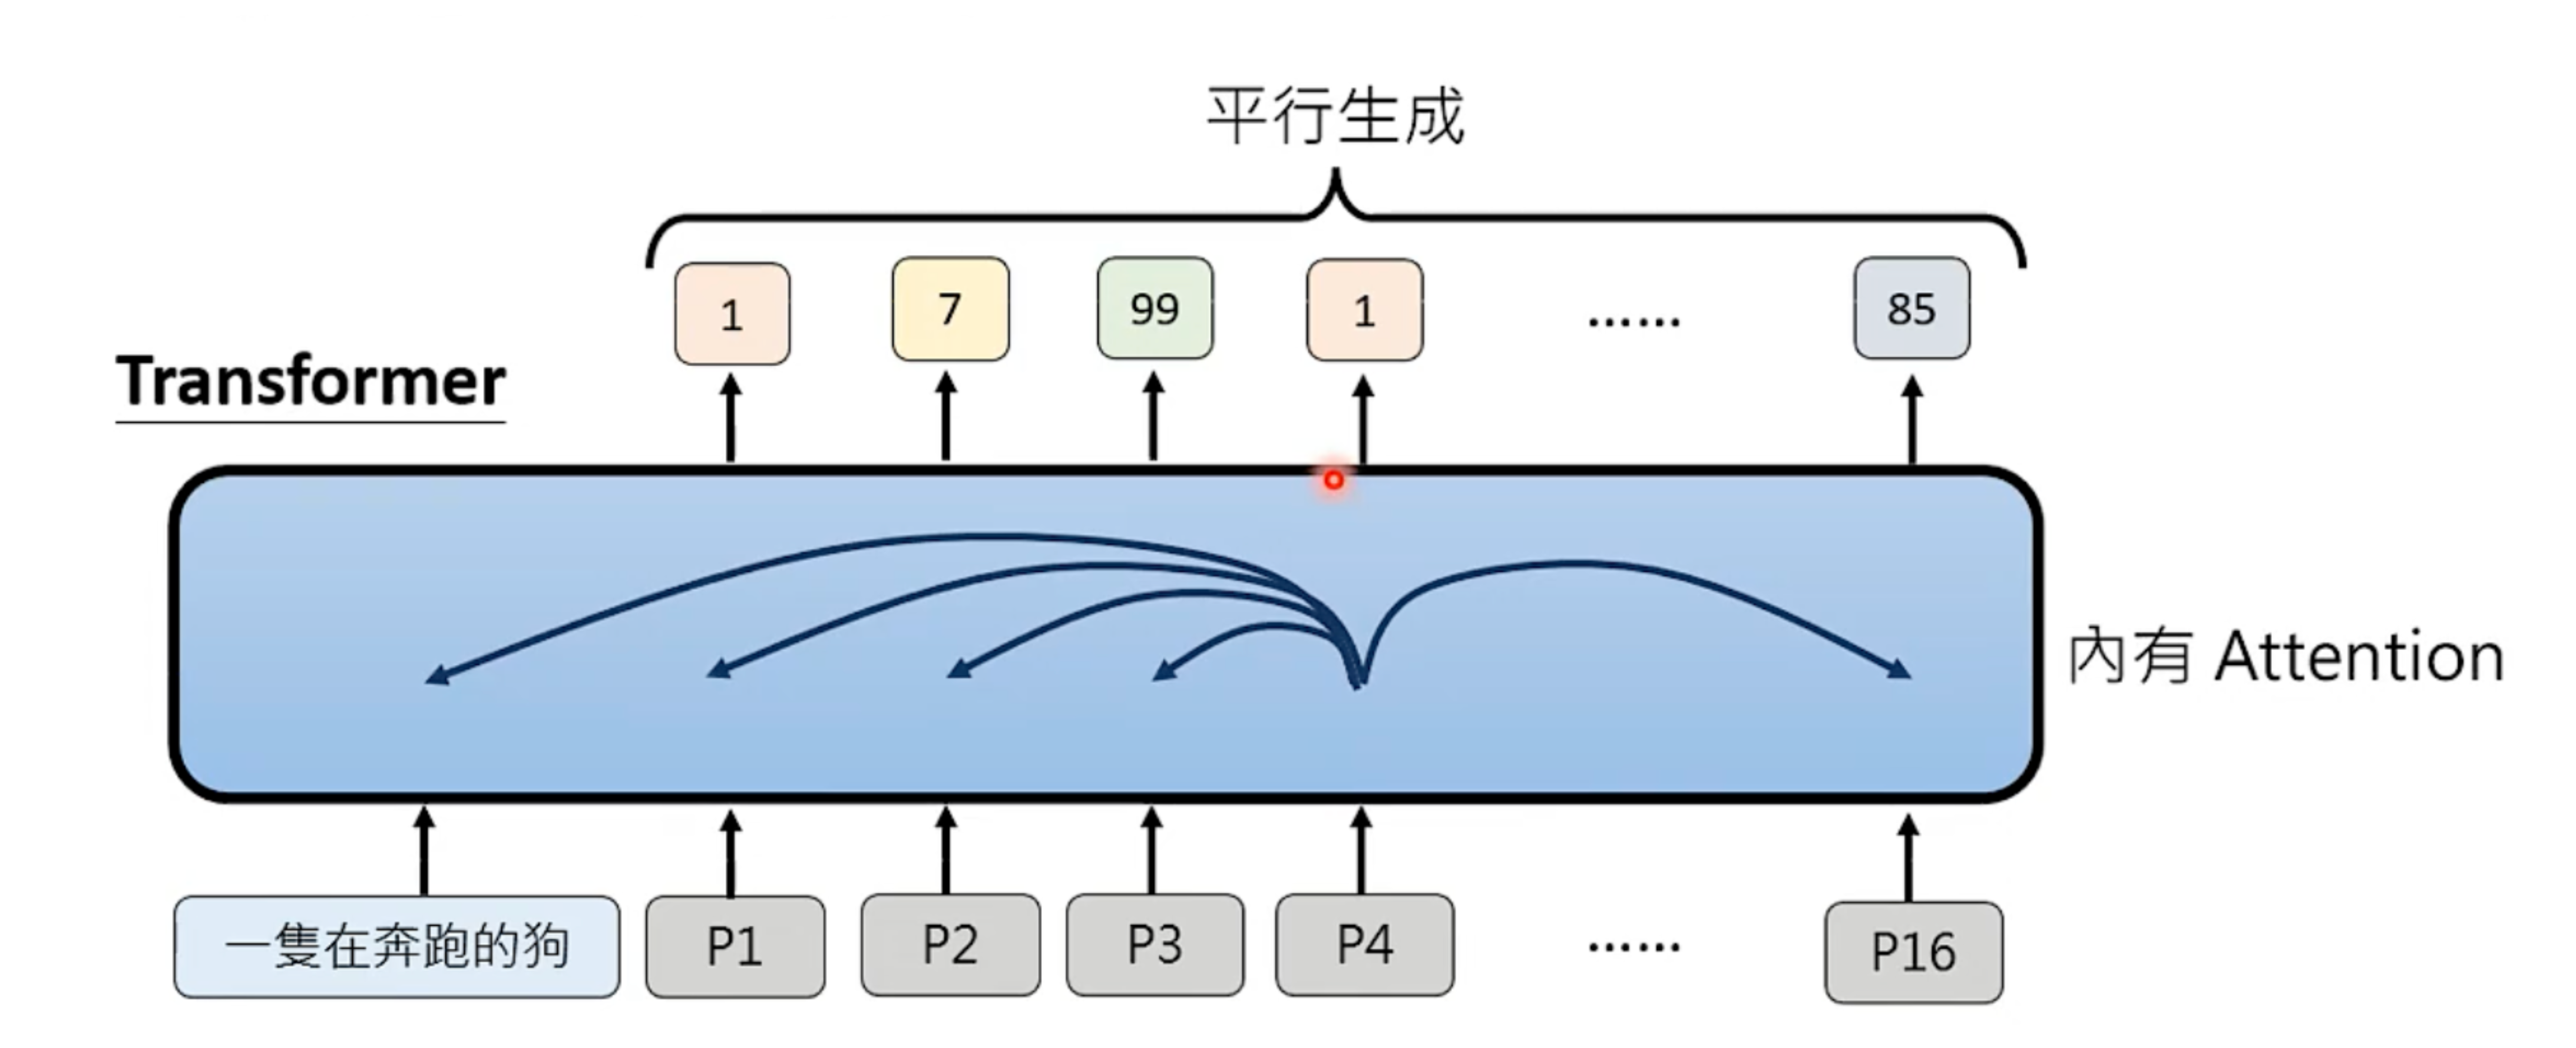
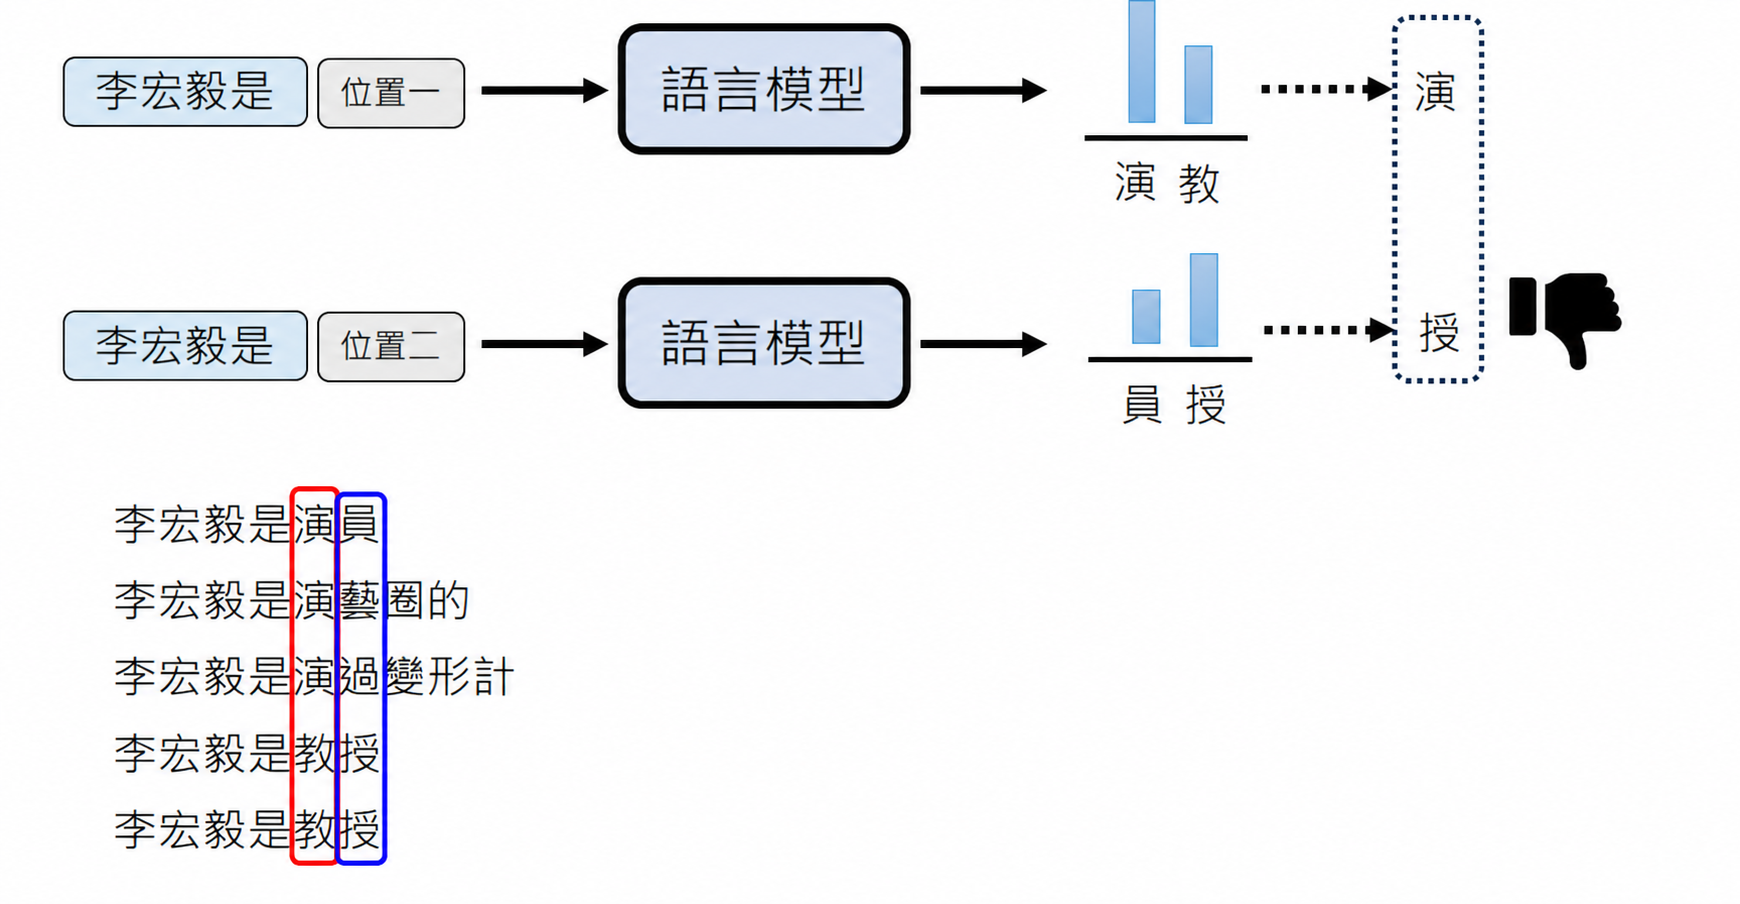
数学上,需要学习的是各位置的 Joint Distribution(联合分布)。AR 通过条件概率链显式表达依赖:
\[p(x_1,\ldots,x_N\mid c) = \prod_{i=1}^{N}p(x_i\mid x_{<i},c)\]如果采用最简单的条件独立假设,则变成:
\[p(x_1,\ldots,x_N\mid c) \approx \prod_{i=1}^{N}p(x_i\mid c)\]后者省略了输出之间的依赖。并行计算本身并不要求这种独立假设;共享潜变量、联合生成网络和多轮修订,都可以帮助建立位置之间的关联。
NAR 优化路线
-
补充共同条件,这样不同位置不是各自决定画什么,而是共同实现同一个方案。
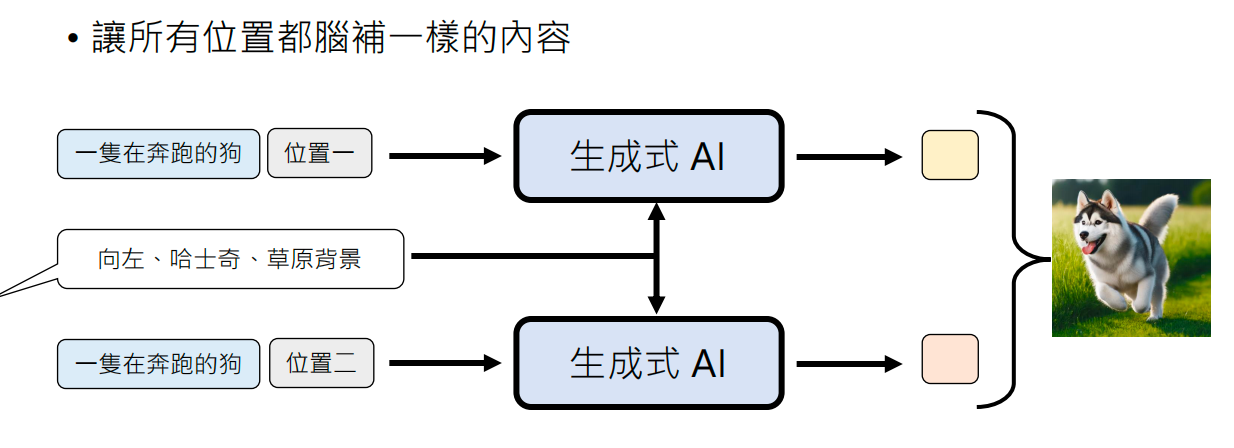
但不能指望用户把图片每个细节都描述出来。因此,模型可以引入一个共享潜变量:z,同一个z影响整个输出,因此各位置可以产生相关、协调的结果。
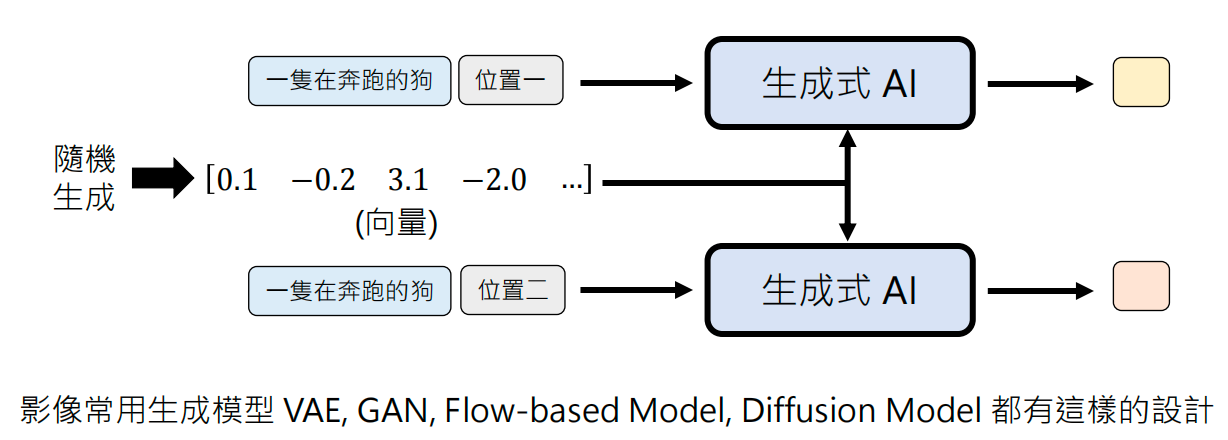
- 先生成精简表示,再(并行)展开细节。精简表示不一定是一张小图片,也不一定是人能读懂的描述。 它可以是学习得到的编码。
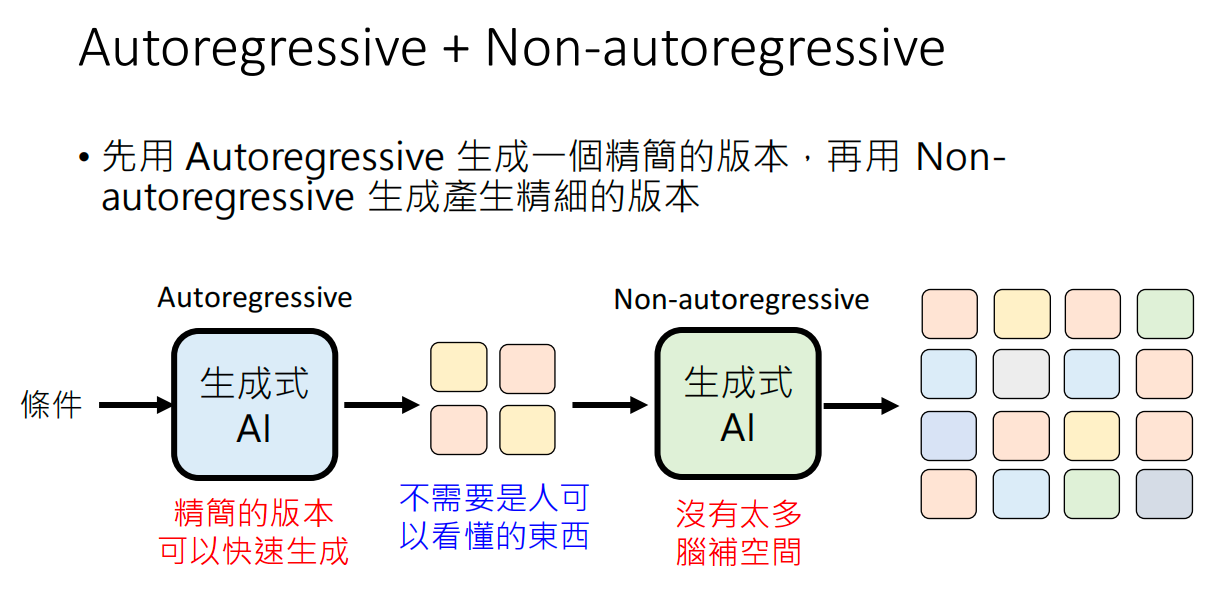
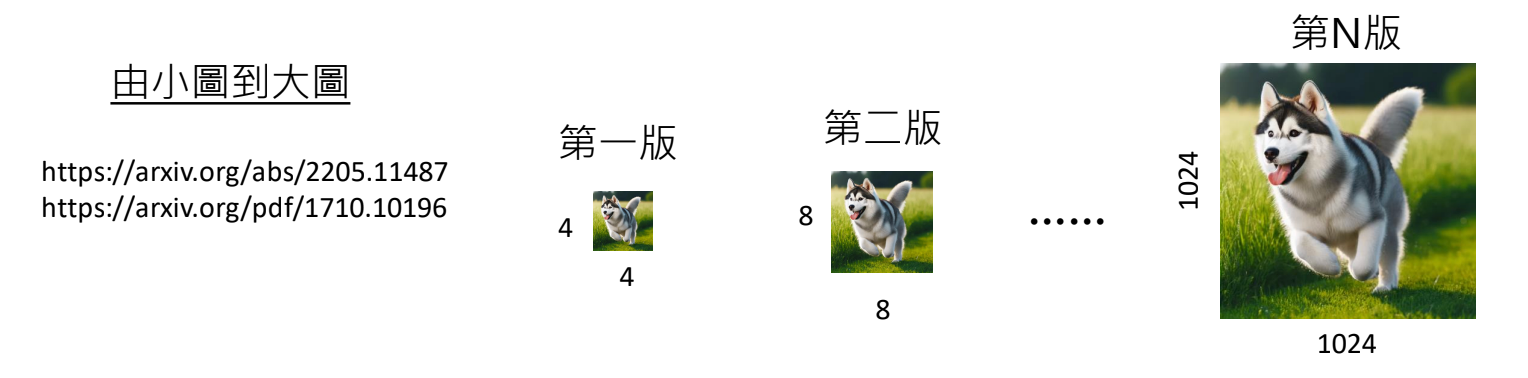
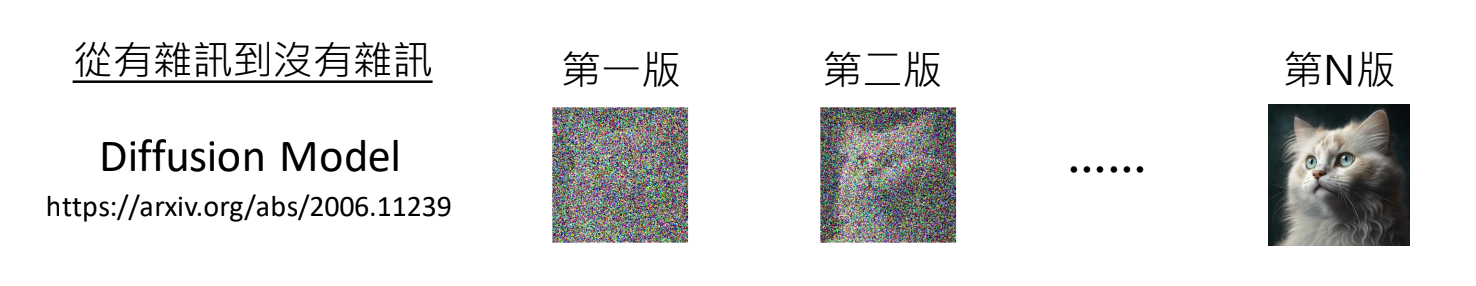
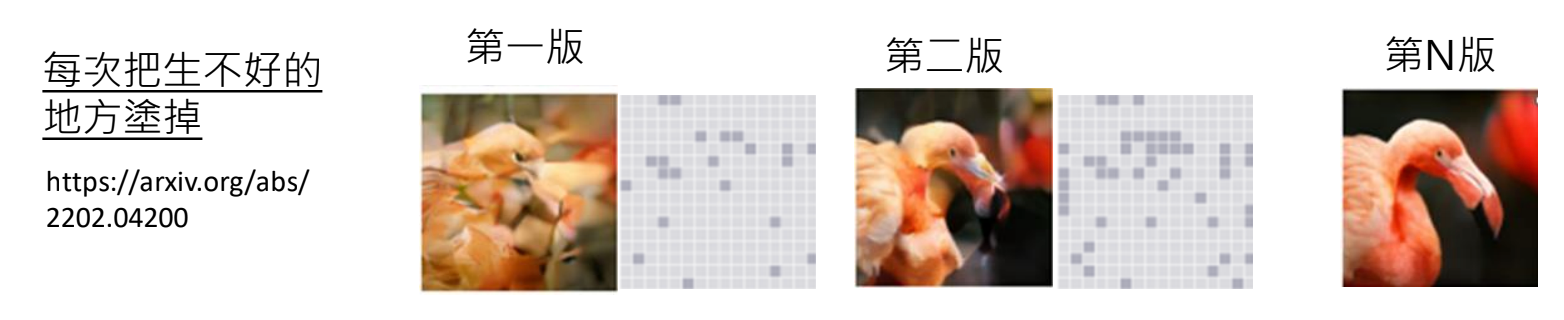
- 不要一次到位,改为多轮并行修订。存在顺序依赖,但不是 LLM 那种“逐 Token 接龙”。
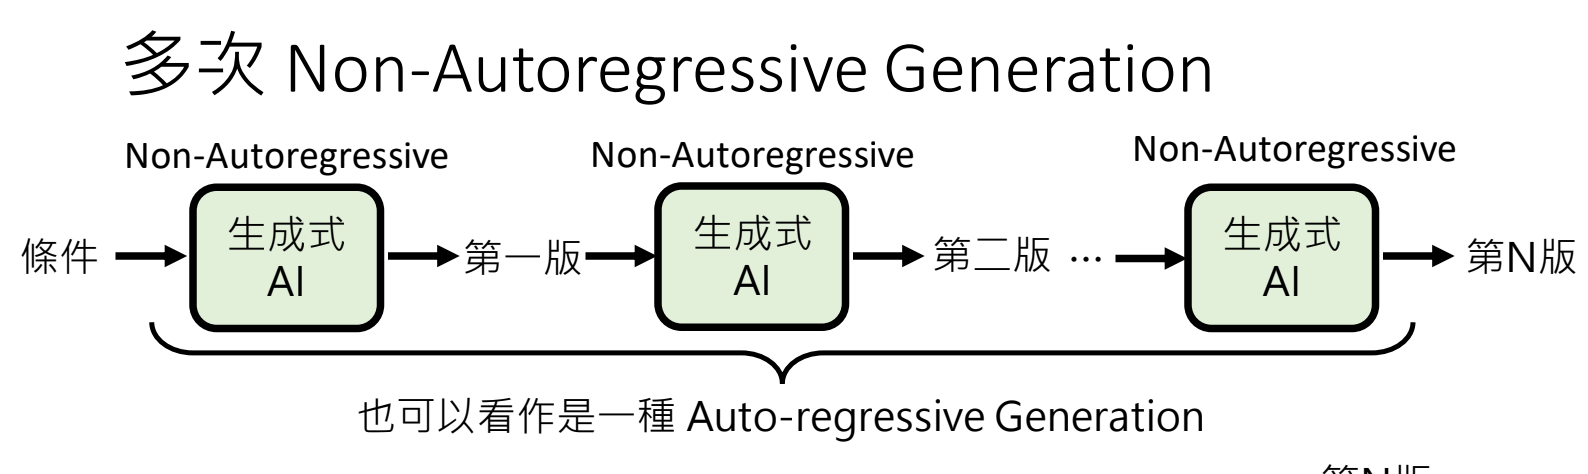
- 由小图到大图,先形成低分辨率结果,再逐步增加细节
- Diffusion,从高噪声状态开始,逐步生成低噪声结果
- Mask-and-refine,遮住生成不好的部分,结合保留内容重新预测
- 由小图到大图,先形成低分辨率结果,再逐步增加细节
VAE:通过潜变量表达多种可能
VAE(Variational Autoencoder)通过潜变量建模数据分布;生成时采样不同的潜变量,再由解码器生成样本,从而表达多种可能的结果。
TODO:补充 VAE 的训练目标,以及潜变量如何表达不同的生成结果。
GAN:通过对抗训练学习生成分布
那就加随机数,让它每次生成不同的猫?可以改成:
\[x=G_\theta(c,z), \qquad z\sim\mathcal N(0,I)\]- $c$:规定“要生成猫”。
- $z$:让每次生成可以不同。noise
- $G_\theta$:一次前向计算生成图片。
条件 GAN 就采用这样的路线。不过,单纯加上随机输入还不够:训练方法必须让网络真正利用它,学会多种合理结果,因此还需要合适的生成式训练目标,例如对抗训练。
Diffusion:通过逐步去噪生成样本
Diffusion 换了一种训练与生成方式,它没有要求网络一次完成: 文字 + 随机数 → 一整张清晰图片。而是让同一个网络反复解决:当前带噪内容 + 文字条件 + 噪声等级 → 这一步的噪声预测。再由采样器逐步更新图片。这带来一个很实用的训练机制:用真实图片加已知噪声,就能自动构造大量训练题,并用噪声预测误差训练。但代价也明确:通常需要多次调用网络,推理比单次生成更费计算。
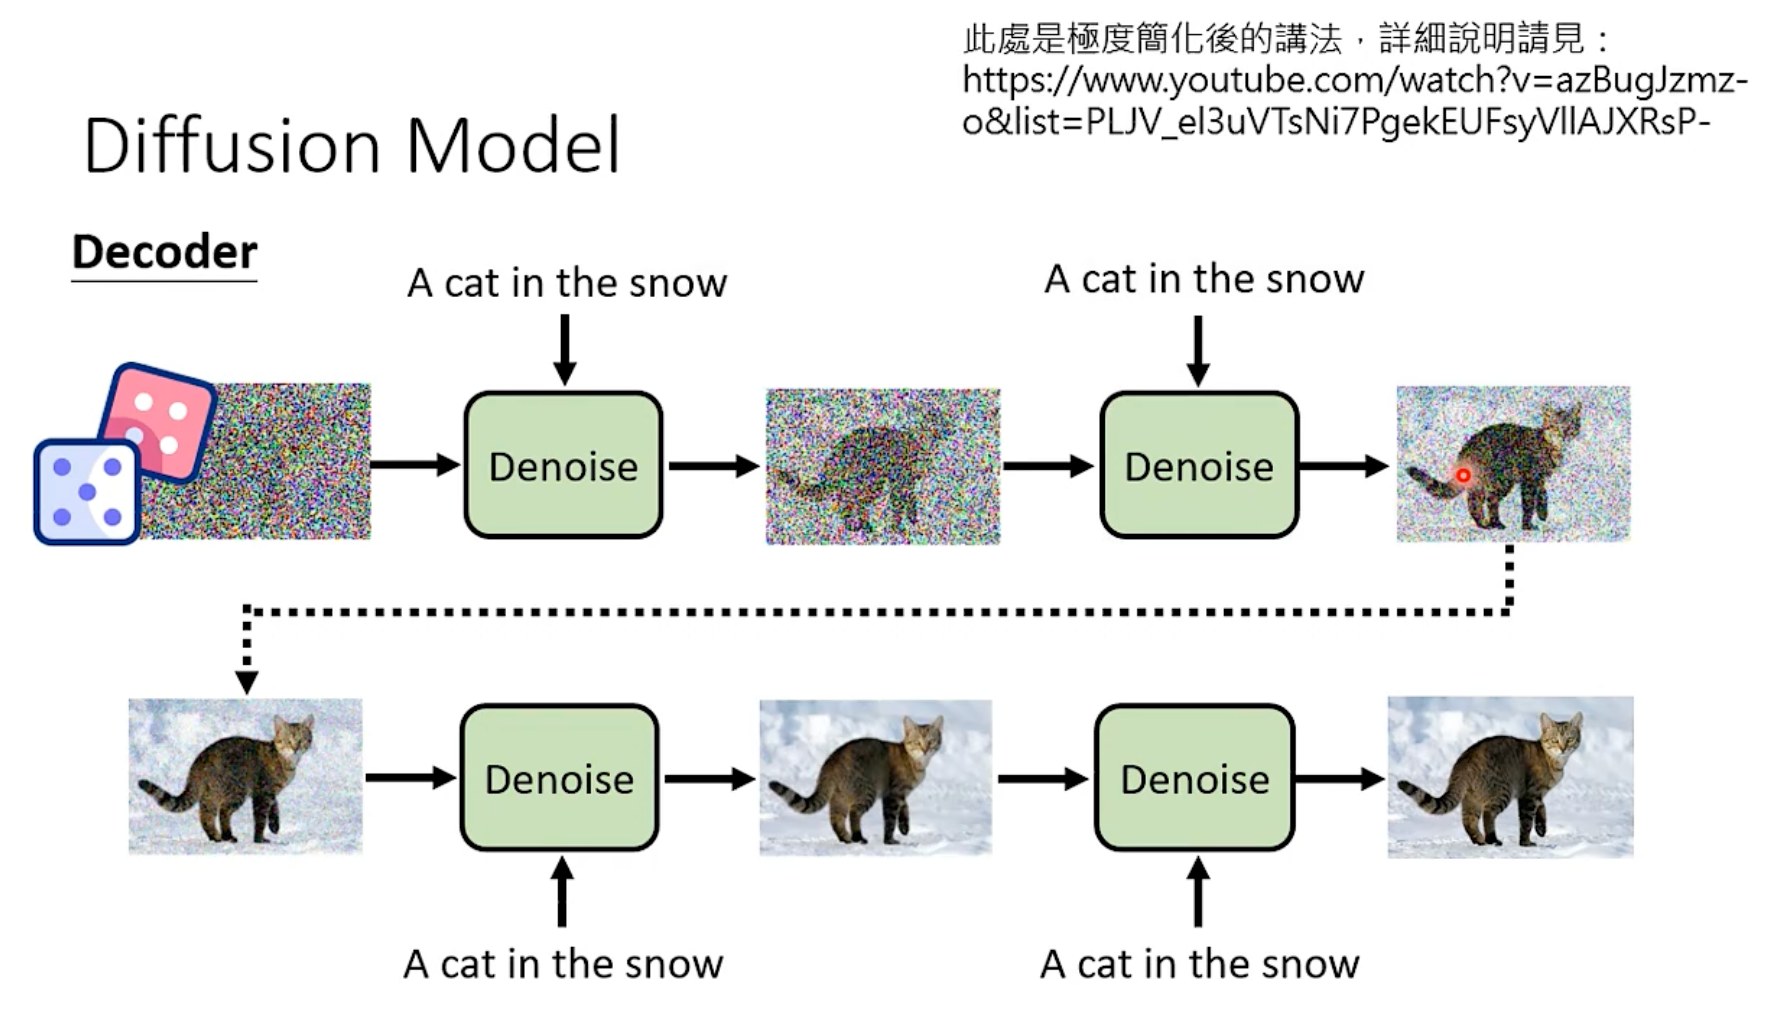
把生成过程从 $\text{文字}\xrightarrow{\text{NN}}\text{猫的图片}$ 拆成很多个更小的步骤: 按照“a cat in the snow”这个要求,眼前这张带噪图片,下一步应该怎样调整?重复这个过程。随机噪声就是生成多样性的一个来源,文字约束“哪些结果符合要求”,同样的文字条件下,从不同噪声出发,通常会生成不同的图片。噪声里并没有预先藏着一只猫,把这些随机起点逐步变成符合文字要求的图片,是模型从训练数据中学到的能力。PS:把文生图 ==> “command + 图”生图。
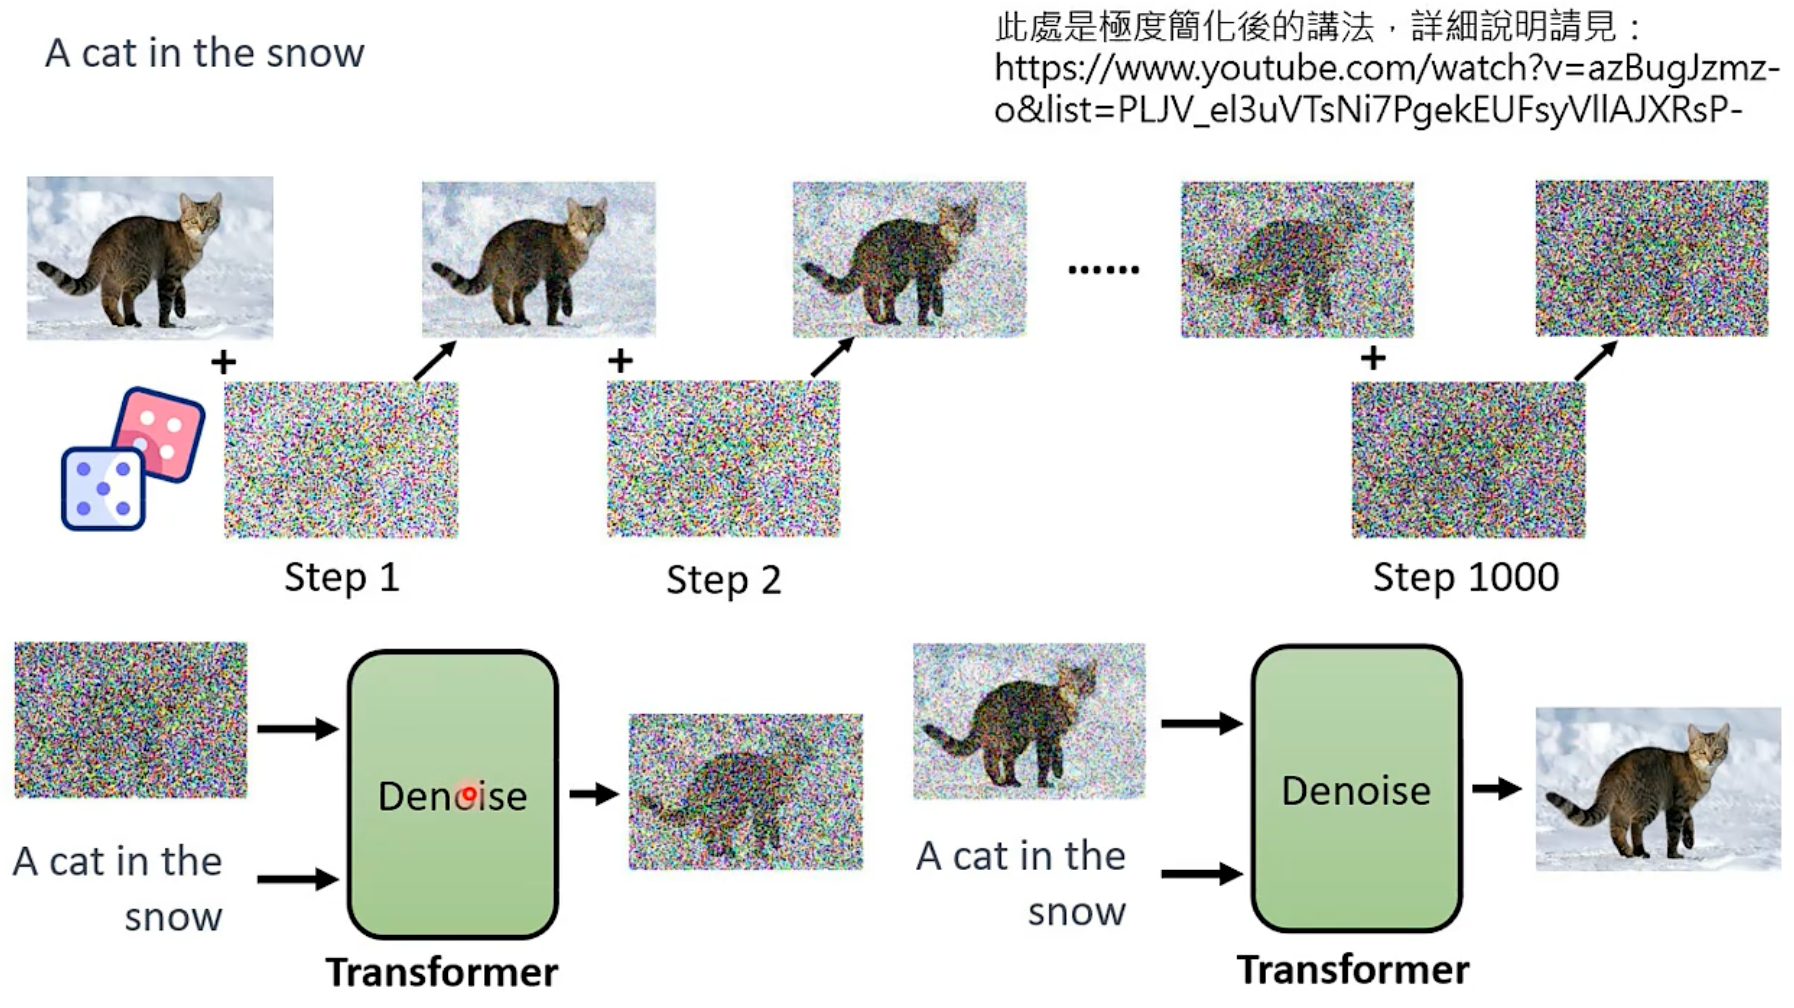
生成过程示例
假设有一万张猫的图片,我们希望模型学到的不是“记住这一万张图片”,而是猫图片的共同规律,使它能生成新的、合理的猫图片。
condition = text_encoder("一只橘猫坐在窗边")
x = random_noise()

for k in reversed(noise_levels):
    predicted_noise = denoiser(x, k, condition)
    x = sampler_step(x, predicted_noise, k)

image = x
这里要区分 Denoiser(去噪网络)和 Sampler(采样器):denoiser 输出当前噪声的预测,sampler_step 根据预测、噪声日程和具体更新公式,计算下一步状态。网络输出的预测并不直接等于下一张图片;网络与采样器共同组成完整生成过程。实际模型也可以预测干净样本或 velocity,噪声预测只是这里采用的一种 Parameterization(参数化方式)。
Flow Matching:通过 velocity regression 学习生成过程
Mapping Gaussian noise to a bimodal distribution. 假设收集了很多数字,大部分聚集在 -2 和 +2 附近,中间比较少,这就是一种“双峰分布”。希望模型学会生成新的数字,而且生成很多次之后,也呈现这种规律。但电脑容易产生的是高斯随机数:很多数集中在 0 附近,离 0 越远越少。于是问题变成:
容易生成的随机数
       ↓ 某种变换
符合训练数据规律的数字
图片、机器人动作也是类似的,只不过一个样本包含很多数字:
- 一个数字:一维。
- 一张图片:很多像素组成的向量。
- 一段机器人动作:多步关节指令组成的向量。 Flow matching is a technique to learn how to transport samples from one distribution to another. For example we could learn how to transport samples from a simple distribution we can easily sample from (e.g. Gaussian noise) to a complex distribution (e.g. images, videos, robot actions, etc.).
模型预测什么:time-dependent vector field
模型学习的是什么?可以把 noise 中的每个样本想象成一个点。我们希望这些点经过移动,最终形成训练数据的分布。模型要学习的是一个 time-dependent vector field:给定一个点当前的位置和生成进度,告诉它应该往哪个方向移动,以及移动多快。用公式表示,模型的输入和输出是:
\[\hat u_t = v_\theta(x_t,t)\]其中,$x_t$ 是当前样本,$t$ 是生成进度(The step $t$ is a value between 0 and 1 that describes the progress of the sample $x_t$ along the flow path from the noise distribution to the target distribution. ),$\theta$ 是模型参数。输出与样本维度相同,表示样本每个分量的变化方向与速度。Flow 描述样本随着时间连续移动形成的变换;Matching 则对应训练时让模型预测的 vector field 匹配目标 vector field。
生成时,从随机噪声 $x(0)$ 出发,求解由速度场定义的 Ordinary Differential Equation(ODE,常微分方程):
\[\frac{dx(t)}{dt}=v_\theta(x(t),t), \qquad x(0)\sim\mathcal N(0,I)\]Numerical Solver(数值求解器)把连续运动近似成有限次更新。例如最简单的 Euler Method(欧拉法):
\[x(t+\Delta t) \approx x(t)+\Delta t\,v_\theta(x(t),t)\]网络负责预测速度,求解器负责推进状态。给定初始噪声和求解设置,这条生成路径可以是确定的;不同初始噪声仍然能够产生不同结果。本文统一采用 $t=0$ 为噪声端、$t=1$ 为数据端。
构造路径与目标速度
模型要预测什么,训练时就需要提供相应的目标值。我们需要将这些样本转化为与模型预测目标相对应的监督信号:构造从 noise 到真实样本的路径,并计算沿途的目标速度。一种简单做法是:随机抽取一个 noise 样本 $x_0$ 和一个真实数据样本 $x_1$,在两者之间构造一条直线路径:
\[x_t=(1-t)x_0+t x_1,\qquad t\in[0,1]\]沿着这条路径匀速移动,所需的目标速度就是:
\[u=x_1-x_0\]例如,抽到的 noise 是 0.3,真实数据是 2.1,那么在 $t=0.5$ 时,中间位置是 1.2,目标速度是 1.8。
训练步骤与损失函数
一次训练可以概括为:
- 从数据集中抽取真实样本 $x_1$。
- 从预先选定的分布中抽取 noise $x_0$,例如标准 Gaussian distribution。
- 在 0 到 1 之间随机抽取一个 $t$,直接算出 $x_t$。
- 让模型根据 $x_t$ 和 $t$ 预测速度。
- 用预测速度与 $x_1-x_0$ 的误差更新模型。
对应的训练目标是:
\[\mathcal L(\theta) = \mathbb E_{x_0,x_1,t} \left[ \left\|v_\theta(x_t,t)-(x_1-x_0)\right\|^2 \right]\]真实样本 $x_1$ 用来构造训练输入和监督目标,不会作为答案直接提供给模型。 模型通过大量样本,学习在不同位置、不同生成进度下应该如何移动。这是 Conditional Flow Matching 的一种简化形式。训练时可以直接计算随机时刻的中间样本,不需要先完整模拟从 noise 到 data 的整个过程,因此论文 §3–4称这种训练方式为 simulation-free。
生成领域的强化学习
知道一个生成结果好不好,还不等于知道模型参数应该怎样修改。Reward 到 gradient 之间,需要一套具体机制。
| 样本 | 生成内容 | 奖励 |
|---|---|---|
| A | 三个红色杯子,画面清晰 | 9 |
| B | 三个红色杯子,画面略差 | 7 |
| C | 两个红色杯子 | 3 |
| D | 三个蓝色杯子 | 1 |
“图 A 得 9 分”只告诉我们结果好,没有告诉我们 DiT 中哪个参数应该增加、哪个参数应该减小。至少存在几种不同选择:
结果好
 ├─ 把它当作训练数据,多学几遍
 ├─ 对奖励求导,沿生成过程直接反传
 ├─ 计算生成概率,增加这类结果出现的机会
 └─ 修改去噪方向,使生成更接近偏好分布
这些选择最终都可能让奖励提高,但它们需要保存的数据、梯度经过的路径、能否使用黑盒奖励,很不一样。后面比较方法时,始终追踪三件事:奖励怎样进入 loss,梯度推动哪个输出,更新后生成分布为什么会改变。
| 路线 | 怎样把评价变成更新 |
|---|---|
| RWR / RFT | 高分图多学,低分图少学或过滤掉;继续做普通去噪训练 |
| Reward Backpropagation | 如果奖励和生成过程可微,直接沿“图像 → 奖励”的导数反传 |
| PPO / DDPO / GRPO | 用 Advantage 加权已采动作的 log-prob 梯度,调整这些动作的概率 |
| Diffusion-DPO | 用偏好对,让模型相对参考模型更偏向赢家 |
| DiffusionNFT | 把奖励转成正负反馈,围绕旧模型预测构造新的回归目标 |
小结
多步生成提供了一种实用的学习方式:通过可构造的局部监督信号,学会一个复杂的生成过程。 例如 Flow Matching 用路径上的目标速度监督模型,生成时再积分得到样本。这是训练与采样方式的选择,并不是多峰分布的数学要求。 | | 训练时让模型学什么 | 生成时怎么做 | |—|—|—| | Diffusion | 给真实图片加噪,学习如何去噪 | 从 noise 开始,反复用学到的去噪规则更新样本 | | Flow Matching | 构造 noise 到数据的路径,学习沿途的速度 | 从 noise 开始,沿预测的速度场更新样本 | Diffusion 通过学习去噪来获得生成能力;Flow Matching 通过学习样本如何移动来获得生成能力。
留下评论