- 简介
- lerobot
- LeRobotDataset
- Learning-based approaches
- Robot (Imitation) Learning 示范给机器人看,让它学会一个任务。
- Generalist Robot Policies
简介
本文来自 https://github.com/fracapuano/robot-learning-tutorial 学习笔记。
自 20 世纪 50 年代机器人学诞生以来,该领域一直受到广泛研究。近年来,机器学习(ML)的进步推动了一类相对较新的方法的发展,这些方法利用大量数据和计算资源来解决机器人学问题,而非依赖人类的专业知识和建模技能来开发自主系统。机器人学研究的前沿确实正日益脱离传统的基于模型的控制范式,转而拥抱机器学习的进步,旨在实现
- 从感知到动作的一体化控制流程;
- 多模态的数据驱动特征提取策略
- 减少对精确世界模型的依赖;
- 更好地把握利用日益丰富的开放机器人数据的机会。
作为一个仍处于相对初期阶段的领域,目前没有任何主流技术被证明在domain of robot learning明显优于其他技术。尽管如此,两大类方法已崭露头角:强化学习(RL)和Behavioral Cloning(BC)
lerobot
lerobot是 Hugging Face 开发的端到端机器人技术开源库。该库纵向集成了整个机器人技术栈,既支持对真实机器人设备进行底层控制,也提供先进的数据与推理优化,以及采用纯 PyTorch 简洁实现的最先进机器人学习方法。
LeRobotDataset
lerobot定义了一种标准化数据集格式,旨在满足机器人学习研究的特定需求,为跨模态机器人数据提供统一、便捷的访问方式,其中包括传感器运动读数、多路摄像头画面和遥操作状态。可由用户轻松扩展且高度可定制。
将底层数据存储与面向用户的 API 分离。由三个主要部分组成:
- Tabular Data:关节状态和动作等低维、高频数据存储在高效的内存映射文件中,通常会转交给 Hugging Face 更成熟的 datasets 库处理,从而实现快速访问并减少内存占用。
- Visual Data: 为处理大量摄像头数据,帧会被拼接并编码为 MP4 文件。同一回合的帧始终归入同一个视频,多个视频则按摄像头归组。为减轻文件系统负担,同一摄像头视角的视频组在达到给定阈值数量后,也会拆分到多个子目录中。
- Metadata。由一组 JSON 文件构成,用于描述数据集的元数据结构,并作为表格型和视觉数据维度的关系型对应部分。元数据包括不同的特征模式、帧率、归一化统计信息和回合边界。
Learning-based approaches
Learning-based approaches to robotics are motivated by the need to
- 在不同任务和具身形态之间实现泛化
- 减少对人类专业知识的依赖
- leverage historical trends on the production of data
Robotics is concerned with producing artificial motion in the physical world in useful, reliable and safe fashion. Thus, robotics is an inherently multi-disciplinar domain: producing autonomous motion in the physical world requires, to the very least, interfacing different software (motion planners) and hardware (motion executioners) components. Methods to produce robotics motion
- Explicit models vs dynamics-based,基于动力学的方法,利用对机器人刚体力学及其与环境中潜在障碍物相互作用的精确描述
- implicit models vs learning-based methods. treating artificial motion as a statistical pattern to learn
绝大多数情况下,Robotics致力于通过驱动连接近乎完全刚性的链接的关节来产生运动。传统方法怎样让机器人动起来,会遇到什么困难?以 SO-100 固定几个关节,只留下肩部、肘部的运动(简化成平面里的“两根杆、两个转轴”)为例
- 程序控制的是两个关节角度:$q=[\theta_1,\theta_2]$,而任务关心的是夹爪的位置:$p=[x,y]$,首先要解决这两种表达之间的转换:知道关节角度,能算位置(正运动学/Forward Kinematics);知道目标位置,要反过来求角度(逆运动学/Inverse Kinematics)。
- 算出终点姿势,“怎么走过去”。实际执行时,问题一层层增加:
- 给求解加入约束。桌面和障碍物限制了哪些姿势可行。
- 轨迹规划。终点姿势可行,不代表走过去的路径不会碰撞。
- 要沿路径平滑运动,还要计算关节速度,由此引入 Jacobian 和 微分逆运动学/Differential IK。其中,微分逆运动学的核心关系是:$\dot p=J(q)\dot q$,当前姿势下,各关节的转速$\dot q$(单位是 rad/s)怎样共同决定夹爪的移动速度$\dot p$(单位是 m/s)。Jacobian $J(q)$ 就是这两种速度表达之间的局部转换关系。
- 实际位置与预计位置有偏差,或者障碍物移动了,还要根据观测不断纠正,引入反馈控制。 所以,“把夹爪移过去”背后,其实是一整套建模、求解、规划、反馈纠偏的程序。
“把夹爪移动过去”是一套持续规划、执行、观测和纠偏的过程。
- 哪些东西能从数据中学?即使只有两个活动关节,加入现实约束后,也已经需要不少人工建模和工程设计。换机器人、换任务、增加复杂接触,还会带来新的适配工作。能否让机器从示范或试错中学会一部分感知到动作的映射,减少逐项设计这些规则和模型的负担?
- 真实物理过程很难建模准确。两根刚性杆的几何关系比较好写;抓东西时的摩擦、接触,以及布料等柔性物体的变化,就难以用简单模型准确描述。
- 更多数据不会自动让系统变强。收集了一万条成功操作记录,手工设计的规划器和控制器不会仅仅因为这些数据存在,就自动掌握更多技能;需要引入利用数据学习的机制。
Learning-based technique通常依赖单体式的预测到动作流水线(视觉运动策略),可直接将感觉运动输入映射为预测动作,通过消除与多个组件对接的需求来简化控制策略。将感觉输入映射为动作,也使得纳入多种输入模态成为可能,并能利用现代学习系统的自动特征提取能力。此外,基于学习的方法原则上可以完全绕过显式建模,转而仅依赖交互数据——当动力学难以建模或完全未知时,这一优势将带来变革性影响。最后,learning for robotics (robot learning) 天然适合利用日益增多且可公开获取的robotics data,正如计算机视觉和自然语言处理在历史上受益于大规模数据语料库一样。
由于机器人控制问题本质上具有交互性和序列性, robotics control problems can be directly cast as RL problems. 强化学习是机器学习的一个子领域,主要关注自主系统(agents)的开发,使其能够在不断变化的环境中持续行动,并制定(理想情况下表现良好的)控制策略(policies)。对机器人学而言,至关重要的是,强化学习智能体通过试错不断改进,绕过问题环境动力学的显式模型,转而利用交互数据。In RL, this feedback loop between actions and outcomes is established through the agent sensing a scalar quantity (reward) measuring how desirable a given transition is for the accomplishment of its goal.
Streamlined end-to-end control pipelines, data-driven feature extraction and a disregard for explicit modeling in favor of interaction data are all features of RL for robotics. However, RL still suffers from limitations concerning safety and learning efficiency, particularly pressing for real-world robotics applications.首先,尤其是在训练早期,动作通常具有探索性,因此可能难以预测。在物理系统上,未经训练的策略可能会发出高速度指令、导致自碰撞的配置,或超过关节限制的扭矩,从而造成磨损并可能损坏硬件。缓解这些风险需要外部保护措施(例如看门狗、安全监控器、急停装置),而这往往需要大量人工监督。其次,在强化学习中,高效学习仍然是一个难题,因此训练所需的时间尺度往往高得令人望而却步,限制了强化学习在现实世界机器人学中的适用性。强化学习用于robotics时,一个或许更根本的局限是,通常无法获得复杂任务的稠密回报函数;这类函数的设计本质上依赖于人类的专业知识、创造力和反复试错。在实践中,稀疏回报函数可用于判断某个特定目标是否已经达成——这件T恤是否已经正确折叠,尽管已取得显著成功,但由于监督减少,通常会导致学习速度慢得多,即使是成功检测本身,往往也需要定制仪器。sample-efficient learning也至关重要,因为在真实世界中训练本质上受时间瓶颈限制。
Robot (Imitation) Learning 示范给机器人看,让它学会一个任务。
Behavioral Cloning (BC)sidesteps these constraints by casting control an imitation learning problem,绕开了这些限制,并利用先前收集的专家示范来锚定所学习到的自主行为。最值得注意的是,通过模仿学习,自主系统能够自然地遵循数据中隐含编码的目标、偏好和成功标准,从而减少早期探索失败,并完全免去人工设计reward shaping。
机器人控制,也可以是监督学习
既然人能够示范“看到这个场景时应该怎么操作”,能不能把这些操作当成 Label,用监督学习训练一个机器人控制程序?这是BC的出发点,BC 是设法把机器人控制变成一个SL问题(给输入,也给期望输出)。比如你通过遥操作控制机械臂,成功完成几十次搬积木。系统同步记录:
- 输入 Observation,摄像头画面、当前关节位置等。
- 示范动作 Action,人在这一刻发出的控制指令:例如各关节的目标位置,以及夹爪开合指令。
于是我们得到了 $\mathcal D={(o_t,a_t^{\text{expert}})} $ ,训练一个网络:$\hat a_t=f_\theta(o_t) $
用熟悉的回归损失:
\[L(\theta) = \mathbb E_{(o,a^{\text{expert}})\sim\mathcal D} \left[ \|f_\theta(o)-a^{\text{expert}}\|^2 \right]\]人类示范的动作,就是这里的 Label。没有 Reward,也不需要 Policy Gradient。部署时则循环执行:
while running:
    observation = read_cameras_and_joints()
    action = policy(observation)
    robot.execute(action)
为什么“普通监督学习”还不够?
- 预测结果会改变下一次输入。动作预测偏了一点 → 机械臂走偏了一点 → 下一帧画面变了 → 模型面对一个示范数据里没见过的场景 → 继续预测错误。 它学会了顺利时怎么做,却未必学会偏离之后怎么补救。这叫 Distribution Shift / Covariate Shift,连续执行时会产生 Compounding Errors,误差累积。所以:单步动作预测误差很小,不等于整段任务成功率很高。
- 同一场景可能有多个正确答案。假设积木前面有一个障碍物:有些示范从左边绕,有些示范从右边绕。两种都正确,如果用平方误差训练一个只能输出单个动作的回归器,它倾向于预测条件平均值,但“左绕”和“右绕”的平均,可能恰好是“直直撞上去”。
这时,我们需要从:“给定场景,预测一个动作数值”(Regression-based BC),转向:“给定场景,学习哪些动作可能是合理的,以及它们各自的分布”(Generative BC),即:$a\sim\pi_\theta(a\mid o)$,理想情况下,这个分布在“向左绕”和“向右绕”附近都有较高概率,在“撞向障碍物”附近概率很低,生成时选择其中一种合理方案,而不是强行输出两者的平均。
向左绕:49%
向右绕:49%
往前撞: 2%
Generative Models (GMs) aim to learn the stochastic process underlying the very generation of the data collected, 通常通过拟合一个概率分布来近似未知的数据分 布。 LLM 的输出空间是有限的离散词表,可以用长度为 vocabulary size 的概率向量表示。 \(\text{hidden state }h \xrightarrow{\text{Linear}} \text{logits} \xrightarrow{\text{Softmax}} \text{Token 概率} \xrightarrow{\text{采样}} \text{Token}\)
机器人的动作通常处于连续、多维空间;如果要学习动作分布,可以用连续概率分布来描述。以一维动作的单高斯策略为例,nn不直接输出“移动 2 厘米”,而是输出一个(单)高斯分布(正态分布)的两个参数:$\mu=2,\qquad \sigma=0.2 $,表示:$a\sim\mathcal N(2,\;0.2^2)$,直觉就是:大多数动作在 2 厘米附近,偏离得越远,出现的可能性越小。
\[\text{hidden state }h \xrightarrow{\text{Output Head}} (\mu,\sigma) \xrightarrow{\text{确定分布}} \mathcal N(\mu,\sigma^2) \xrightarrow{\text{采样}} \text{动作 }a\]单高斯只有一个峰。如果要表达之前的“向左绕、向右绕都合理,中间不合理”,就需要两个高斯的混合分布,而不是一个高斯。
Action Chunking:生成什么/不要每次只预测一个动作
最初的模型是:$o_t\longrightarrow a_t$,Action Chunking 改成:
\[o_t\longrightarrow A_t=(a_t,a_{t+1},\ldots,a_{t+H-1})\]也就是根据当前观测,一次预测接下来 (H) 步的动作序列。这样更容易一起表达“持续向左绕过去”这样的连贯行为,而不是每一步都重新猜一次。
如何学习/预测动作块?ACT 全称 Action Chunking with Transformers。可以先把它理解成三个部件:
- Action Chunking:输出一段动作。
- Transformer:组织图像、关节信息,预测动作序列。
- Conditional VAE:帮助模型表示示范中不同的动作风格或变化。
Diffusion Policy
扩散模型已被证明在逼近复杂的高维分布方面非常有效,例如图像或视频上的分布,也可以用于robot learning, leveraging diffusion to model expert demonstrations in a variety of simulated and real-world tasks.
假设有一万张猫的图片,我们希望模型学到的不是“记住这一万张图片”,而是猫图片的共同规律,使它能生成新的、合理的猫图片。
condition = text_encoder("一只橘猫坐在窗边")
x = random_noise()

for k in reversed(noise_levels):
    predicted_noise = denoiser(x, k, condition)
    x = sampler_step(x, predicted_noise, k)

image = x
异步推理
机器人执行动作需要连续,而模型生成动作块需要时间。如果每次都是:动作执行完 → 停下来等模型 → 再执行。机械臂可能一顿一顿。
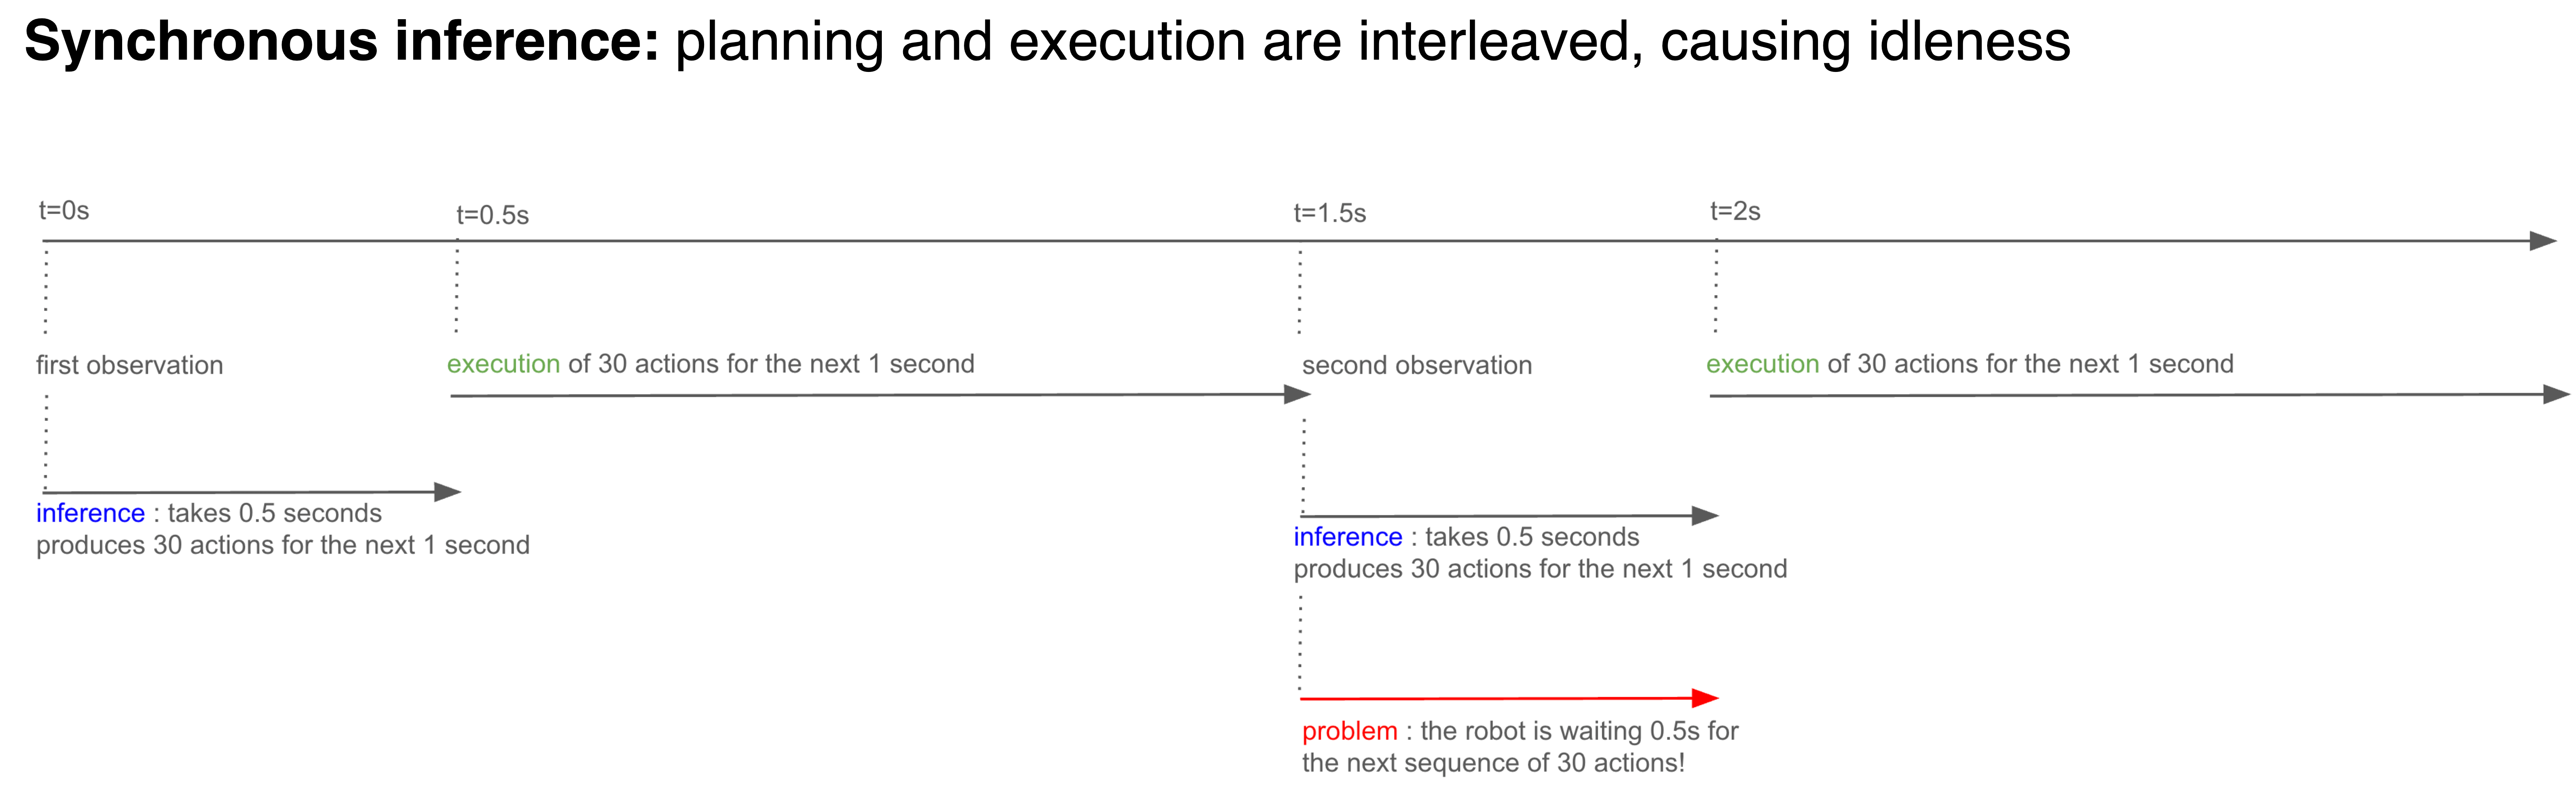 控制端Robot Client持续消费已有的动作队列。推理端Policy Server提前根据新观测生成下一块动作。新结果回来后,按执行时间对齐、更新队列。异步不是让模型算得更快,而是让计算时间与执行时间重叠。
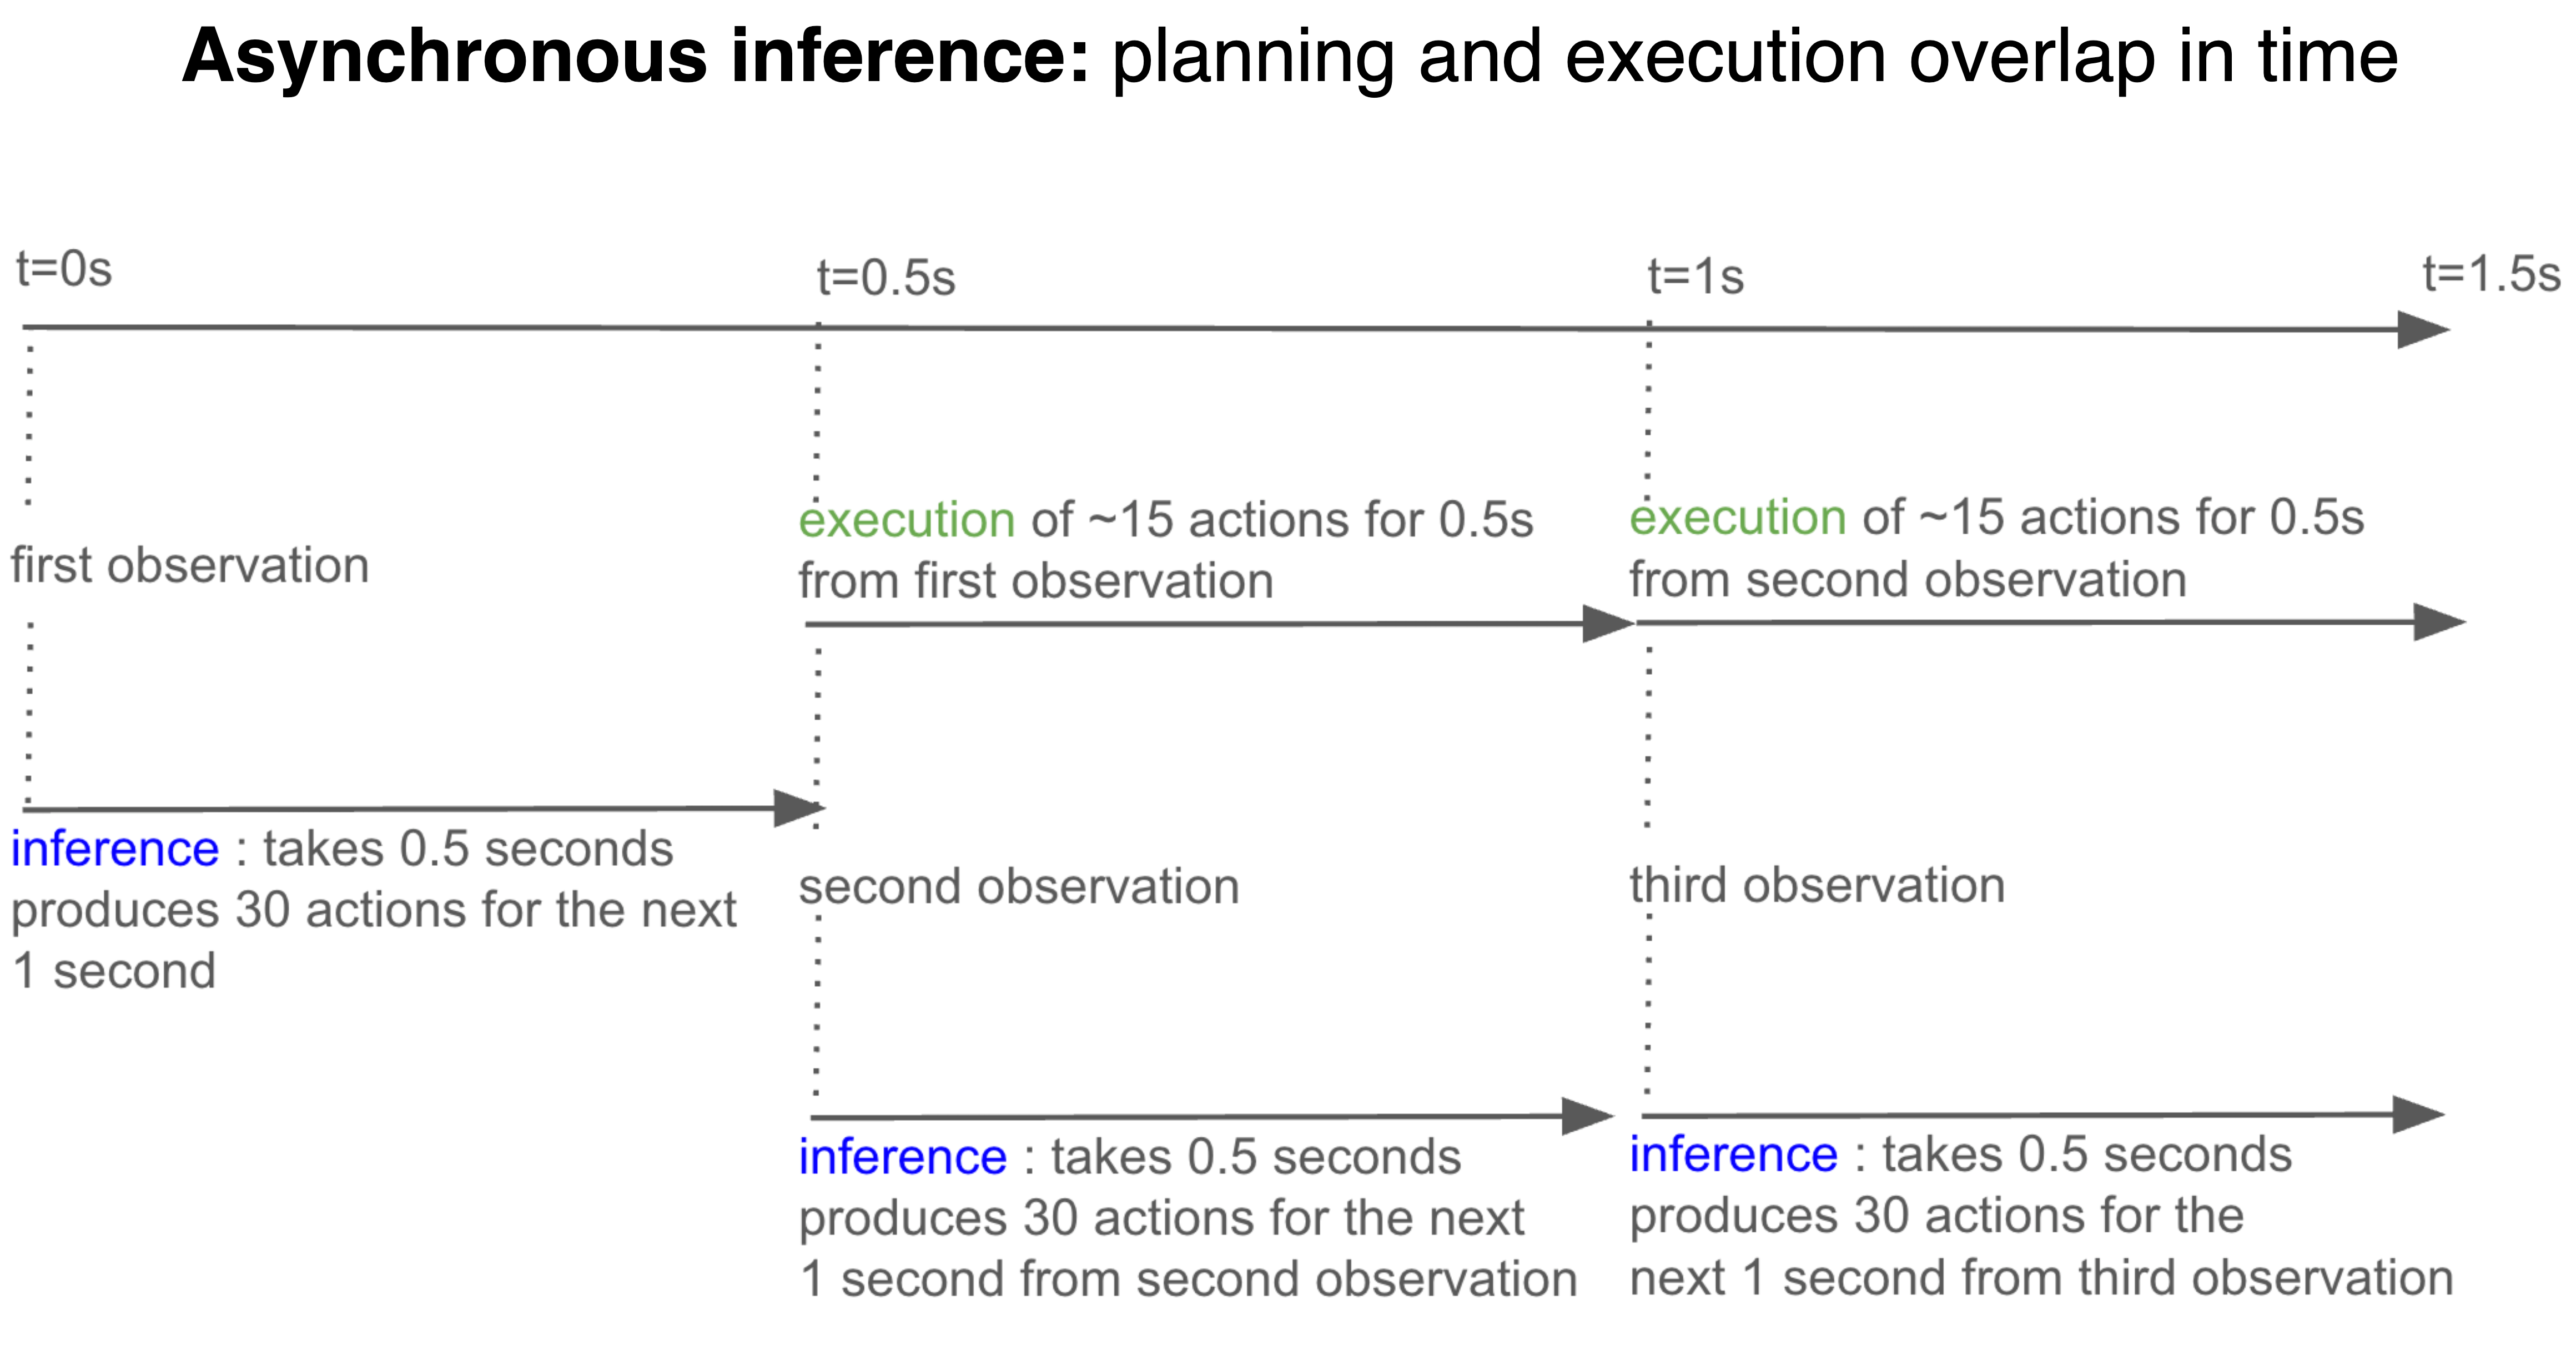
将动作预测与动作执行解耦,动作块推理可以在独立的机器上运行,而该机器通常配备比机器人机载资源更好的计算资源。在异步推理中,机器人客户端将时刻t的观测o发送给策略服务器,并在推理 完成后通过网络接收一个动作块$A_t$。
Generalist Robot Policies
能不能像训练大语言模型一样,先训练一个有广泛能力的模型,再让它适应不同任务、场景和机器人?大规模预训练 → 用少量目标任务数据微调。但机器人比 LLM 多一道困难:数据和“身体”(embodiment)绑在一起。文本可以由不同的人写,却共用一套文字表达;机器人数据里,同样一个动作向量,在六轴机械臂和双臂机器人上可能根本不是一个意思。摄像头位置、关节数量、动作单位也可能不同。
Vision-Language-Action,VLA。借用了预训练 VLM 已有的视觉和语言知识。 | 模型 | 输入 | 输出 | |—|—|—| | VLM | 桌面图片+“红杯子在哪里?” | “在盒子左边” | | VLA | 桌面图片+“把红杯子放进盒子”+机器人状态 | 一段机器人动作 |
VLA利用 VLM 已经学到的视觉和语言知识,再通过机器人数据学会把这些知识落实为动作。 \(A_t \sim p_\theta(A_t\mid I_t,q_t,\ell)\)
其中:
- $I_t$:相机画面。
- $q_t$:关节位置等机器人自身状态。
- $\ell$:语言/任务指令。
- $A_t=(a_t,\ldots,a_{t+H-1})$:未来一段动作,而不是一个文字答案。
LLM 输出词表里的 token,机器人究竟输出什么?如何把大模型的表示能力连接到机器人的动作空间?
- 把连续动作离散化,变成 token。例如,把某个动作分量的数值范围切成 256 档,模型预测该选哪一档。这样就能借用分类、token 预测的训练方式。RT-2、OpenVLA 是这条路线的代表。
- 保留连续动作,用专门的生成模型输出。
- VLM Backbone:处理图像和语言,提供场景与任务的表示。
- Action Expert:结合这些表示、机器人状态,用 Flow Matching 生成动作块。 但它不必先写出一段文字计划,再交给另一个模型翻译成动作。两个部分通过 Attention 在内部特征层面交换信息。
一轮推理大概是
context = vlm.encode(images, instruction)
action_chunk = action_expert.generate(context, robot_state)
robot.execute(action_chunk[:execute_steps])
# 获取新观测,继续下一轮
本体信息远比“关节数量 + 电机型号”复杂。相同的零件,用不同方式组装,就会形成不同的身体,也需要不同的控制方式。一个关节角度向量:$q=[0.2,\,-0.5,\,0.8,\ldots]$ 脱离身体结构和关节顺序约定,并不能唯一说明机器人摆出了什么姿势。 同一组数,放在狗型与人型机器人上,可能对应完全不同的姿态。
机器人领域 URDF是一种描述身体结构的格式:用 link 表示刚性部件,用 joint 描述连接关系,并记录几何、惯性等属性。
可以把一个通用策略写成: \(A_t\sim p_\theta \left( A_t\mid \text{图像},\text{指令},\text{当前状态},\text{本体信息} \right)\)
留下评论